이름을 고르게: 바꿔 쓰기
이제 Tim 을 고친다. 루나가 이야기 속 이름을 프리트레인에서 가져오는 것은 대화가 이름을 가르치지 않았기 때문이었다. 그러니 이름이 나오는 이야기 대화를 넣어 주면 된다. 그런데 그 이야기도 어디선가 가져와야 하고, 가져온 이야기에는 가져온 곳의 쏠림이 따라온다.
이름 들어간 이야기는 타이니스토리즈에 이백만 편이 넘는데… 거기서 꺼내 오면 Tim 도 같이 따라오겠지.

넷에 하나를 그대로 들여오는 거지.
옆에서 노트에 주문서 축을 적던 하은이 고개를 들었다.
이야기는 두고 이름만 돌리면요? 그 Ben 처럼, 이름은 이야기를 쓴 모델이 자주 고르는 걸로 채워진 거잖아요. 거북이 사실은 그대로 두고 장면이랑 쓰임을 돌렸던 것처럼, 이름도 축 하나로 보는 거예요.

하은 씨 말대로요. 이야기는 그대로 가져오고, 이름만 바꿔 써요. 「Tim 이 공원에 갔다」가 「Finn 이 공원에 갔다」가 돼도 이야기는 똑같이 말이 돼요. 이야기에 나온 이름을 모두, 같은 성별의 이름 60 개 가운데 고르게 뽑은 이름으로 바꾸는 거예요.
타이니스토리즈에서 120 낱말이 넘지 않고, 처음 나온 사람 이름이 이름 칸(여자아이 이름 30 개, 남자아이 이름 30 개) 안에 있는 이야기 1,500 편을 골랐다. 처음 나온 아이가 여자아이면 「Tell me a story about a little girl.」, 남자아이면 「Can you tell me a story about a boy?」처럼, 성별마다 열두 가지 물음 틀 가운데 하나를 붙여 대화로 만들었다. 루나에게 물을 물음과 글자가 같은 틀은 쓰지 않았다(sources/data-fix/prep_names.py).
# sources/data-fix/prep_names.py 에서
found = list(dict.fromkeys(w for w in WORD.findall(s) if w in ALL))   # 이야기에 나온 이름 칸의 이름
pool = {"girl": [x for x in GIRL if x not in found], "boy": [x for x in BOY if x not in found]}
mp = {}
for w in found:   # 같은 성별 안에서, 서로 겹치지 않게, 고르게 뽑는다
    k = "girl" if w in GIRL else "boy"
    mp[w] = pool[k].pop(rng.randrange(len(pool[k])))
t = re.sub(r"\b(" + "|".join(found) + r")\b", lambda m_: mp[m_.group()], s)
names_orig: 학습 대화 12,740(더한 이야기 1500), 서로 다른 주인공 이름 46, Tim 34.1%, Tom 13.9%, Lily 12.6%, Max 5.5%, Sue 5.4%, Mia 4.8%
names_swap: 학습 대화 12,740(더한 이야기 1500), 서로 다른 주인공 이름 59, Jake 3.8%, Freddy 2.7%, Ted 2.7%, Jim 2.7%, Jerry 2.5%, Fred 2.5%

예(그대로 → 바꿈):
  Q: I like stories. Tell me one about a girl.
  그대로: One day, a kind girl named Lily went to the park. She saw a swing and wanted to play on it. But when she got close, she saw a sad boy named Tim standing near the swing. Lily asked, "Why are you sad, T
  바꿈:   One day, a kind girl named Lucy went to the park. She saw a swing and wanted to play on it. But when she got close, she saw a sad boy named Sam standing near the swing. Lucy asked, "Why are you sad, S
판은 둘이다. 중복을 지운 루나 말투 대화에 이 이야기 대화 1,500 개를 이름 그대로 더한 판과, 이름을 바꿔 쓴 1,500 개를 더한 판이다. 이름 그대로 판에서 처음 나온 이름은 Tim 이 34.1% 로 타이니스토리즈보다 더 쏠렸고, 바꿔 쓴 판은 1등이 3.8% 다. 두 판은 이야기도 물음도 같고 이름만 다르니, 둘의 차이는 이름에서 온 것이다.
학습은 앞과 같다(시드 셋, 판마다 17초). 루나에게는 물음 다섯을 온도 1.0 으로 40 번씩 물었다(sources/data-fix/names_check.py). 셋은 앞 절에서 쓴 물음이고, 둘(「two friends who find a box」, 「a child who is scared of the dark」)은 성별도 말하지 않고 학습 물음 틀과 모양도 다른 새 물음이다.
Q3. Tell me a story about a kid at the park.
  dedup      Tim 39.3/37.0/25.0  다른 이름 12/14/14  (이름 나온 수 28/27/24)
  names_orig Tim 40.0/30.3/47.1  다른 이름 13/13/11  (이름 나온 수 30/33/34)
  names_swap Tim  0.0/ 2.9/ 5.7  다른 이름 24/28/23  (이름 나온 수 31/35/35)

Q4. Tell me a story about two friends who find a box.
  dedup      Tim 25.9/26.9/24.1  다른 이름 11/15/12  (이름 나온 수 27/26/29)
  names_orig Tim 28.6/33.3/19.4  다른 이름 18/14/12  (이름 나온 수 28/36/31)
  names_swap Tim  6.7/ 0.0/ 6.5  다른 이름 23/26/24  (이름 나온 수 30/32/31)
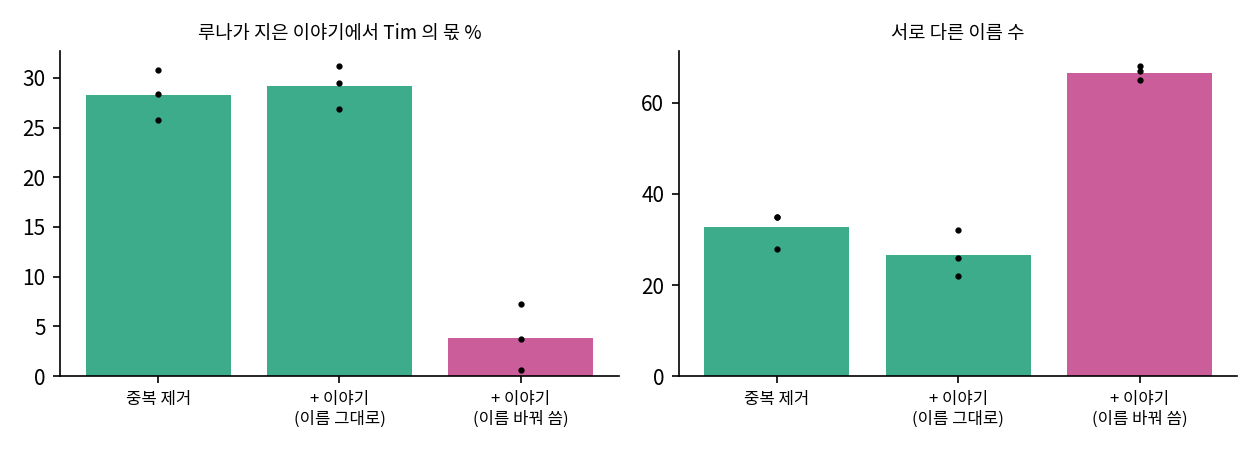
물음 다섯을 합치면, 이름을 바꿔 쓴 판에서 처음 나온 이름 가운데 Tim 의 비율은 시드 셋이 7.3%, 0.6%, 3.8% 였다. 중복 제거 판(28.3%, 30.8%, 25.7%)과 이름 그대로 판(29.5%, 31.1%, 26.8%)에서는 넷에 하나 넘게 Tim 이었다. 서로 다른 이름은 22~35 개에서 65~68 개로 늘었다. 학습 물음 틀에 없던 새 물음 둘에서도 같은 쪽으로 움직였으니, 루나가 배운 것은 물음 틀이 아니라 「이야기 속 아이의 이름은 여럿 가운데 하나」다.
[dedup] Q: Tell me a short story about a girl.
  루나: Once a girl had a red ball. She kicked the ball. The ball went up. It came down. A dog ran to the ball. The dog brought it back. The girl was happy.
[names_swap] Q: Can you tell me a story about a boy and his dog?
  루나: Once upon a time, there was a little boy named Freddy. Freddy loved to play outside. One day, he went to the park with his mom. At the park, Freddy saw a big tree. He wanted to climb it. …

Freddy 래. 이야기는 멀쩡하네.

여자아이 이야기를 해 달라면 여자아이 이름을 써?
그것도 측정했어요. 「a girl」, 「a boy and his dog」 물음에서 이름 칸 안의 이름이 물음의 성별과 맞은 비율이 중복 제거 판은 39~67% 였는데, 이야기 대화를 더한 두 판은 75~97% 예요. 이건 성별을 말한 물음에 맞는 이야기를 붙여 준 덕이에요. 이름 그대로 판도 똑같이 올랐거든요. 이름을 바꿀 때 성별을 지켰으니 그 효과도 그대로 남았고요.
치른 값도 있다. 이야기 대화 1,500 개가 배치에 섞인 만큼, 루나 말투 개발 대화의 답 손실은 그대로 판보다 0.009~0.018(중복 제거 판보다 0.011~0.014) 늘었다. 이름 그대로 판도 같은 만큼 늘었으니 이름을 바꾼 값은 아니다. 시험지 v1 의 다섯 칸과 바이트당 비트는 중복 제거 판과 갈리지 않았다(sources/data-fix/summary.out).
이 방법은 2018년 카이지 루와 동료들이 이름 붙인 반사실 데이터 늘리기(counterfactual data augmentation)에서 왔다. 그들은 언어 모델이 직업과 성별을 엮는 쏠림을 줄이려고, 학습 글을 복사해 he 를 she 로, she 를 he 로 바꾼 사본을 더했다. 2019년 로언 홀 모즐리와 동료들은 사본을 더하는 대신 글의 일부를 바꿔 쓰고, 바꾸는 낱말을 성별 낱말에서 사람 이름까지 넓혔다. 우리가 한 것은 그 이름 바꾸기를 이야기 속 아이 이름에 쓴 것이다.
데이터 판의 쏠림 가운데에는 이렇게 고칠 수 없는 것도 있었다. 루나 말투 산수 대화의 답은 two~five 에 86% 가 몰려 있어(sources/data-fix/bias.out) 루나가 답이 여섯 넘는 덧셈을 못 맞히는데, 답이 six~ten 인 산수 대화를 새로 만들어 비율을 맞춰도 정답은 거의 늘지 않았다. 덧셈과 뺄셈은 답의 비율로 고쳐지지 않아서, 산수는 따로 가르치기로 했다.