동화 쓰는 작은 GPT: 게이밍 GPU 한 장으로 17분
이 장의 물음
100초 학습한 GPT 의 샘플을 보던 서연이 「Bounce 의 친구 Bounce」에 밑줄을 그었다. 민준은 노트북에서 GPTConfig 의 숫자를 고치고 있었다.
층을 넷에서 여덟로, 폭을 256 에서 512 로. 문맥도 512 토큰. 학습은 학습 글을 거의 한 바퀴 다 읽을 때까지.

그럼 얼마나 걸려? 오늘 안에 끝나?

내 게이밍 GPU 로 돌리면 이십 분 안쪽일 거야. 여기서 접속해서 걸어 둘게.

그런데 그렇게 키운다고 정말 말이 될까? 웹에 있는 글을 다 읽은 모델들은 이것보다 몇 천 배 크잖아.
이 장이 끝나면 루나는 RTX 4090 한 장에서 17.4분 학습한 파라미터 2,760만 개짜리 GPT 가 되어, 바이트당 비트 0.4253 으로 앞뒤가 맞는 짧은 동화를 쓴다.
웹 글을 읽은 언어 모델이 매끄러운 글을 쓰려면 파라미터가 수억, 수십억 개 필요하다고 알려져 있다. 그런데 우리 데이터는 웹 글이 아니라, 서너 살 아이가 알아듣는 낱말로만 쓴 짧은 동화다. 읽을 글이 좁으면 모델도 작아도 될까? 된다면 얼마나 작아도 되고, 그 모델이 쓰는 글은 어디까지 「말이 된다」고 할 수 있을까?
이 장은 다음 물음에 차례로 답한다.
- 타이니스토리즈는 웹 글과 비교해 얼마나 좁은 글이고, 그 좁음이 왜 작은 모델에 유리할까?
- 2,760만 개짜리 GPT 를 게이밍 GPU 한 장으로 학습하면 손실은 어떻게 내려가고, 무엇이 시간을 정할까?
- 학습 중의 루나는 무엇부터 배울까? 처음 보는 이름을 넣으면 어떻게 될까?
타이니스토리즈: 서너 살이 알아듣는 낱말로만 쓴 이야기
지금까지 루나가 읽은 글은 모두 타이니스토리즈(TinyStories)였다. 그동안은 「동화 데이터」라고만 불렀는데, 모델을 키우기 전에 이 데이터가 어떤 글인지 따져 볼 필요가 있다. 같은 크기의 모델이라도 무엇을 읽히느냐에 따라 「말이 된다」의 기준이 달라지기 때문이다.
역사: 작은 모델은 왜 영어를 못 하나
2023년 엘단(Ronen Eldan)과 리(Yuanzhi Li)는 「TinyStories: How Small Can Language Models Be and Still Speak Coherent English?」라는 논문을 냈다. 출발점은 흔히 겪는 실패였다. 논문 초록은 파라미터 1억 2,500만 개 안팎의 GPT-Neo(small)나 GPT-2(small) 같은 모델이 오래 학습해도 몇 낱말을 넘어서는 조리 있는 영어를 거의 만들지 못한다고 적었다. 그렇다면 매끄러운 영어는 파라미터가 수억 개를 넘고 층이 많은 큰 모델에서만 나오는 능력일까?
두 사람은 모델을 키우는 대신 읽힐 글을 좁혔다. GPT-3.5 와 GPT-4 에게 서너 살 아이가 보통 알아듣는 낱말만 써서 짧은 이야기를 쓰게 하고, 그 이야기들로 작은 모델을 학습했다. 결과는 초록의 말로 「파라미터 1,000만 개 미만이거나 트랜스포머 블록이 하나뿐인 모델도 여러 문단의 매끄럽고 앞뒤가 맞는 이야기를 거의 완벽한 문법으로 쓴다」였다. 모델이 쓴 이야기는 GPT-4 에게 선생님이 학생 글을 채점하듯 문법, 창의성, 일관성 따위로 점수를 매기게 해서 평가했다.
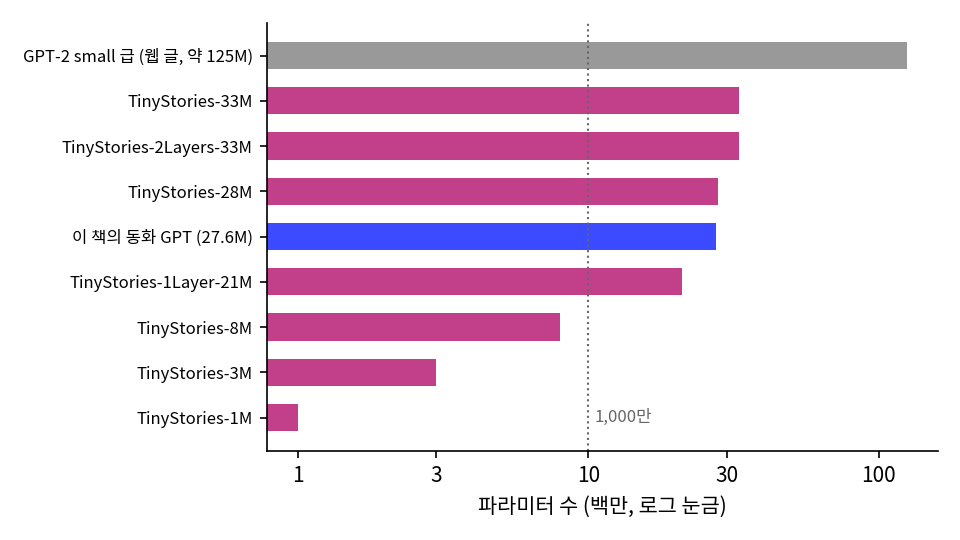
저자들은 1M, 3M, 8M, 28M, 33M 과 블록 하나짜리 21M 등의 모델을 공개했다. 우리 동화 GPT 의 2,760만 개는 그 가운데 28M 과 비슷한 크기다. 데이터 카드가 GPT-3.5 가 쓴 글이 섞인 첫 판을 「품질이 낮다」고 적었기 때문에, 이 책은 그들의 데이터 가운데 GPT-4 만 쓴 둘째 판(V2)을 쓴다.
데이터 한 편과 낱말의 폭
검증 파일에서 첫 온전한 이야기를 그대로 옮기면 다음과 같다(sources/tinystories/data_stats.out 4절).
Once upon a time, in a warm and sunny place, there was a big pit. A little boy named Tom liked to play near the pit. One day, Tom lost his red ball. He was very sad.
Tom asked his friend, Sam, to help him search for the ball. They looked high and low, but they could not find the ball. Tom said, "I think my ball fell into the pit."
Sam and Tom went close to the pit. They were scared, but they wanted to find the red ball. They looked into the pit, but it was too dark to see. Tom said, "We must go in and search for my ball."
They went into the pit to search. It was dark and scary. They could not find the ball. They tried to get out, but the pit was too deep. Tom and Sam were stuck in the pit. They called for help, but no one could hear them. They were sad and scared, and they never got out of the pit.
(타이니스토리즈 V2 검증 파일, roneneldan/TinyStories, CDLA-Sharing-1.0. GPT-4 가 쓴 합성 글이다.) 문장은 짧고, 낱말은 쉽고, 「Once upon a time」으로 시작해 한 사건으로 끝난다. 끝이 해피엔딩이 아닌 이야기도 섞여 있다.
이 글이 얼마나 좁은지는 낱말을 세 보면 드러난다. 타이니스토리즈 검증 글과 웹 글(nanochat 이 받아 둔 ClimbMix 검증 조각, 원문은 싣지 않는다)을 앞 2,000만 바이트씩 읽어 영문자 낱말을 소문자로 셌다.
## 1. 낱말 폭 (앞 20,000,000 바이트씩, 영문자 줄을 소문자로)
  타이니스토리즈 검증 글: 낱말 3,955,748 개, 서로 다른 낱말 9,351 개, 가장 흔한 1,000 개가 92.7%, 5,000 개가 99.7%
  웹 글(ClimbMix 검증 조각): 낱말 3,294,745 개, 서로 다른 낱말 73,449 개, 가장 흔한 1,000 개가 68.1%, 5,000 개가 86.9%
같은 바이트 수에서 서로 다른 낱말이 웹 글은 73,449 개, 타이니스토리즈는 9,351 개로 8분의 1 이 안 된다. 타이니스토리즈에서는 가장 흔한 낱말 1,000 개가 등장의 92.7% 를 덮고, 5,000 개면 99.7% 다. 이야기의 형태도 좁다. 학습 글 2,717,495 편 가운데 1,622,377 편(59.70%)이 「Once upon a time」으로 시작하고, 이름 Tim 은 22.77%, Lily 는 13.75% 의 이야기에 나온다(data_stats.out 2절).
ML에서: 좁은 분포에는 작은 모델로 충분하다
언어 모델이 배우는 것은 「이 앞 글 다음에 무엇이 올까」의 확률분포다. 쓰이는 낱말이 적고 이야기의 형태가 몇 가지로 정해져 있으면, 맞혀야 할 분포 자체가 단순하다. 웹 글을 잘 맞히려면 과학, 법, 요리, 코드 같은 서로 다른 글의 규칙을 모두 담아야 하지만, 동화를 잘 맞히려면 동화의 규칙만 담으면 된다. 작은 모델이 웹 글에서 몇 낱말밖에 잇지 못하는 것은 파라미터가 모자라서 모든 규칙을 조금씩만 배우기 때문이고, 같은 파라미터를 동화의 규칙에만 쓰면 이야기 한 편을 끝까지 쓸 수 있다는 것이 엘단과 리의 실험이 보여 준 것이다.
대가도 분명해서, 좁은 글로 학습한 모델은 좁은 글만 쓴다. 「별빛 정거장」의 관제 AI 처럼 별과 궤도를 이야기하려면 그런 낱말이 든 글을 읽혀야 하는데, 그 글은 타이니스토리즈의 낱말 9,351 개 밖에 있다.
문제 1. 낱말 1,000 개만 아는 독자
가장 흔한 영어 낱말 1,000 개만 아는 독자가 있다. 위의 낱말 폭 표를 쓰면, 이 독자가 낱말 100 개짜리 글을 읽을 때 모르는 낱말은 타이니스토리즈에서 몇 개, 웹 글에서 몇 개쯤 나오는가? 한 문장이 낱말 열 개라면, 문장마다 모르는 낱말이 하나 이상 섞일 일은 어느 글에서 흔한가? 두 글의 「흔한 1,000 개」는 서로 다른 목록이라는 점은 무시한다.
100 개 가운데 타이니스토리즈는 100 − 92.7 = 7.3 개, 웹 글은 31.9 개요.
문장 열 낱말이면 타이니스토리즈는 모르는 게 평균 0.73 개, 웹 글은 3.19 개네. 웹 글은 거의 모든 문장에 모르는 낱말이 들어 있는 거야.

낱말마다 모를 확률이 따로따로라고 치면, 열 낱말 문장에 모르는 낱말이 하나도 없을 확률은요?
타이니스토리즈는 0.927¹⁰ 이니까… 0.47 쯤, 웹 글은 0.681¹⁰ 이 0.02 쯤이요. 웹 글은 쉰 문장에 한 문장만 다 아는 낱말이에요.
낱말마다 따로따로라고 친 건 거친 가정인데, 그래도 결론이 바뀔까요?
차이가 0.47 대 0.02 면 가정이 좀 틀려도 안 뒤집히겠어요. 1,000 낱말 독자에게 동화는 절반쯤 술술 읽히고 웹 글은 거의 못 읽어요. 작은 모델도 아는 낱말이 적은 독자랑 비슷하겠네요. 읽을 글이 그 낱말 안에 들어오면 작은 모델로도 글 전체를 다룰 수 있고요.