동화 쓰는 작은 GPT: 게이밍 GPU 한 장으로 17분
17분 학습: 2,760만 파라미터에 4억 5,875만 토큰
100초 학습한 작은 GPT 는 손실이 마지막까지 내려가는 중이었고 학습 글의 12% 가 못 되는 양만 읽었다. 이번에는 모델을 키우고, 학습 글을 거의 한 바퀴 읽힌다. 바꾼 숫자는 층 수(4 → 8), 헤드 수(4 → 8), 폭(256 → 512), 문맥 길이(256 → 512), 스텝당 토큰(16,384 → 32,768)이고, 코드는 같은 GPT 클래스와 같은 학습 루프다.
# sources/tinystories/train_tinystories.py 에서 발췌
B, BS = 64, 512
cfg = GPTConfig(vocab_size=tok.vocab_size, block_size=BS, n_layer=8, n_head=8, n_embd=512)
m = GPT(cfg).to(dev)
h = T.train(m, tr, va, tb, batch_size=B, block_size=BS, max_steps=args.steps, lr=1e-3, warmup=200,
            weight_decay=0.1, grad_clip=1.0, eval_every=500, log_every=250, device=dev, compile=True,
            eval_tokens=2_000_000, on_step=on_step)
compile=True 는 파이토치의 torch.compile 로 모델의 계산을 한 번 묶어 최적화해 두라는 뜻이고, 학습 루프는 처음부터 bf16(16비트 부동소수점) 자동 혼합 정밀도로 계산한다. 학습률은 최대 1e-3, 처음 200 스텝 워밍업 뒤 코사인으로 줄인다. 정해 둔 스텝(0, 50, 200, 500, 1,000, 2,000, 5,000, 끝)마다 체크포인트를 남기고 같은 씨앗으로 샘플을 뽑게 했다.
학습 토큰 552,651,810, 검증 토큰 5,579,565
파라미터 27,579,392 개 (임베딩 둘 2,359,296, 나머지 25,220,096)
계획: 14,000 스텝 x 32,768 토큰 = 458,752,000 토큰 (학습 토큰의 0.83 바퀴)
eval step      0 | tokens 0 | val_loss 8.3729 | val_bpb 3.0399 | 0s
eval step    500 | tokens 16,384,000 | val_loss 2.1426 | val_bpb 0.7803 | 45s
eval step   1000 | tokens 32,768,000 | val_loss 1.7756 | val_bpb 0.6466 | 84s
eval step   2000 | tokens 65,536,000 | val_loss 1.5616 | val_bpb 0.5687 | 159s
eval step   5000 | tokens 163,840,000 | val_loss 1.3630 | val_bpb 0.4964 | 380s
eval step  10000 | tokens 327,680,000 | val_loss 1.2201 | val_bpb 0.4442 | 747s
eval step  14000 | tokens 458,752,000 | val_loss 1.1697 | val_bpb 0.4259 | 1042s

검증 글 전체(5,579,565 토큰): 손실 1.1685, 바이트당 비트 0.4253, 퍼플렉서티(토큰당) 3.22
학습 시간 1044초 (17.4분), 평균 439,318 토큰/초
(sources/tinystories/train_tinystories.out, 평가는 500 스텝마다 찍히는데 몇 줄만 옮겼다.) 파라미터는 27,579,392 개로 작은 GPT 의 6.5배이고, 학습 토큰은 4억 5,875만 개로 7배다. RTX 4090 한 장에서 학습은 1,044초, 17.4분 걸렸다. 검증 글 전체의 바이트당 비트는 0.4253 으로, 100초 학습한 작은 GPT 의 0.6129 보다 바이트마다 0.19 비트를 덜 쓴다.
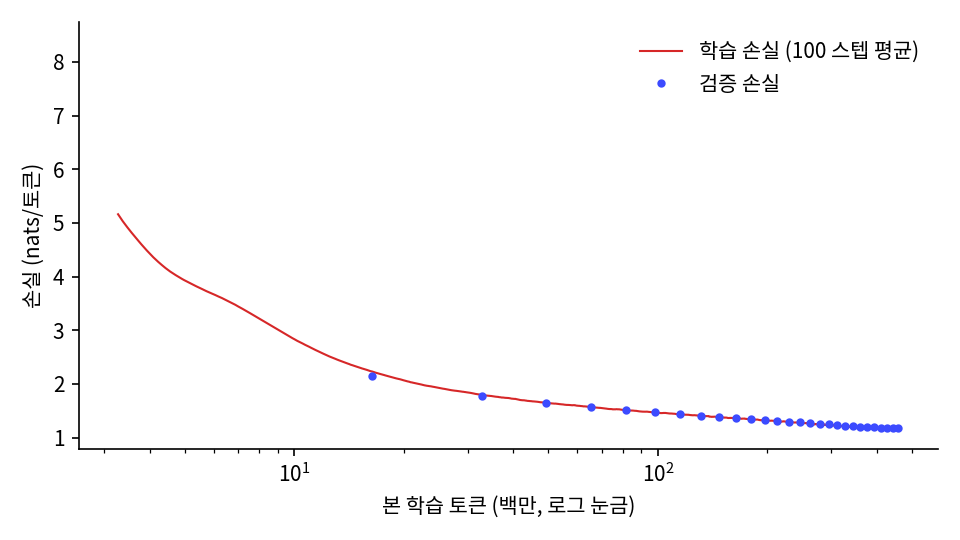
손실의 대부분은 처음 몇백 스텝에 빠진다. 스텝 500(1,638만 토큰)에서 이미 바이트당 비트 0.7803 으로 MLP 언어 모델이 4,000 스텝 뒤에 닿은 0.9326 보다 낮고, 나머지 13,500 스텝은 0.78 을 0.43 으로 깎는 데 쓴다. 학습 손실과 검증 손실이 끝까지 붙어 있는 것은 학습 글을 한 바퀴도 다 읽지 않았으니 같은 이야기를 두 번 본 적이 거의 없기 때문이다.
문제 2. 같은 토큰을 읽었을 때 큰 모델과 작은 모델
두 GPT 의 학습 기록에서 같은 토큰 수를 읽은 자리의 검증 바이트당 비트(검증 글 앞 200만 토큰)를 비교한다. 작은 GPT(4.27M)는 3,277만 토큰에서 0.6853, 6,554만 토큰에서 0.6140 이었다. 동화 GPT(27.6M)는 같은 토큰 수에서 몇이었나? 작은 GPT 가 100초 학습한 것과 비슷한 시간을 학습한 동화 GPT 는 어디까지 갔나? 큰 모델은 작은 모델보다 한 토큰을 읽는 데 시간이 더 드는데, 같은 시간을 주면 누가 나은가?

기록을 열어 볼게요. 동화 GPT 는 3,277만 토큰이 스텝 1,000 이라서 0.6466, 6,554만 토큰이 스텝 2,000 이라서 0.5687 이에요. 같은 글을 읽고도 큰 모델이 0.04~0.05 비트 낮아요.

같은 글에서 더 많이 배운다는 거네. 그래도 같은 시간이면 작은 모델이 크게 이길 거야. 파라미터가 6.5배면 한 스텝 계산도 6.5배니까, 100초 동안 작은 모델이 스텝을 6.5배 더 했을 거고.
동화 GPT 의 평가 시각이 스텝 1,000 에 84초, 1,500 에 120초라서 100초는 그 사이야. 바이트당 비트가 0.6466 에서 0.5980 으로 내려가는 구간이니까, 100초 자리를 직선으로 이으면 스텝 1,200 쯤에 0.625 쯤이야. 작은 GPT 의 0.6140 보다 조금 높지만 크게 지지는 않았고, 120초면 앞서. 스텝 수는 4,000 대 1,200 이라 세 배 정도 차이고.
세 배 정도? 6.5배가 아니고? 게다가 스텝당 토큰도 동화 GPT 가 두 배니까, 토큰으로 치면 차이가 더 작아지는데…

두 학습의 토큰 처리 속도로 바로 비교해 볼까요?
작은 GPT 는 초당 64만~70만 토큰, 동화 GPT 는 평균 439,318 토큰이요. 1.5배 느릴 뿐이에요.
작은 모델은 RTX 4090 에게 일이 너무 작아서 계산 말고 다른 데서 시간을 쓰는 것 같아. 동화 GPT 는 torch.compile 이랑 bf16 도 켰고.
그래요. 같은 토큰을 읽으면 큰 모델이 더 배우고, 이 크기에서는 GPU 가 놀던 만큼을 큰 모델이 채워서 시간당으로도 손해가 거의 없었어요. 모델을 끝없이 키우면 언젠가는 시간이 파라미터에 비례해 늘겠지요. 그 경계를 어떻게 찾는지는 모델을 크게 키울 때 다시 다뤄요.
문제 3. 손실 하나를 세 가지로 읽기
마지막 줄의 검증 손실 1.1685(토큰당 nat), 바이트당 비트 0.4253, 퍼플렉서티 3.22 는 같은 검증 글에서 나온 숫자다. (가) 퍼플렉서티 3.22 는 손실에서 어떻게 나오고, 무엇을 뜻하는가? (나) 손실과 바이트당 비트만으로 「토큰 하나가 평균 몇 바이트인가」를 구하라. (다) 그 토큰당 바이트를 검증 글 전체의 바이트 수 22,132,376 과 토큰 수 5,579,565 로 확인하라.
(가)는 e^1.1685 예요. 계산하면 3.217 이라 3.22 고, 루나가 토큰마다 평균적으로 후보 세 개쯤 사이에서 망설이는 것만큼 놀란다는 뜻이고요.
(나)는 바이트당 비트가 「토큰당 nat ÷ ln 2 ÷ 토큰당 바이트」니까, 토큰당 바이트 = 1.1685 ÷ 0.6931 ÷ 0.4253 = 3.96 바이트요.
(다)로 확인해 볼까요?
22,132,376 ÷ 5,579,565 = 3.97 바이트. 맞아요.
손실은 토큰 단위라 토크나이저를 바꾸면 달라지는데, 바이트당 비트는 그 3.96 으로 나눠서 토크나이저와 상관없게 만든 거네요.
그래요. 다른 토크나이저를 쓰는 모델과 비교할 때는 바이트당 비트를 써요.