신경망을 학습시키는 것은 수백만, 수억 개의 파라미터로 이루어진 공간에서 손실 함수의 최솟값을 찾아 걸어가는 일이다. 가장 기본적인 전략인 경사하강법은 파라미터를 다음과 같이 업데이트한다.
θ←θ−η∂θ∂LθLη파라미터 (파라미터공간의좌표)손실함수학습률
그래디언트(가장 가파르게 올라가는 방향의 벡터)의 반대 방향이 "가장 가파르게 내려가는 방향"이니 그 방향으로 걸으면 된다. 간단해 보인다.
하지만 모델을 짤 때마다 고르는 것이 하나 있다. 정규분포의 평균 μ와 표준편차 σ를 학습한다고 하자. σ를 그대로 파라미터로 둘 수도 있고, 로그를 씌운 logσ를 파라미터로 둘 수도 있다. 실제 코드는 뒤쪽을 자주 고른다. 변분 오토인코더(VAE, 데이터를 정규분포 꼴의 잠재 변수로 눌렀다가 되살리는 생성 모델)의 PyTorch 예제 코드에서 인코더는 분산 대신 로그 분산을 내놓는다. 둘은 같은 모델이고 같은 손실이다. 그런데 평균 2, 분산 1인 데이터에 맞추며 σ=0.5에서 같은 학습률로 한 스텝을 업데이트하면, σ 좌표로 계산한 스텝이 logσ 좌표로 계산한 스텝보다 σ를 네 배 더 움직인다. 이렇게 같은 모델을 다른 파라미터로 다시 나타내는 것을 재파라미터화(reparameterize. VAE의 재파라미터화 트릭과는 이름만 같다)라 하고, 새 파라미터를 φ=f(θ)처럼 적는다. 같은 모델, 같은 손실 함수인데 파라미터를 σ에서 logσ로 바꿔 부르기만 했을 뿐인데도 스텝이 달라지고, 스텝이 쌓이면 학습 경로가 달라진다.
파라미터 이름만 바꿨는데 학습 경로가 달라진다는 것은 심각한 문제다. 물리 법칙이 좌표계에 의존하면 안 되듯이, 학습 알고리즘이 파라미터의 이름에 의존해서는 안 된다. 좌표에 의존하지 않는 "진짜 가장 가파른 내리막 방향(최급강하 방향)"이 존재하는가? 존재한다면 어떻게 계산하는가?
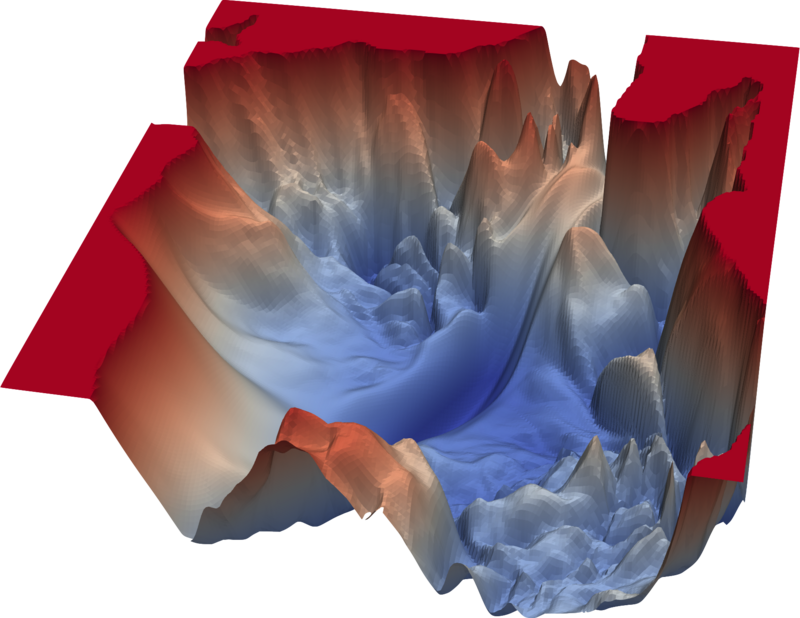
신경망의 손실 풍경(loss landscape) 3차원 시각화. 파라미터 공간에서 손실 함수가 만드는 복잡한 지형 (Li et al., 2018)
좌표에 의존하지 않는 최급강하 방향이 있느냐는 질문의 답은, 이 책 전체를 관통하는 주제인 「파라미터 공간을 매니폴드(좁게 보면 평평해 보이는 휘어진 공간)로 보는 관점」에서 자연스럽게 나온다.
피셔 정보행렬: 분포 공간의 계량
출발 문제는 좌표에 의존하지 않는 "진짜 최급강하 방향"이 있느냐고 물었다. 그 답을 찾기 전에, "가장 가파르다"는 말이 애초에 무엇에 기대고 있는지부터 따져 보자.
보통의 경사하강법에서 "가장 가파른 방향"은 유클리드 내적으로 정의된다. 한 스텝 δθ(θ의 작은 변화)의 크기를 정해 두고, 곧 작은 수 ϵ에 대해 ∥δθ∥2=∑i(δθi)2≤ϵ2 제약 아래 L(θ+δθ)를 가장 많이 줄이는 δθ의 방향이 그래디언트의 반대 방향이다. 하지만 이 유클리드 내적은 파라미터 공간이 평평하고, 모든 방향의 눈금이 같다고 가정한 것이다.
파라미터 공간이 계량(점마다 거리와 각도를 재는 자)이 주어진 매니폴드인 리만 매니폴드라면 "가장 가파른 방향"은 계량에 의존한다. 스텝의 크기를 계량으로 재어 gijδθiδθj≤ϵ2 제약 아래 최적화하면(제약을 지키며 최솟값을 찾는 표준 방법인 라그랑주 승수법 한 줄이면 된다) 최급강하 방향은 다음과 같다.
그래디언트에 계량의 역행렬을 곱해야 하는 것이다. 편미분 ∂L/∂θj는 화살표 하나를 넣으면 손실이 얼마나 변하는지를 돌려주는 여접벡터(1-형식)다(그래서 첨자가 아래에 붙는다). 실제로 움직일 것은 접선벡터(화살표)다(첨자가 위에 붙는다). 여접벡터를 접선벡터로 바꿔 주는 것이 계량의 역행렬 gij이다.
그러면 파라미터 공간에서는 어떤 계량을 써야 할까?
역사: 파라미터 이름을 바꿔도 같은 사전확률
파라미터 공간의 계량이 될 양은 피셔가 1925년 「통계적 추정의 이론」에서 데이터가 지닌 정보의 양으로 세운 것이고(정보기하학 쪽 이야기는 『정보기하학』 9장), 라오가 1945년 이를 분포 사이 거리의 계량으로 썼다. 그 양으로 좌표를 바꿔도 변하지 않는 사전확률을 만든 사람은 케임브리지의 해럴드 제프리스(Harold Jeffreys, 1891–1989)였다. 베이즈 추정에서는 데이터를 보기 전에 파라미터에 사전확률을 주어야 하는데, 아무것도 모르니 고르게 주자는 방법은 파라미터를 어떻게 적느냐에 따라 답이 달라졌다. 퍼짐을 σ로 적느냐 σ2으로 적느냐, 동전을 앞면 확률 p로 적느냐 로짓 log1−pp로 적느냐에 따라 「고르게」가 서로 다른 분포가 되는 것이다.
제프리스는 1946년 『왕립학회보 A』의 논문 「추정 문제에서 사전확률의 불변 형식」에서, 분포가 파라미터로 미분 가능하면 파라미터의 어떤 변환에도 변하지 않는 형식이 있음을 보이고 사전확률을 정하는 일반 규칙으로 내놓았다. 그 밀도는 피셔 정보행렬(아래에서 정의한다) 행렬식의 제곱근에 비례하고, 동전이면 1/p(1−p)에 비례한다.
동전의 앞면 확률 p 축(왼쪽)과 로짓 축(오른쪽)에 그린 사전분포. 위: p에서 고르게 준 분포를 로짓 축으로 옮기면 가운데가 불룩해지고, 로짓에서 고르게 다시 정하면(점선) 음영 구간의 확률이 0.09에서 0.20으로 바뀐다. 아래: 제프리스 규칙(√피셔 정보)은 p 축에서 정하든 로짓 축에서 정하든 같은 분포라서 p가 0.9와 0.99 사이인 음영 구간의 확률이 두 축에서 모두 0.141이다. 계산: sources/ch12/jeffreys_coin.py
바로 아래에서 계량에 거는 요구, 곧 「좌표가 얼마나 움직였나」가 아니라 「분포가 얼마나 바뀌었나」를 재라는 요구를 제프리스는 사전확률에 걸었다.
김민준
아무것도 모르면 고르게 주는 게 제일 공평해 보이는데요. 코드로도 uniform(0, 1) 한 줄이고요.
선생님
그 한 줄로 뽑은 p를 로짓으로 바꾸면 로짓 축에서는 어떻게 보이죠? 그림 위 칸을 보세요.
이서연
가운데가 불룩해요. p 축에서는 공평했는데 로짓 축에서는 0 근처를 더 쳐주네요. 로짓에서 고르게 다시 정하면 음영 구간의 확률도 0.09에서 0.20으로 바뀌고요.
김민준
그럼 처음부터 로짓에서 고르게 주면 되잖아요.
선생님
그러면 이번에는 p 축에서 고르지 않아요. 둘 중 어느 좌표가 「진짜」인지 가를 근거가 있었을까요? 좌표와 상관없이 「고르게」를 말하려면 점마다 부피를 재는 자가 먼저 있어야 해요. 피셔의 정보량을 분포 사이 거리의 계량으로 읽은 라오의 논문이 나온 것도 제프리스의 논문보다 겨우 한 해 앞선 1945년이었어요.
이서연
음, 고르게 준다는 건 같은 부피에 같은 확률을 준다는 뜻이니까… p로 재느냐 로짓으로 재느냐에 따라 부피가 달라지면 「고르게」도 달라질 수밖에 없겠네요.
김민준
그래서 제프리스가 √피셔 정보를 그 자로 썼고, 어느 축에서 정해도 0.141이 나온 거구나.
이서연
그런데 피셔 정보는 좌표가 얼마나 움직였는지가 아니면 무엇이 얼마나 바뀌는 걸 재는 거예요?
평균을 똑같이 옮겨도 분포가 바뀌는 정도는 다르다
피셔의 「정보의 양」이 무엇을 재는지 숫자로 보자. 정규분포의 평균 μ를 0에서 0.5로 옮길 때, 표준편차가 σ=0.5로 좁은 분포라면 옮기기 전과 뒤의 두 곡선은 한눈에 갈리지만 σ=2로 넓은 분포라면 두 곡선이 거의 겹친다. 두 분포가 얼마나 다른지를 KL 발산(두 분포가 얼마나 다른지 한 방향으로 재는 양)으로 재면 표준편차가 같은 두 정규분포에서는 (Δμ)2/(2σ2)이라, 앞은 0.5, 뒤는 약 0.031로 열여섯 배 차이다. 파라미터로는 똑같이 0.5만큼 걸었는데, 분포로는 KL 발산이 열여섯 배 다른 이동이다. 파라미터 공간의 계량은 「좌표가 얼마나 움직였나」가 아니라 「분포가 얼마나 바뀌었나」를 재야 한다.
같은 평균 이동 0.5가 표준편차 0.5인 좁은 분포(위)에서는 두 곡선을 뚜렷이 가르고, 표준편차 2인 넓은 분포(아래)에서는 두 곡선이 거의 겹친다. 두 분포 사이의 KL 발산은 0.5 대 약 0.031이다
스코어의 평균이 0이므로 피셔 정보행렬은 스코어의 공분산이며, "파라미터의 작은 변화가 확률분포를 얼마나 바꾸는가"를 잰다. 위의 정규분포에서 평균 방향의 성분은 Fμμ=1/σ2이라 σ=0.5에서 4, σ=2에서 1/4로, 앞에서 본 열여섯 배가 그대로 나온다. 두 분포 사이의 KL 발산을 q=p 근방에서 2차까지 전개했을 때 나오는 계수가 바로 이 행렬이다. 피셔 행렬은 재파라미터화에 대해 계량 텐서(텐서는 좌표를 바꿀 때 성분이 정해진 규칙대로만 바뀌는 양으로, PyTorch의 tensor와는 이름만 같다)와 똑같은 규칙으로 변환되므로, 이 계량으로 보정한 그래디언트는 좌표에 의존하지 않는다.
피셔 정보행렬 (분포를 재는 자 / Fisher Information Matrix, Fij=E[∂θi∂logp∂θj∂logp]): 로그우도의 그래디언트(스코어)의 공분산 행렬. 파라미터 θ의 작은 변화가 확률분포를 얼마나 바꾸는지를 잰다. 피셔 행렬은 KL 발산(두 분포가 얼마나 다른지 한 방향으로 재는 양)의 헤시안(두 번 미분한 값의 행렬)과 같으며(Fij=∂θi∂θj∂2DKL(pθ∥pθ0)θ=θ0), 피셔 행렬이 KL 발산의 헤시안이라는 사실이 피셔 행렬을 통계적 매니폴드의 리만 계량으로 만드는 근거다.
ML에서: 잊지 않게 붙잡아 둘 파라미터 고르기
한 태스크를 배운 신경망에 새 태스크를 가르치면 앞의 태스크를 급격히 잊어버리는 일이 흔하다(파국적 망각, catastrophic forgetting). 커크패트릭(J. Kirkpatrick) 등이 2017년 PNAS에 발표한 EWC(Elastic Weight Consolidation)는 앞 태스크에서 구한 피셔 정보행렬의 대각 성분으로 각 파라미터의 "중요도"를 재고, 새 태스크를 배우는 동안 중요도가 큰 파라미터일수록 원래 값에서 멀어지지 못하게 페널티를 준다. 여기서 움직이는 것은 신경망의 파라미터이고, 피셔 정보가 크다는 것은 그 파라미터를 조금만 움직여도 앞 태스크의 출력 분포가 크게 바뀐다는 뜻이다.
문제 1: 강수확률 2%p는 언제 큰 변화일까
확인 두 예보관이 강수확률을 바꿨는데, A는 50%에서 52%로, B는 1%에서 3%로 올렸다. 100일 동안 실제로 비 온 날을 세어 예보가 바뀐 것을 가려낸다고 하자. 두 경우 각각 비 온 날 수의 기댓값은 며칠 달라지고, 비 온 날 수의 표준편차는 며칠인가? 어느 쪽 변화가 더 잘 드러나는가?
0~100% 강수확률 눈금 위에서 A는 50%에서 52%로, B는 1%에서 3%로 같은 2%p를 올렸다. 100일 동안 비 온 날을 세어 두 변화를 가려낸다
같이 풀기 세션 1
김민준
둘 다 2%p 올렸으니 비슷하겠죠. 굳이 고르면 A 쪽이 더 잘 보일 것 같아요. 반반일 때가 제일 불확실하니까 거기서 조금만 바뀌어도 티가 날 것 같거든요.
이서연
나는 비율로 봤어. 1%에서 3%는 세 배고 50%에서 52%는 1.04배니까, B 쪽 변화가 2.9배쯤 커.
선생님
두 사람 생각이 반대로 갈렸네요. 문제대로 100일을 세어 볼까요? 비 온 날은 며칠씩 달라지죠?
김민준
A는 50일에서 52일, B는 1일에서 3일이요. 둘 다 이틀이네요.
선생님
그 이틀이 비 온 날 수의 표준편차보다 큰가요?
이서연
이항분포의 표준편차는 100p(1−p)니까 A는 25=5일, B는 0.99≈1일이에요.
선생님
그럼 같은 이틀이 각 표준편차의 몇 배죠?
이서연
A의 이틀은 표준편차의 0.4배라 묻혀 버리고, B의 이틀은 표준편차의 2배라 바로 보여요. 0.4와 2면 다섯 배 차이네요. 제가 비율로 친 2.9배와도 달라요.
김민준
아, 반반일 때는 원래 들쭉날쭉이 커서 이틀쯤은 티가 안 나는구나. 조교님이 "평균이 1점 올라도 원래 점수가 들쭉날쭉하면 의미 없다"고 했던 게 이거네요. 오른 폭을 점수의 표준편차와 견줘 보라는 말이었어요.
선생님
같은 2%p라도 어디서 움직였느냐에 따라 분포가 달라지는 정도가 달라요. 달라진 날 수를 표준편차로 나눈 값을 제곱하면 0.16 대 4.04, 25배인데, 이 제곱이 100일치 피셔 정보에 확률 변화 0.02의 제곱을 곱한 값이에요.
문제 2: 정보가 많은 방향에서는 크게 걸을까, 작게 걸을까
확인 파라미터가 하나인 모델에서 피셔 정보를 계량으로 쓴 가장 가파른 한 스텝은 δθ=−ηF−1dθdL이다(위의 최급강하 방향에서 계량 자리에 F를 넣은 것). 같은 기울기 dθdL에서 피셔 정보 F가 큰 곳과 작은 곳 중 어디서 스텝이 더 큰가? 그 이유를 "분포가 얼마나 바뀌는가"로 설명하라.
기울기 dL/dθ가 같은 두 자리. 자리 A는 피셔 정보가 크고 자리 B는 작다
같이 풀기 세션 2
김민준
F가 크면 스텝도 커야 하지 않아요? 정보가 많다는 건 방향에 대한 확신이 크다는 거니까, 믿고 성큼성큼 가도 될 것 같은데요.
선생님
식을 다시 볼까요? F는 분모에 있어요, 분자에 있어요?
김민준
역행렬이니까 분모요. 그러면 F가 클수록 스텝이 작아지네요. 근데 직관은 왜 반대로 가죠?
이서연
피셔 정보가 크다는 건 θ를 조금만 바꿔도 분포가 크게 바뀐다는 뜻이잖아. 같은 δθ라도 분포 공간에서는 먼 거리야. 아까 1%에서 3%로 바꾼 예보처럼.
선생님
맞아요. 자연 그래디언트는 파라미터 공간이 아니라 분포 공간에서 일정한 거리만큼 걷자는 규칙이에요. 눈금이 촘촘한 곳에서는 좌표로 조금만 움직여도 이미 많이 간 거예요.
김민준
아, 수업 과제에서 하이퍼파라미터 튜닝할 때 조교가 "민감한 건 조금씩, 둔한 건 크게 바꿔 보세요"라고 했던 게 이거네요. 조금만 건드려도 결과가 확 바뀌는 게 피셔 정보가 큰 방향이고요.
문제 3: 붙잡아 둘 가중치는 큰 가중치일까
계산 앞 태스크를 배운 신경망의 두 가중치가 θ1=3.0, θ2=0.2이고, 앞 태스크에서 잰 피셔 정보행렬의 대각 성분은 F11=0.02, F22=5.0이다(설명하기 쉽게 고른 값). 새 태스크가 두 가중치를 각각 0.5씩 옮기려 한다. 앞 태스크의 출력 분포가 바뀌는 정도(KL 발산)는 대각 성분만 쓰면 가중치마다 21Fii(δθi)2로 근사된다. 각 가중치를 옮길 때의 값을 구하고, 가중치의 크기로 고를 때와 피셔 정보로 고를 때 어느 가중치를 붙잡게 되는지 비교하라.
앞 태스크를 배운 두 가중치의 값(왼쪽)과 앞 태스크에서 잰 피셔 대각 성분(오른쪽)
같이 풀기 세션 3
김민준
가지치기 수업 과제에서는 크기가 작은 가중치부터 잘랐거든요. 작으면 출력에 주는 영향도 작으니까요. 그러니까 붙잡아 둘 건 3.0짜리 θ1이죠.
선생님
계산부터 해 볼까요? 각각 0.5씩 옮기면 앞 태스크의 출력 분포는 얼마나 바뀌죠?
이서연
21×0.02×0.25=0.0025, 21×5.0×0.25=0.625. θ2를 옮길 때가 250배 커.
김민준
0.2짜리가요? 값이 그렇게 작은데요?
선생님
피셔 정보를 구하는 식에 가중치의 값이 들어 있었나요?
이서연
아니요. 그 가중치를 조금 바꿨을 때 로그우도가 얼마나 흔들리는지(스코어)만 들어 있어요. 값이 작아도 출력이 그 가중치에 예민하면 피셔 정보가 커요.
김민준
문제 1(강수확률 2%p)이랑 같네요. 50%에서 52%보다 1%에서 3%가 더 큰 변화였던 것처럼, 숫자의 크기가 아니라 분포가 얼마나 바뀌느냐로 재야 하는구나. 그래서 EWC는 θ2를 세게 붙잡는 거고요.
선생님
그래요. 「작은 가중치는 덜 중요하다」는 가지치기에서 쓰는 대략적인 기준이고, 「앞 태스크를 지키려면 무엇을 붙잡나」에는 피셔 정보가 직접 답해요.