10장 — 어텐션과 트랜스포머: 멀리 떨어진 칸끼리 읽기
여러 머리 어텐션: 한 번에 여러 갈래로 읽기
셀프 어텐션의 비중은 더해서 1이다. 그래서 토큰 하나가 받아 가는 것은 늘 값들의 평균 하나다. 「a red cube on top of a blue sphere」에서 「cube」 토큰이 자기 색을 알려 주는 「red」도 읽고 싶고, 자기가 어디에 놓이는지 알려 주는 다른 낱말도 읽고 싶다고 하자. 두 값을 (1, 0)과 (0, 1)이라 하면, 비중을 반씩 나눈 평균은 (0.5, 0.5)다. 이 벡터만 보고는 「둘을 반씩 읽었다」와 「둘 다 아닌 무언가를 읽었다」를 가르기 어렵다. 한 토큰이 여러 갈래를 한꺼번에 읽게 할 수는 없을까?
역사: 머리 하나로는 평균이 막는다
바스와니와 동료들은 질의·열쇠·값을 통째로 한 번 쓰지 않고, 짧은 조각 여러 벌로 나눠 따로 어텐션을 건 뒤 이어 붙였다. 논문의 기본 모델은 폭 512를 64씩 여덟 벌로 나눴다. 조각마다 길이가 8분의 1이라 계산량은 한 벌짜리와 비슷하다. 논문은 까닭을 「머리 하나로는 평균이 이것을 막는다」고 적었다. 같은 계산량에서 벌 수만 바꿔 영어–독일어 번역을 견준 표도 실었다. 한 벌이면 번역 점수(BLEU, 기계 번역을 사람 번역과 견줘 겹치는 낱말 묶음으로 매기는 점수)가 24.9, 여덟 벌이면 25.8, 열여섯 벌도 25.8, 서른두 벌이면 25.4였다. 나누는 것이 낫지만, 너무 잘게 나누면 조각 하나가 짧아져 다시 떨어진다.
머리마다 다른 것을 읽는다
학습된 모델의 머리들은 정말 서로 다른 것을 읽을까? 글 인코더로 많이 쓰는 CLIP ViT-L/14 의 글 쪽(12층, 층마다 12벌)에 「a red cube on top of a blue sphere」를 넣고 비중을 뽑았다. 이 인코더는 토큰이 자기와 앞 토큰만 읽도록 가려져 있다(가림은 이 장 끝 절에서 다룬다).
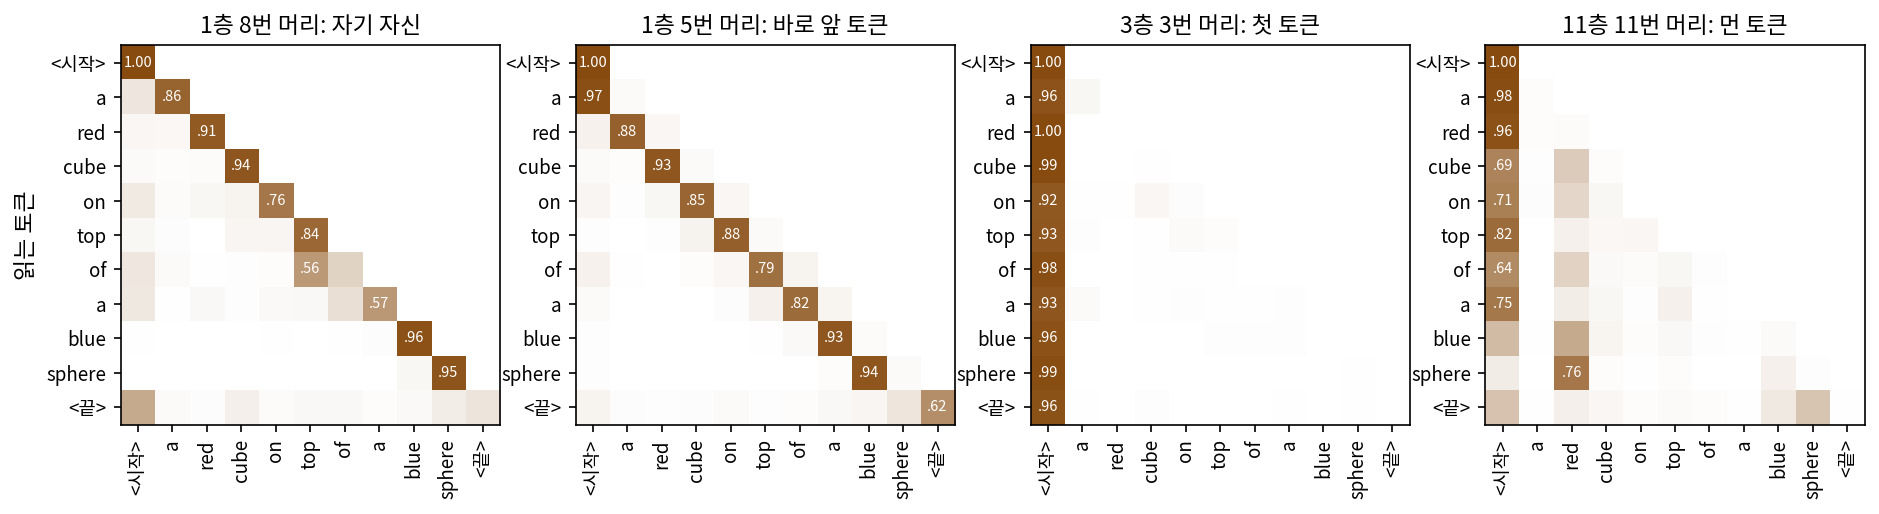
머리마다 읽는 방식이 뚜렷이 다르다. 한 머리는 「sphere」가 자기 자신에 0.95를 주고, 다른 머리는 「cube」가 바로 앞 「red」에 0.93, 「sphere」가 바로 앞 「blue」에 0.94를 준다. 셋째 머리는 거의 모든 토큰이 문장 첫 토큰에 0.9 넘게 준다. 뒤쪽 층의 한 머리에서는 「sphere」가 일곱 토큰 앞의 「red」에 0.76을 준다. 이렇게 질의·열쇠·값을 여러 벌로 나눠 벌마다 따로 비중을 매기고, 받아 간 것을 이어 붙여 다시 섞는 어텐션을 여러 머리 어텐션 (여러 벌로 나눠 따로 읽기 / multi-head attention)이라 하고, 한 벌을 머리라 부른다.
ML에서: 디퓨전 모델들의 머리
ComfyUI 설정으로 보면 Stable Diffusion 1.x 의 어텐션 블록은 단계와 상관없이 머리 8개를 쓴다. 폭이 320, 640, 1280이니 머리 하나의 길이는 40, 80, 160이다. SDXL 은 반대로 머리 하나의 길이를 64로 묶어 두고 폭에 따라 머리 수를 바꾼다(640이면 10개, 1280이면 20개, 설정 num_head_channels 64). FLUX.1 은 폭 3072를 머리 24개 × 128로 나누고, 그 128을 앞에서 본 회전 위치 인코딩의 16 + 56 + 56으로 쓴다. 머리 수는 「몇 갈래로 읽을까」와 「한 갈래의 질의·열쇠가 얼마나 길까」를 맞바꾸는 손잡이다.
문제 7. 머리를 나누면 무엇이 늘고 무엇이 그대로인가
폭 d = 320, 토큰 N = 4096인 셀프 어텐션을 머리 1개와 8개로 짠다. (가) 행렬 WQ, WK, WV, WO의 매개변수는 각각 몇 개인가(치우침 빼고)? (나) 점수를 매기는 곱셈은 몇 번인가? (다) 둘이 같다면 머리 8개는 무엇을 더 가진 것인가? (라) 머리를 320개로 나누면 어떻게 될까?

머리가 8개면 행렬도 8벌이니까 매개변수가 8배 아니에요?

머리 하나의 질의는 길이가 얼마죠? 그 질의를 만드는 행렬의 크기는요?

320 ÷ 8 = 40이니까 머리 하나는 320 × 40이고, 여덟 개를 옆으로 붙이면 320 × 320이에요. 결국 한 벌일 때와 같은 행렬을 여덟 칸으로 자른 거네요. 넷 합쳐 409,600개, 머리 수와 상관없어요.

(나)도 같아. 머리 하나면 4096² × 320번, 여덟이면 8 × 4096² × 40번, 둘 다 5,368,709,120번이야.
그럼 (다)는요? 셈은 같은데 무엇이 달라졌죠?

소프트맥스의 수예요. 한 벌이면 토큰마다 비중 분포가 하나라 평균을 하나밖에 못 내는데, 여덟 벌이면 분포가 여덟 개라 서로 다른 토큰 여덟 곳을 동시에 거의 통째로 읽을 수 있어요. 같은 재료로 평균을 여러 번 낼 권리를 산 거예요.

(라)는 머리 하나의 길이가 1이네요. 그럼 질의와 열쇠가 수 하나라 점수가 「q × k」 곱 하나예요. 무엇을 찾는지 수 하나로만 말해야 하니 너무 좁아요. 논문 표에서 32벌이 16벌보다 떨어진 것도 그쪽이겠네요.

그래요. 머리 수는 갈래 수와 갈래 하나의 표현력을 맞바꿔요. 어느 쪽 끝도 좋지 않아요.

조별 과제에서 한 명이 자료 조사를 다 하면 요약이 하나뿐이고, 여덟 명이 주제를 나눠 맡으면 요약이 여덟 개죠. 그런데 320명으로 쪼개면 한 사람이 한 줄밖에 못 쓰고요.
문제 8. 머리마다 읽는 것을 평균 내면
위 그림의 CLIP 글 인코더에서 1층(0부터 세어 0층)의 머리 12개가 「cube」에서 「red」로 주는 비중은 0.123, 0.016, 0.323, 0.206, 0.930, 0.013, 0.544, 0.020, 0.090, 0.070, 0.112, 0.025다. (가) 머리 12개를 평균 내면 얼마인가? (나) 머리를 하나만 두었다면 그 머리는 「cube」 자리에서 「red」를 얼마나 읽었을까? 평균값이 그 답인가? (다) 「5번 머리는 형용사와 명사를 잇는 머리다」라고 말해도 되는가?
(가)는 다 더해서 12로 나누면 0.206이에요. 그럼 머리 하나였으면 0.206쯤 읽었겠네요.
머리를 평균 낸 비중은 어떤 소프트맥스에서 나온 값이죠?

어… 어떤 소프트맥스에서도 안 나왔어요. 머리마다 다른 점수로 따로 낸 비중을 제가 그냥 평균 낸 거예요.
머리를 하나만 두고 학습했다면 그 머리는 다른 행렬을 배웠을 테니까, 0.206은 아무 머리의 답도 아니야. 다만 이건 말할 수 있어. 머리 하나는 「red」에 0.93을 주면서 동시에 첫 토큰이나 자기 자신에 크게 줄 수 없어. 합이 1이니까. 지금은 그 일들을 다른 머리들이 나눠 맡고 있고.
(다)는요?

「blue sphere」에서도 0.94였으니 이 문장에서는 그렇게 보여요. 그런데 이 머리는 그냥 「바로 앞 토큰」을 읽는 것일 수도 있어요. 「a red」의 「red」도 바로 앞 「a」를 읽을 테니까요.
그래요. 문장 하나의 비중 표는 머리의 버릇을 엿보는 창이지 머리의 정의가 아니에요. 형용사와 명사를 잇는다고 말하려면, 그 둘이 붙어 있지 않은 문장을 많이 넣어 봐야 해요.
조원 한 명이 이번 회의에서 계속 회계 얘기를 했다고 「회계 담당」으로 정해 버리면 안 되는 거네요. 다음 회의에서도 그러는지 봐야죠.