10장 — 어텐션과 트랜스포머: 멀리 떨어진 칸끼리 읽기
KV 캐시: 앞에서 계산한 열쇠와 값을 적어 두고 다시 쓴다
언어모델은 글을 한 토큰씩 이어 쓴다. 토큰 하나를 쓸 때마다 지금까지의 모든 토큰을 읽고, 쓴 토큰을 줄 끝에 붙인 뒤 다시 다음 토큰을 쓴다. 영상을 앞 프레임에 이어 붙여 만드는 모델도 같은 꼴로 걷는다. 그런데 셀프 어텐션에서는 모든 토큰이 모든 토큰을 읽었다. 줄 끝에 토큰이 하나 붙으면 앞 토큰들도 그 새 토큰을 읽어야 하니, 앞 토큰의 은닉 상태가 모든 층에서 바뀐다. 그러면 토큰 하나를 쓸 때마다 줄 전체를 처음부터 다시 계산해야 할까?
역사: 미래를 가리고, 열쇠와 값을 줄이기까지
바스와니와 동료들의 디코더는 번역문을 한 낱말씩 쓰므로, 학습 때 번역문 토큰이 뒤 토큰을 보면 안 됐다. 논문은 이것을 「왼쪽으로 정보가 흐르는 것을 막는다」고 적고, 점수 표에서 뒤 토큰 칸을 소프트맥스 전에 −∞로 바꿔 비중을 0으로 만들었다. 토큰 i는 자기와 앞 토큰만 읽는다. 이 가림 덕분에 앞 토큰의 계산은 뒤에 무엇이 붙든 바뀌지 않는다.
그러자 다른 병목이 드러났다. 2019년 샤지어(Noam Shazeer)는 트랜스포머를 학습할 때는 빠른데 한 토큰씩 쓸 때는 느린 까닭을 따져, 계산이 아니라 크게 쌓인 열쇠·값 표를 걸음마다 메모리에서 다시 읽어 오는 데 드는 대역폭이 속도를 정한다고 보였다. 그래서 모든 머리가 열쇠와 값 한 벌을 함께 쓰게 했다(다중 질의 어텐션, MQA). 쓰는 속도는 크게 빨라졌지만 품질이 조금 떨어졌다. 2023년 에인슬리(Joshua Ainslie)와 동료들은 그 사이를 골랐다. 질의 머리 몇 개가 한 묶음이 되어 열쇠·값 한 벌을 나눠 쓰는 묶음 질의 어텐션(GQA)이다. 이미 학습한 모델을 원래 학습 계산의 5%만 더 들여 이 꼴로 바꿀 수 있었고, 품질은 원래 꼴에 가깝고 속도는 MQA 에 가까웠다고 보고했다.
토큰 하나를 더 붙여도 앞은 그대로다
작은 트랜스포머(앞 정규화 블록 4벌, 폭 32)로 확인했다. 토큰 8개를 넣은 출력과, 토큰 하나를 더 붙여 9개를 넣은 출력의 앞 8개를 견준다. 가림이 있으면 가장 큰 차이가 4.8 × 10⁻⁷로, 계산 순서가 달라 생기는 반올림 차이뿐이다. 가림이 없으면 가장 큰 차이가 0.414다. 가림이 있는 모델에서 앞 토큰들의 은닉 상태, 따라서 층마다의 열쇠와 값은 한 번 계산하면 끝까지 그대로라는 뜻이다.
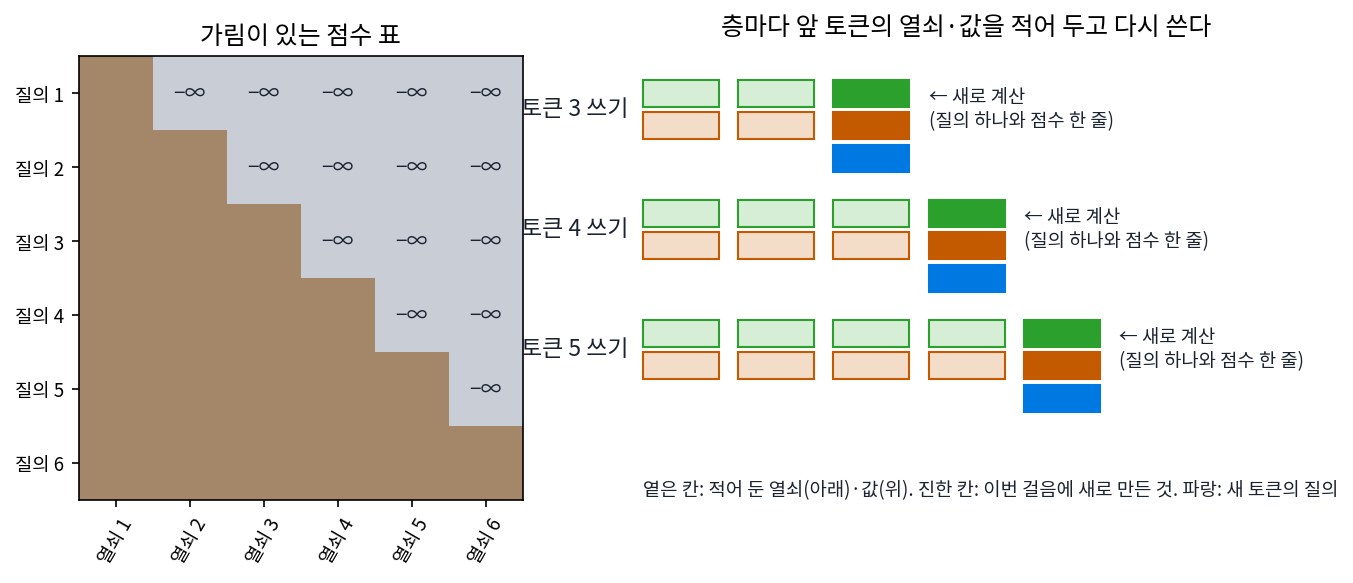
그래서 층마다 앞 토큰들의 열쇠와 값을 적어 두면, 새 토큰 하나를 쓸 때는 그 토큰의 질의·열쇠·값만 만들고 적어 둔 열쇠들과 점수 한 줄을 매기면 된다.
뒤 토큰을 가리는 이 장치를 가림(causal mask)이라 하고, 가림 덕분에 바뀌지 않는 앞 토큰들의 열쇠와 값을 층마다 적어 두고 다시 쓰는 것을 KV 캐시 (적어 둔 열쇠·값 / key-value cache)라 한다. K와 V는 열쇠(key)와 값(value)의 머리글자이고, 캐시(cache)는 다시 쓰려고 가까이 적어 두는 곳이다.
ML에서: 글 인코더로 쓸 때는 캐시가 필요 없다
Krea 2 가 글 인코더로 쓰는 Qwen3-VL-4B 의 언어 쪽은 블록 36벌에 질의 머리 32개, 열쇠·값 머리 8개, 머리 하나의 길이 128이다(로컬 설정 파일 config.json). 질의 머리 넷이 열쇠·값 한 벌을 나눠 쓰는 묶음 질의 어텐션이다. 이 모델이 대화하며 글을 이어 쓸 때는 KV 캐시가 속도와 메모리를 정한다. 그런데 디퓨전 모델의 글 인코더로 쓸 때는 프롬프트를 한 번에 넣고 은닉 상태만 꺼내므로 이어 쓰기가 없고, 캐시도 필요 없다. 캐시가 다시 중요해지는 것은 앞 프레임에 이어 영상을 만들어 가는 모델이다. 지난 프레임들의 열쇠와 값을 적어 두고, 새 프레임의 토큰들이 그것을 읽는다.
문제 14. 가계부의 누계
한 달 30일 동안 날마다 쓴 돈을 적고, 날마다 「이번 달 지금까지 쓴 돈」을 확인한다. (가) 날마다 1일부터 그날까지를 처음부터 다시 더하면 한 달에 덧셈은 몇 번인가(그날 하나만 있어도 한 번으로 센다)? (나) 어제의 누계에 오늘 쓴 돈만 더하면? (다) 15일에 3일 치 기록이 틀린 것을 알고 고쳤다. (나)의 방법에서는 무엇을 해야 하는가?

(가)는 1 + 2 + … + 30 = 465번, (나)는 날마다 한 번이니까 30번이에요. 열다섯 배 넘게 줄어요.

(다)는요? 누계를 그대로 이어 가면 되나요?

3일 치만 고치면 되죠. 누계는 그대로 쓰고요.

3일부터 14일까지의 누계가 다 틀린 값이잖아. 적어 둔 누계는 「앞 기록이 다시 바뀌지 않는다」를 믿고 쓴 거니까, 앞 기록이 바뀌면 그 뒤 누계를 다 다시 해야 해.

그래요. 적어 두고 다시 쓰는 방법은 앞의 것이 바뀌지 않을 때만 맞아요.

엑셀에서 누계 칸을 값으로 붙여 넣어 놓으면, 위 칸을 고쳐도 누계가 안 바뀌어서 틀리는 거랑 같네요. 저 지난 학기 과제에서 그거 때문에 감점당했어요.
문제 15. 가림이 있어야 적어 둘 수 있다
토큰을 하나씩 n개 쓴다. 블록 하나, 머리 하나만 보자. (가) 걸음마다 지금까지의 토큰 전부를 처음부터 다시 셀프 어텐션에 넣으면, k번째 걸음에서 매기는 (질의, 열쇠) 점수는 몇 개이고 n걸음 동안 모두 몇 개인가? n = 100, 1000이면? (나) 가림이 있고 KV 캐시를 쓰면? (다) 가림이 없는 모델(토큰이 뒤 토큰도 읽는 인코더)에서 KV 캐시를 쓰면 무엇이 틀리는가?
(가)는 k번째 걸음에 토큰이 k개니까 k × k = k²개, 다 더하면 1² + … + n²이에요. n = 100이면 338,350개, 1000이면 333,833,500개요.

(나)는 걸음마다 새 토큰의 질의 하나로 열쇠 k개만 보니까 k개, 다 더하면 n(n + 1)/2야. 100이면 5,050, 1000이면 500,500. 1000토큰이면 667배 차이네.
(가)에서 다시 계산한 점수 가운데, (나)는 버리고 있는 것들이 있죠. 그 점수들은 정말 필요 없나요?

가림이 있으면 앞 토큰들의 줄은 지난 걸음과 똑같으니까 다시 매겨도 같은 값이에요. 위에서 토큰 하나를 더 붙였을 때 앞 8개 출력이 반올림 차이만큼만 달랐던 게 그거고요.
(다)는요?
캐시를 쓰면 속도는 똑같이 빨라지니까 쓰면 되지 않아요?
가림이 없으면 새 토큰이 붙을 때 앞 토큰들도 새 토큰을 읽어서 바뀌어야 해. 그 작은 모델에서 가림을 빼니까 앞 8개 출력이 0.414까지 달라졌잖아. 둘째 블록부터는 열쇠와 값이 그 바뀐 은닉 상태로 만들어지니까, 적어 둔 열쇠와 값은 낡은 거야. 빠르지만 틀린 답이 나와.
그래요. KV 캐시는 가림이라는 단서 조건 위에서만 맞는 계산이에요.

조별 보고서를 한 장씩 이어 쓰는데 앞 사람이 뒷장을 보고 자기 장을 고치는 규칙이면, 먼저 쓴 장을 확정본으로 철해 두면 안 되는 거네요.
문제 16. Qwen3-VL-4B 의 캐시는 얼마나 큰가
Qwen3-VL-4B 언어 쪽은 블록 36벌, 열쇠·값 머리 8개, 머리 하나의 길이 128이고 bf16(수 하나에 2바이트)이다. (가) 토큰 하나에 KV 캐시는 몇 바이트인가? 토큰 512개, 32,768개면? (나) 질의 머리 32개가 저마다 열쇠·값을 가졌다면(MHA)? 모두 한 벌을 나눠 썼다면(MQA)? (다) 이 캐시는 모델이 디퓨전의 글 인코더로 쓰일 때도 필요한가? (위젯 3에서 세 가지 머리 수를 눌러 확인해 보자.)
(가)는 2 × 36 × 8 × 128 × 2 = 147,456바이트, 144 KiB예요. 512토큰이면 72 MiB, 32,768토큰이면 4.5 GiB요.
앞의 2와 뒤의 2는 같은 2인가요?

아, 앞의 2는 열쇠와 값 두 가지, 뒤의 2는 bf16 바이트예요. 하나를 빼먹으면 반이 되겠네요.
(나)는 머리 수에 비례하니까 MHA 면 네 배라 토큰당 576 KiB, 32,768토큰이면 18 GiB야. 매개변수 40억 개 남짓을 bf16 으로 올리는 데만 7 GiB 넘게 드니까, 24 GiB 짜리 RTX 4090 한 장에 다 들어가지 않아. MQA 면 여덟 분의 일, 32,768토큰에 0.56 GiB.
MQA 가 그렇게 작은데 왜 Qwen 은 머리 8개를 남겼을까요?
열쇠·값이 한 벌이면 머리마다 「무엇인가」와 「무엇을 건네나」를 같은 벡터로만 말해야 해서, 여러 머리 어텐션이 여러 갈래로 읽던 힘의 일부가 줄어요. 샤지어가 품질이 조금 떨어졌다고 적은 게 그쪽이고, GQA 는 그 사이에서 고른 거예요.

(다)는 필요 없어요. 프롬프트를 한 번에 넣고 은닉 상태만 꺼내니까 이어 쓸 토큰이 없어요. 점수 표는 한 번 매기고 끝이에요.
그래요. 같은 모델이라도 어떻게 쓰느냐에 따라 무엇이 병목인지 달라져요.
도서관에서 책을 한 번 읽고 반납하면 복사본을 쌓아 둘 필요가 없는데, 매일 이어 읽으려면 어디까지 읽었는지 메모를 들고 다녀야 하는 거네요.