매니폴드 가설: 그림은 좁은 면 위에, 잡음은 모든 방향에
가로세로 32픽셀 컬러 그림 한 장은 수 3,072개다. 그 공간에서 수를 아무렇게나 뽑으면 거의 확실히 지지직거리는 잡음이 나오니, 그림다운 그림은 넓은 공간의 아주 좁은 곳, 차원이 낮은 매끈한 면 근처에만 모여 있다. 잡음을 섞는 것은 그 좁은 곳을 떠나는 일이었다. 그렇다면 신경망이 맞힐 두 후보는 사는 곳이 다르다. 깨끗한 그림은 좁은 면 근처에, 섞은 잡음은 3,072개의 방향 모두에 고르게 퍼져 있다. 세 출력 꼴이 끝까지 같은 답에 닿는다고 할 때는 신경망이 무엇이든 끝까지 맞힐 만큼 넉넉하다고 보았다. 신경망이 답을 내보내는 길이 좁다면, 사방으로 퍼진 잡음과 좁은 면 위의 그림을 맞히는 일이 똑같이 쉬울까?
두 갈래 나선을 높은 차원에 묻기
「그림은 좁은 면 위에, 잡음은 모든 방향에」가 맞히기의 쉽고 어려움을 정말 가르는지 보려면, 데이터가 어디에 놓였는지 정확히 아는 가장 작은 경우가 필요하다. 2차원 평면 위의 두 갈래 나선을 D차원 공간에 무작위 방향으로 놓자. 점 하나는 D개의 수로 적히지만 신경망이 모르는 평면 위에서만 움직인다. D는 신경망이 한 번에 내놓는 수(그림이라면 픽셀 값의 개수), 2는 그림이 실제로 움직이는 차원의 자리다. 리·허(Tianhong Li, Kaiming He)가 2025년 논문에서 쓴 장난감과 같은 틀을 이 책의 기호로 다시 짰다. 잡음 섞기는 이 책의 플로우 매칭 그대로다.
신경망은 폭 d = 256(은닉 층 하나에 수 256개)인 5층 MLP 이고, 내놓은 것을 위의 식으로 속도로 바꿔 셋 다 같은 속도 공간에서 손실을 잰다(분모는 학습 때 0.05, 샘플링 때 0.01에서 자른다). 5,000걸음 학습한 뒤 시험 점 4,096개에서 손실을 재고, 오일러 100걸음으로 만든 점 4,096개가 평면에서 얼마나 떨어졌는지(참 데이터는 0)와 평면 위에서 나선과 얼마나 다른지(조각 바서슈타인 거리, 참 나선 두 벌 사이는 0.02~0.05)를 쟀다. 시드 셋의 평균이다.
| 한 번에 내놓는 수 D | 시험 속도 손실: 원래 그림 / 잡음 / 속도 예측 | 만든 점의 평면 밖 거리: 원래 그림 / 잡음 / 속도 예측 |
|---|---|---|
| 2 | 2.86 / 2.94 / 2.78 | 0 / 0 / 0 |
| 16 | 3.08 / 5.13 / 3.04 | 0.017 / 0.15 / 0.020 |
| 64 | 4.04 / 61.2 / 6.08 | 0.026 / 8.47 / 0.20 |
| 256 | 7.58 / 4,097 / 134 | 0.042 / 1,934 / 10.1 |
| 512 | 11.5 / 13,827 / 382 | 0.050 / 3,733 / 18.6 |
| 2048 | 35.2 / 82,477 / 1,916 | 0.080 / 8,744 / 43.4 |
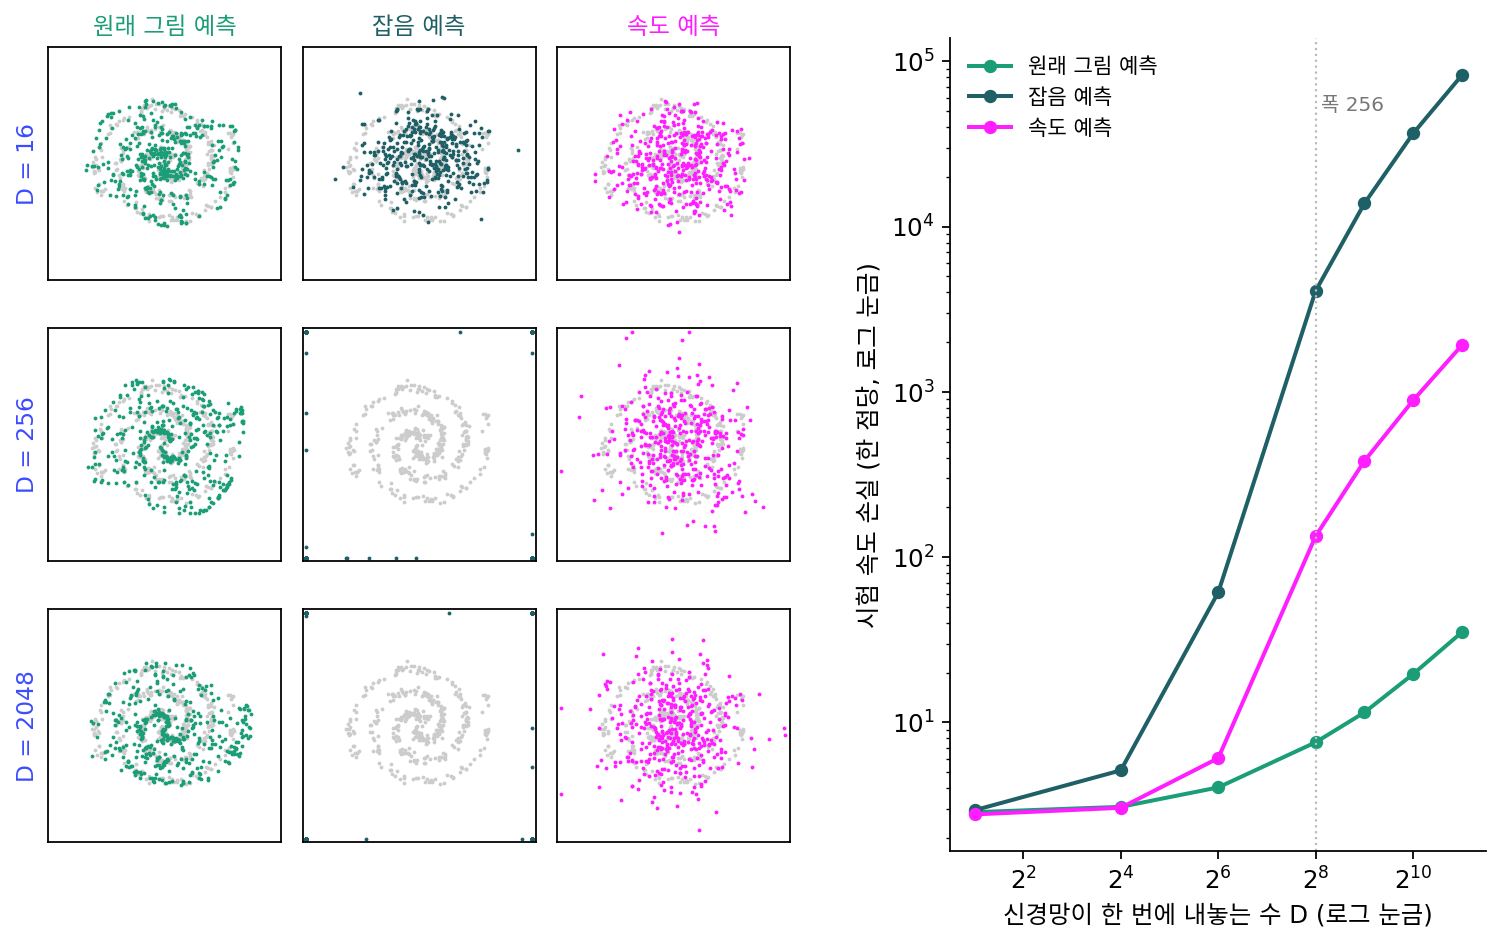
D = 16까지는 셋이 비슷하다. 잡음 예측은 D = 64부터, 속도 예측은 폭과 같은 256부터 손실이 D를 따라 치솟고, 잡음 예측은 샘플링이 터져 점이 화면 밖으로 날아갔다. 원래 그림 예측은 D = 2048에서도 손실 35, 평면 밖 거리 0.08이다. 속도 예측의 점을 평면으로 되돌려 찍으면 나선 모양은 흐릿하게나마 남는다(조각 바서슈타인 0.15~0.18, 원래 그림 예측 0.11~0.17). 무너진 곳은 평면 위가 아니라 잡음이 퍼져 있던 평면 밖이다.
예상과 다른 결과도 둘 있었다. D가 작을 때 평면 위 모양은 속도 예측이 가장 좋았다(D = 2에서 0.07, 원래 그림 예측 0.18). 또 D = 512에서 폭을 1024로 넓혀도 속도 예측의 손실은 382에서 174로 줄었을 뿐이다. 폭을 64로 좁혀도 원래 그림 예측은 11.5 그대로였다.
그림처럼 높은 차원의 수로 적히는 데이터가 실제로는 차원이 훨씬 낮은 매끈한 면 근처에 모여 있다는 경험적 주장을 매니폴드 가설 (데이터는 좁은 면 근처에 모인다 / manifold hypothesis)이라 한다. 장난감은 그 면이 정확히 평면 하나인 경우다. 같은 정보라던 세 꼴이 왜 이렇게 갈라지는지, 신경망의 어느 자리가 막히는지는 아래 문제에서 따져 보자.
ML에서: 실제 그림의 면은 몇 차원인가
포프(Phillip Pope)와 동료들은 2021년, 이웃한 그림 사이의 거리로 데이터가 실제로 움직이는 차원을 어림하는 방법을 흔히 쓰는 그림 자료에 적용했다. CIFAR-10 그림 한 장은 수 3,072개이지만 어림한 차원은 13~26이었고, ImageNet 그림은 26~43이었다(이웃을 몇 개 쓰느냐에 따라 달라진다). 같은 논문은 차원이 낮은 자료일수록 신경망이 적은 예로 배우고 시험 자료에도 잘 들어맞는다고 보고했다. 그림 생성 신경망이 한 번에 내놓는 수는 대개 이 차원보다 훨씬 많다.
문제 4. 젖은 송장을 메모 한 장으로
비에 젖은 택배 송장 사진이 두 사무실에 똑같이 있다. 송장은 60칸짜리 글자판이고, 칸마다 0~9단계의 얼룩이 번졌다. 이 구역의 주소는 모두 주소록에 네 자리 번호로 올라 있다. 첫째 사무실이 둘째 사무실로 넘길 수 있는 것은 20자짜리 메모 한 장뿐이다. (가) 원래 송장을 알려 주려면 몇 자가 필요한가? 얼룩 무늬를 칸마다 알려 주려면? (나) 둘째 사무실이 원래 송장과 얼룩 무늬를 둘 다 알아야 한다면 무엇을 적어 보내야 하는가? (다) 칸마다 「얼룩 − 원래 글자」 같은 섞은 값을 보내면 어떤가?
(가)는 주소록 번호면 4자, 얼룩은 60칸이니까 60자요. 메모가 20자라 얼룩은 못 보내요. (나)는 둘 다 알아야 하니까… 주소 4자에 얼룩 16칸까지만 보내고 나머지 44칸은 포기해야겠네요.
둘째 사무실 손에 이미 무엇이 있었죠?
젖은 사진이요. 아, 사진은 원래 송장 위에 얼룩이 얹힌 거니까, 주소 번호로 깨끗한 송장을 뽑아서 사진에서 빼면 얼룩이 통째로 나와요. 4자면 둘 다 알아요.
(다)는 섞은 값도 칸마다 다른 수라서 60자가 들어. 섞은 값 안에 얼룩이 통째로 들어 있으니까, 얼룩을 보내는 것만큼 길 수밖에 없어.
그래요. 메모의 길이를 정하는 것은 보내는 것이 몇 칸에 걸쳐 제멋대로 움직이느냐예요. 주소는 주소록 1만 곳 안에서만 움직이고, 얼룩은 60칸 모두에서 따로 움직여요.
받는 쪽이 이미 가진 사진에서 나머지를 계산할 수 있으면, 좁은 쪽만 보내면 되는 거네요.
팀원이 원본 파일을 이미 갖고 있으면 고친 파일 전체를 보내지 않고 「몇 번 버전으로 되돌려」만 보내는 거랑 같네요.
문제 5. 폭이 막는 자리
신경망의 마지막 은닉 층은 폭이 d 이고, 그 뒤 선형 층 Wout(D × d 행렬)과 치우침 b 가 D개의 수를 내놓는다. 위의 잡음 섞기와 세 식에서 (가) 출력 꼴마다 속도 오차 v̂ − v 를 신경망이 맞혀야 할 것의 오차로 적어라. (나) D > d 일 때 출력이 놓일 수 있는 곳은 몇 차원인가? 속도 예측의 손실은 얼마 아래로 내려갈 수 없는가? D = 512, 2048, d = 256에서 구해 위 표와 견주라. (다) 원래 그림 예측에도 같은 벽이 있는가? (라) 데이터가 평면이 아니라 휘어진 면 위에 있다면?
(가)는 식에 xt = (1 − t)x₀ + tε 를 넣으면 돼. 원래 그림 예측은 (xt − x̂₀)/t − (ε − x₀) = (x₀ − x̂₀)/t, 잡음 예측은 (ε̂ − ε)/(1 − t), 속도 예측은 그대로 v̂ − v. 셋 다 「맞혀야 할 것의 오차」에 시간에 따른 수 하나를 곱한 꼴이야.
(나)는 출력이 D개니까 D차원이죠. 512개의 수를 따로따로 내놓잖아요.
출력은 Wouth + b 예요. h 는 몇 개의 수죠? h 를 아무리 바꿔도 Wouth 가 갈 수 있는 곳은 어디예요?
h 는 d = 256개요. Wouth 는 Wout 의 열 256개를 섞은 것뿐이니까… 512차원 공간 안의 256차원 평평한 곳을 못 벗어나네요. 수는 512개인데 따로 움직이는 건 256개뿐이에요.
그럼 나머지 D − d 개 방향의 성분은 신경망이 무슨 짓을 해도 못 맞혀. 속도 ε − x₀ 에서 x₀ 는 평면 위에 있지만 ε 는 방향마다 분산이 1이니까, 못 닿는 방향마다 평균 1씩 오차가 남아. 손실은 D − d 아래로 못 내려가. 512면 256, 2048이면 1,792야.
표의 속도 예측이 382, 1,916이니까 그 벽 바로 위에 붙어 있네요. 평면 밖 거리 18.6, 43.4도 √256 = 16, √1792 = 42.3 근처예요. 못 닿는 방향의 잡음을 하나도 못 걷어 내고 그대로 남긴 거네요. 잡음 예측은 같은 오차에 1/(1 − t)² 까지 곱해지니까 더 크고요.
그럼 (다)는요? 원래 그림도 512개의 수잖아요.
똑같이 막히는 거 아니에요?
아니야. x₀ 는 512개의 수지만 2차원 평면 위에서만 움직여. 평평한 곳 256차원 안에 그 평면만 들어 있으면 오차를 0까지 줄일 수 있어. 잡음은 xt 안에 이미 있으니까, 식이 xt 에서 x̂₀ 를 빼서 알아서 계산해 주고.
그래요. 송장 문제에서 사진이 하던 일을 여기서는 식 속의 xt 가 해요. (라)는요?
휘어진 면은 평평한 곳을 더 많이 차지할 수 있어요. 원 하나도 평면 하나가 필요하니까요. 그래도 잡음처럼 D개 방향 전부를 쓰지는 않으니, 그 면이 차지하는 평평한 곳의 차원이 폭보다 작으면 같은 이야기가 돼요. 픽셀 그림에서 그게 폭보다 작은지는 실험으로 봐야 하고요.
하나 더 짚어 두죠. 이 벽은 손실이 내려갈 수 있는 바닥일 뿐이에요. 벽이 없다고 다 배운다는 뜻은 아니에요. 폭을 1024로 넓혀 벽을 없애도 속도 예측이 174에 머문 것이 그거예요.
선형대수 시간에 배운 「상의 차원은 계수를 넘지 못한다」네요. 행렬이 아무리 커도 열이 256개면 그 행렬로 갈 수 있는 곳은 256차원이에요.
문제 6. 원래 그림 예측의 약한 끝
위 장난감에서 D = 512, 폭 256인 신경망의 시험 속도 손실을 시간 구간 넷 [0, 0.25), [0.25, 0.5), [0.5, 0.75), [0.75, 1)로 나누면 원래 그림 예측은 35.9, 3.60, 3.22, 2.09이고, 속도 예측은 437, 357, 357, 376이다. (가) 원래 그림 예측의 손실을 끌어올린 구간은 어디이고, 왜 하필 그 구간인가? (나) 원래 그림 오차 ‖x̂₀ − x₀‖² 가 0.01일 때 t = 0.02와 0.5에서 속도 오차는 각각 얼마인가? (다) 그 큰 속도 오차는 만든 그림을 망치는가? 오일러 걸음의 마지막 걸음, 곧 걸음 크기가 남은 시간 t 와 같은 걸음을 따져 보라. (라) 리·허는 학습 때 속도로 바꾸는 식의 분모(t 자리)를 0.05 아래로 내려가지 않게 자른다. 왜 자를까?
(가)는 [0, 0.25)요. 35.9로 다른 구간의 열 배예요. 데이터 쪽 끝이면 원래 그림이 거의 다 보이는데, 왜 거기서 틀리죠?
문제 5에서 원래 그림 예측의 속도 오차를 무엇으로 적었죠?
(x₀ − x̂₀)/t 요. t 로 나누니까 t 가 0 근처면 작은 원래 그림 오차도 크게 불어나요. (나)는 0.01/0.02² = 25, 0.01/0.5² = 0.04. 같은 오차가 600배 넘게 달라져요.
그럼 원래 그림 예측은 데이터 쪽 끝에서 샘플링이 엉망이 돼야 하잖아요. 그런데 위 표에서 평면 밖 거리는 0.050으로 셋 가운데 제일 작았어요.
마지막 걸음을 식으로 적어 봐요. 남은 시간이 t 이고 걸음 크기도 t 예요.
xt − t × (xt − x̂₀)/t = x̂₀. 나눈 t 를 걸음 t 가 다시 곱해서 지워요. 마지막 걸음은 신경망이 낸 원래 그림에 그대로 내려앉네요. 속도 오차가 커 보인 건 속도로 바꿔 쟀기 때문이지 그림이 나빠서가 아니었어요.
(라)는 학습 쪽 문제구나. 속도 공간에서 손실을 재면 t = 0.01인 표본 하나의 원래 그림 오차가 1/t² = 10,000배로 불어나서 기울기를 휘둘러. 0.05에서 자르면 그 배율이 400에서 멈춰.
그래요. 원래 그림 예측에도 약한 끝이 있어요. 잡음 예측의 약한 끝이 잡음 쪽이라면 이쪽은 데이터 쪽이에요. 다만 이쪽은 재는 자리가 만든 문제라, 분모를 자르는 정도로 다스릴 수 있어요. 잡음 예측이 높은 차원에서 부딪힌 벽은 그렇게 지워지지 않고요.
마감 1분 전에 남은 분량을 시간당 쪽수로 바꾸면 엄청난 숫자가 나오지만, 실제로 남은 건 한 줄뿐인 거랑 같네요.