자주 하는 실수와 요약
자주 하는 실수
| 실수 | 나온 문제 | 바로잡는 법 |
|---|---|---|
| 흐른 열이 같으면 엔트로피 합의 변화도 같다고 봄 | 1 | 내준 쪽과 받은 쪽의 Q/T를 따로 적는다. 온도 차가 작을수록 합이 작다 |
| 독립된 두 계의 경우의 수를 더함 | 2 | 경우의 수는 곱, 엔트로피는 합 |
| 로그 대신 다른 함수를 써도 된다고 생각 | 2 | 곱을 합으로 바꾸는 연속 함수는 c ln뿐 |
| 미니배치마다 낸 평균 loss를 다시 단순 평균함 | 3 | loss는 합으로 모은 뒤 전체 토큰 수로 나눈다 |
| 카드 수가 늘면 기다리는 시간도 비례해서 는다고 봄 | 4 | 순서의 수는 n × (n − 1) × ⋯ × 1 = n!로 곱해 불어난다 |
| 입자 하나의 경우만 셈 | 5 | N개가 독립이면 2ᴺ배 |
| 비가역 과정에 Q/T를 그대로 씀 | 5 | 엔트로피는 상태 함수. 같은 처음과 끝을 잇는 가역 과정으로 잰다 |
| ln 값에 bit라는 단위를 붙임 | 6 | 1 bit = ln 2 nat. 값에는 항상 단위를 쓴다 |
| 조건을 무시하고 전체 엔트로피를 답함 | 6 | 무엇을 알고 난 뒤의 값인지 먼저 정한다 |
| nat으로 잰 NLL을 bit 단위의 논문 값과 비교 | 7 | ln 2로 나눠 bits per dim으로 바꾼다 |
| −Σ p ln p의 마이너스 누락 | 8 | 엔트로피는 음수가 될 수 없다. 각 항을 "놀라움"으로 읽는다 |
| 고르지 않은 확률에 ln W를 씀 | 8 | ln W는 균등할 때의 값이자 상한 |
| 가장 높은 확률만 보고 예측의 불확실성을 잼 | 9 | 엔트로피는 모든 클래스의 퍼짐을 본다. 무엇을 불확실하다고 부를지 먼저 정한다 |
| 글자 하나가 알려 주는 양이 큰 언어가 정보를 더 빽빽하게 전한다고 봄 | 10 | 글자를 쪼개는 방식에 따라 달라진다. 같은 뜻의 문장 전체에 드는 비트로 비교한다 |
| 확률을 무시하고 후보 수로 질문 수를 셈 | 11 | 평균 질문 수의 한계는 H |
| “평균이 정수여야 한다” | 11 | 한 판은 정수, 여러 판의 평균은 실수 |
| 토큰 확률을 평균한 뒤 로그를 씀 | 12 | 문장의 확률은 토큰 확률의 곱, 비트는 토큰마다 구해 더한다 |
| 가장 흔한 답에 확률을 몰아주면 loss가 준다고 봄 | 13 | 드물다고 한 답이 나오면 −ln q가 크다. KL은 q = p에서만 0 |
| 로그로 잰 놀라움을 그대로 후보 수로 읽음 | 14 | bit면 2^H, nat이면 e^H로 되돌린다 |
| nat loss에 2^loss | 15 | 거듭제곱의 밑 = 로그의 밑. nat이면 e^loss |
| loss가 0까지 내려가야 한다고 기대 | 15 | 바닥은 데이터의 엔트로피 H(p) |
요약
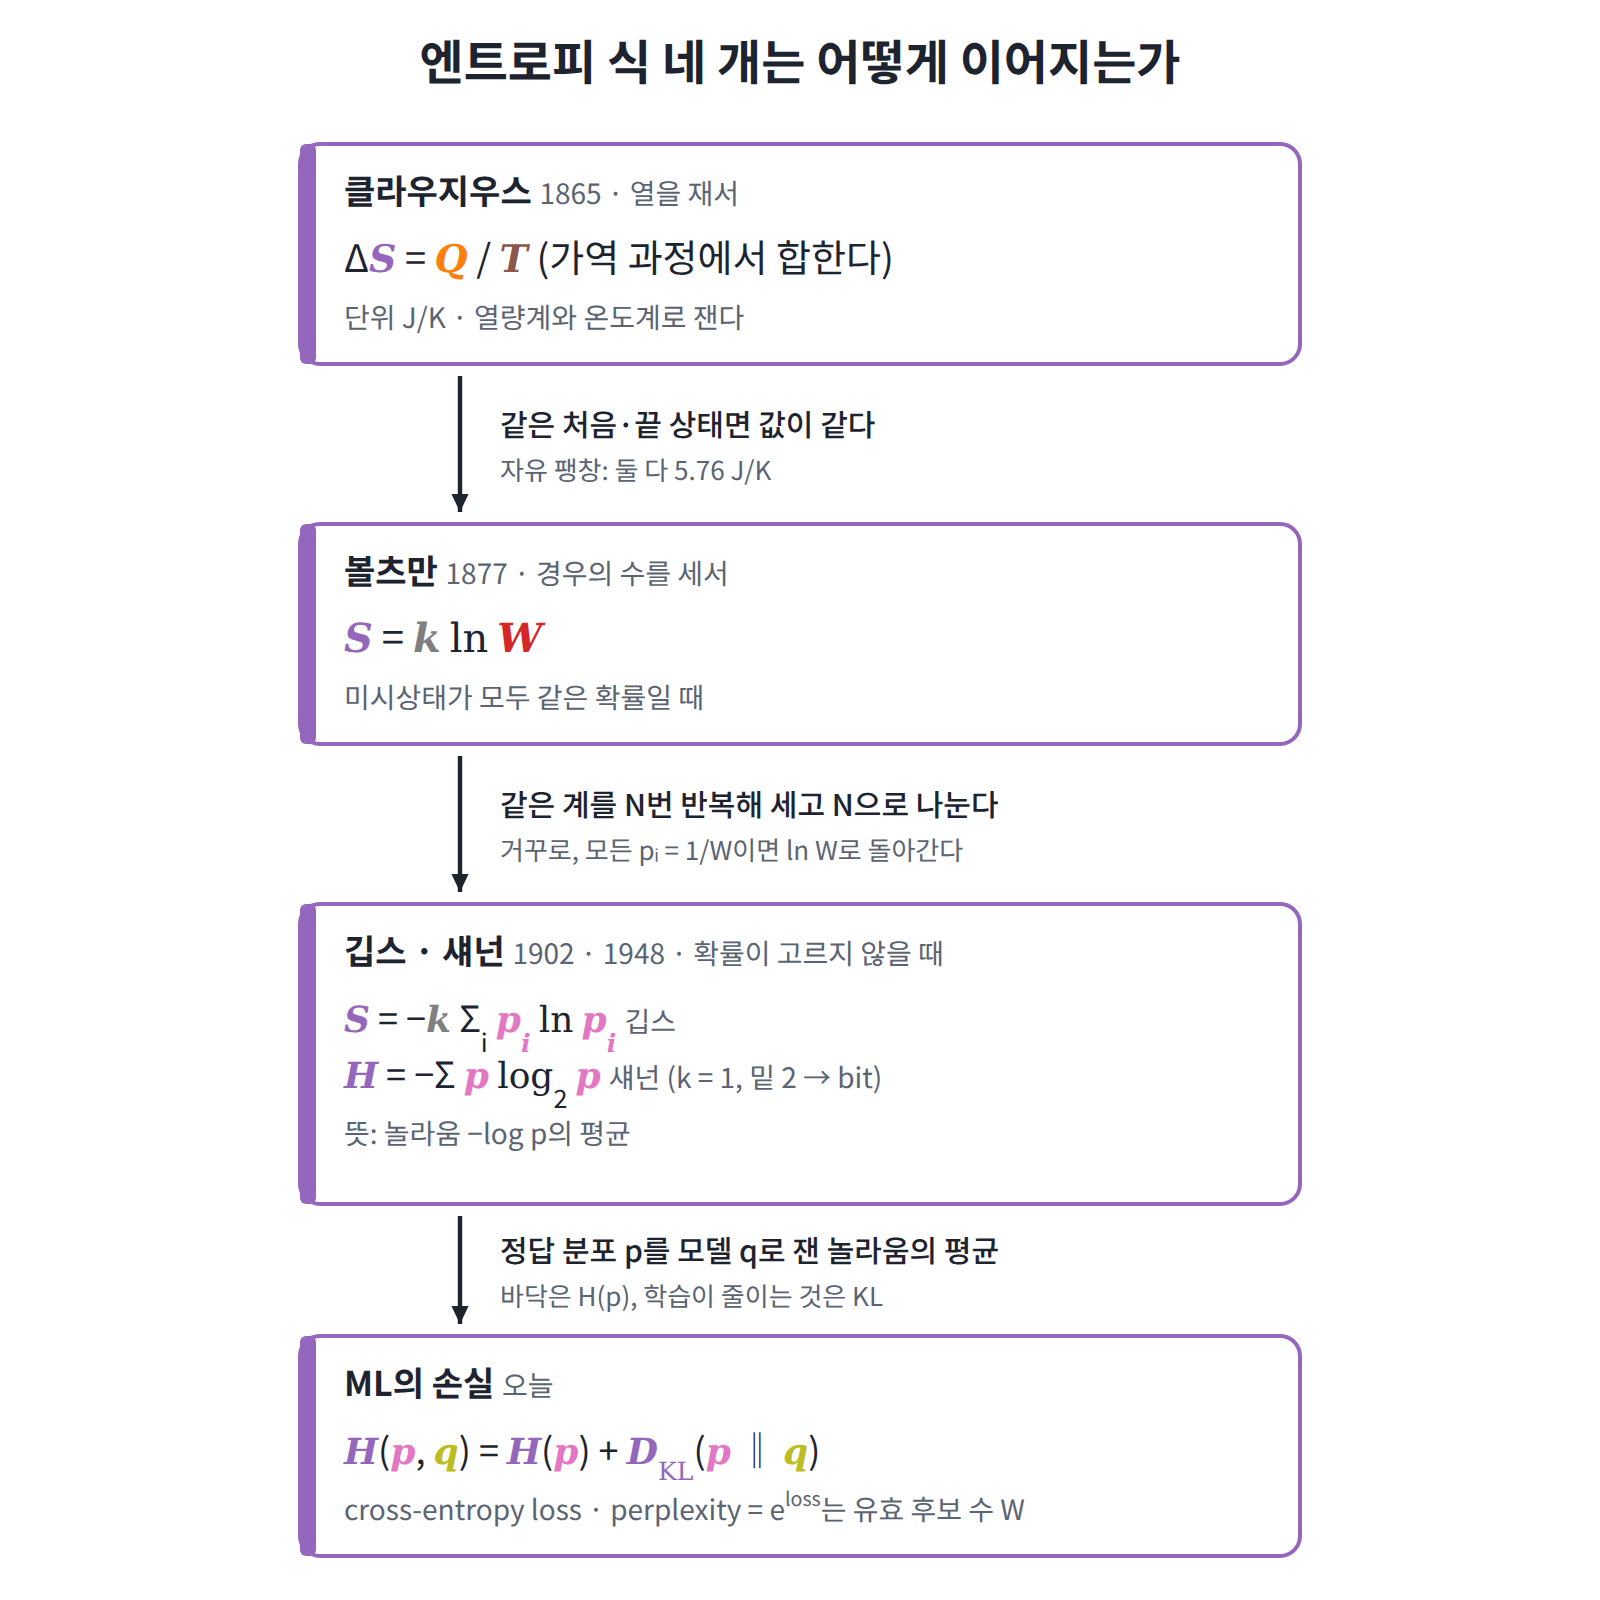
엔트로피는 열기관에서 Q/T로 먼저 측정되었고, 볼츠만은 그것이 거시상태에 속한 경우의 수의 로그 k ln W임을 보였다. 로그여야 하는 이유는 경우의 수는 곱해지는데 측정값은 더해지기 때문이며, 이 조건을 만족하는 함수는 로그뿐이다. 확률이 고르지 않으면 엔트로피는 −Σ p ln p, 곧 평균 놀라움이 되는데, 이것이 섀넌의 정보 엔트로피이자 cross-entropy loss의 바닥이다. loss가 그 바닥 아래로 내려가지 않는 것은 나머지 몫인 KL 발산이 언제나 0 이상이기 때문이다. 그리고 perplexity e^loss는 볼츠만의 W를 거꾸로 계산한 "유효 후보 수"다.
막힌 곳
이제 우리는 엔트로피를 세고, 단위를 바꾸고, loss와 perplexity를 읽을 수 있다. 그런데 한 가지가 설명되지 않은 채 남아 있다. 클라우지우스의 Q/T에는 온도계로 잰 T가 아무 설명 없이 들어 있다는 점이다.
왜 하필 열을 온도로 나눠야 경우의 수와 맞는 것일까? 경우의 수만으로 이야기해 온 이 장의 언어로는, 온도가 무엇인지에 대해 아직 한 마디도 할 수 없다.