깁스 엔트로피: 확률이 고르지 않을 때
지금까지 쓴 S = k ln W는 모든 미시상태가 같은 확률일 때의 식이다. 그런데 앞면이 90% 나오는 동전처럼 미시상태마다 확률이 다르면, 경우의 수만 세어서는 안 된다. 그렇다면 확률이 pᵢ로 제각각일 때는 어떻게 해야 할까?
역사: 깁스의 교과서
미국의 물리학자 깁스는 1902년에 펴낸 통계역학 교과서에서, 미시상태마다 확률이 다른 경우의 엔트로피를 한 식으로 정리했다. 그래서 이 식에는 그의 이름이 붙어 있다.
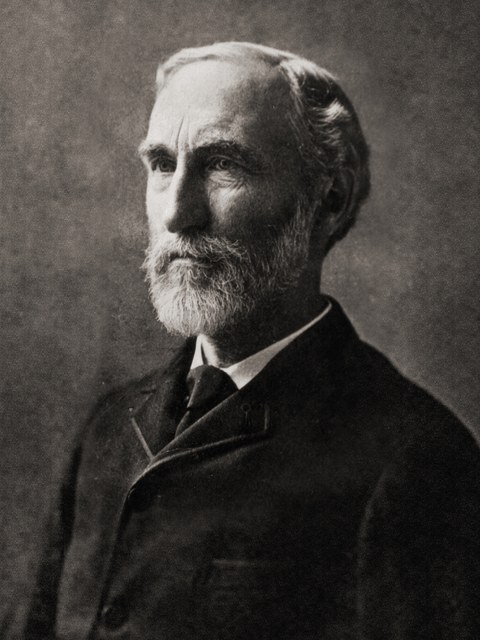
그 무렵 분자의 운동으로 열역학을 설명하려는 시도는 곤란을 겪고 있었다. 이를테면 원자 둘로 된 기체 분자는 이론대로라면 움직임을 적는 데 독립된 숫자가 여섯 개 필요한데, 열을 얼마나 머금는지를 재는 실험으로는 다섯 개밖에 드러나지 않았다. 깁스는 책의 머리말에서 이 예를 들며, 물질이 무엇으로 어떻게 이루어졌는지에 대한 가설 위에 이론을 세우는 것은 불안한 토대라고 적었다. 그래서 그는 다른 길을 골랐다. 한 계가 시간에 따라 어떻게 움직이는지를 좇는 대신, 같은 종류의 계를 아주 많이 상상해 두고 그것들이 여러 상태에 어떤 비율로 나뉘어 있는지를 보자는 것이다. 각 상태의 확률에 로그를 취한 값을 그는 「확률 지수」(index of probability)라 불렀고, 이 지수를 평균해 부호를 뒤집은 값이 열역학의 엔트로피와 같은 자리에 선다는 것을 보였다. 깁스는 이 책이 나온 이듬해 세상을 떠났다.
앞면이 90%인 동전을 세어 보면
첫 문단의 동전으로 직접 세어 보자. 앞면이 90% 나오는 동전을 N번 던지면, N이 클수록 앞면 비율은 거의 확실히 90% 근처가 된다. 그렇다면 앞면이 정확히 90%인 수열은 몇 가지이고, 그 로그를 N으로 나눈 동전 하나당 몫은 얼마일까?
| 던진 횟수 N | 앞면이 90%인 수열의 수 W | 동전 하나당 ln W / N (nat) |
|---|---|---|
| 10 | 10 | 0.230 |
| 100 | 약 1.7 × 10¹³ | 0.305 |
| 1,000 | 약 6.4 × 10¹³⁹ | 0.322 |
| 10,000 | 약 10¹⁴¹⁰ | 0.325 |
던지는 횟수가 늘수록 동전 하나당 몫은 0.325 nat 근처로 모인다. 공정한 동전이라면 같은 계산이 ln 2 ≈ 0.693 nat으로 모이므로, 앞면이 90%인 동전 한 개가 품은 불확실성은 공정한 동전의 절반도 안 되는 셈이다. 게다가 앞면이 정확히 90%인 수열들은 앞면과 뒷면의 개수가 모두 같으니 서로 확률이 똑같다. 확률이 같은 후보들이므로, 볼츠만처럼 세어서 로그를 취해도 된다.
왜 이 식인가: 스털링 근사로 경우의 수를 세면
그런데 왜 하필 0.325일까? 표를 끝없이 늘리지 않고도 답을 얻는 방법이 있다. 동전 N개 중 앞면 비율이 p인 경우의 수는 스털링 근사(ln N! ≈ N ln N − N)를 쓰면 다음과 같다.
p = 0.9를 넣으면 h(0.9) = −0.9 ln 0.9 − 0.1 ln 0.1 ≈ 0.325 nat으로, 표가 다가가던 값과 같다.
이제 앞면 확률이 p인 동전을 N번 던진다고 하자. N이 크면 앞면 비율은 거의 확실히 p가 되고, 그런 수열은 대략 e^(N·h(p))개이며 그들끼리는 거의 같은 확률을 갖는다. 그러니 동전 한 개당 볼츠만 엔트로피는 h(p)이고, 이것은 앞면과 뒷면 두 결과의 확률로 쓴 −Σ p ln p다.
확률로 쓴 엔트로피
상태가 둘보다 많아도 같은 계산이 된다. 이항계수 대신 여러 칸으로 나누는 경우의 수 N!/(n₁!n₂!⋯)(다항계수)를 쓰면, 확률이 pᵢ로 제각각일 때의 엔트로피는 다음과 같다. 이를 깁스 엔트로피 (확률로 쓴 엔트로피, Gibbs entropy)라 부른다.
여기서 한 가지를 확인해 두자. 모든 pᵢ가 1/W이면 −Σ (1/W) ln(1/W) = ln W가 되므로, 확률이 고를 때 깁스의 식은 볼츠만의 식으로 돌아간다.
다시 말해 깁스의 식은 새로운 정의가 아니라, 같은 계를 N번 반복해 경우의 수를 센 뒤 N으로 나눈 것이다.
엔트로피가 가장 클 때
상태가 W개일 때 −Σ p ln p는 모든 pᵢ가 1/W일 때 가장 크고, 그 최댓값이 ln W다. 반대로 확률이 한쪽으로 치우칠수록 엔트로피는 작아지는데, 그만큼 덜 모른다는 뜻이다. 이를테면 식당 세 곳 가운데 늘 가는 곳이 있는 친구라면, 내일 어디에 갈지 맞히기가 쉽다.
확률을 고르게 둔 데서 한 상태 쪽으로 조금씩 옮겨 가며 세 상태의 엔트로피를 계산해 보면 이렇다.
| 세 상태의 확률 | 엔트로피 (nat) |
|---|---|
| (1/3, 1/3, 1/3) | 1.099 = ln 3 |
| (0.4, 0.3, 0.3) | 1.089 |
| (0.6, 0.2, 0.2) | 0.950 |
| (0.8, 0.1, 0.1) | 0.639 |
| (0.98, 0.01, 0.01) | 0.112 |
왜 고를 때 가장 클까? 깁스의 식이 N번 되풀이해 센 경우의 수에서 왔다는 것을 떠올리면 된다. N번을 여러 상태에 나눠 담는 방법의 수는 몫이 고를수록 많다. 동전 10개 가운데 앞면이 5개인 수열은 252가지인데 앞면이 9개인 수열은 10가지뿐인 것과 같다.
ML에서: 예측이 얼마나 확신에 차 있는가
분류 모델이 softmax로 내놓는 출력도 확률 분포이므로, 같은 식으로 엔트로피를 잴 수 있다. 엔트로피가 0에 가까우면 한 클래스를 거의 확신한 예측이고, 상한 ln(클래스 수)에 가까우면 클래스들 사이에서 거의 갈피를 못 잡은 예측이다. 라벨이 없는 예제 가운데 사람에게 먼저 라벨을 물어볼 것을 고를 때, 이렇게 예측이 불확실한 예제부터 고르는 방법을 불확실성 샘플링(uncertainty sampling)이라 한다.
문제 8. 확률이 고르지 않은 엔트로피
세 상태의 확률이 0.5, 0.3, 0.2일 때 엔트로피를 nat으로 구하라.
Σ p ln p니까 0.5 ln 0.5 + 0.3 ln 0.3 + 0.2 ln 0.2 ≈ −1.03. 엔트로피가 음수네요.
경우의 수가 1보다 작을 수 있어요?

없죠. 그럼 ln W도 음수가 못 되는데… 마이너스를 빼먹었네요. −Σ p ln p ≈ 1.03 nat.

pᵢ는 1보다 작으니 ln pᵢ는 항상 음수예요. 마이너스는 그걸 양수로 뒤집기 위한 것이고요. 각 항 −ln pᵢ는 늘 양수이고 드문 상태일수록 크다고 읽으면 부호를 잊지 않아요.
저는 상태가 세 개니까 S = ln 3 ≈ 1.10으로 했어요.
ln W는 모든 상태가 같은 확률일 때의 식이에요. 여기는 절반이 첫 상태에 모여 있죠. 식당 세 곳 중 한 곳에 절반은 가는 친구의 점심은, 세 곳을 똑같이 돌아가는 친구보다 맞히기 쉬워요.
1.03 < 1.10이네요. ln 3은 상한이고, 균등할 때만 같아지는 거죠?

맞아요. 그리고 e^1.03 ≈ 2.8이에요. "상태는 셋이지만 실제로는 2.8개쯤으로 헷갈린다"는 뜻이에요.
문제 9. 누구에게 먼저 라벨을 물을까
클래스가 셋인 분류 모델이 라벨이 없는 예제 셋에 다음 확률을 주었다. A는 (0.9, 0.05, 0.05), B는 (0.45, 0.45, 0.10), C는 (0.5, 0.25, 0.25)다. 사람에게 하나만 라벨을 물을 수 있을 때, 예측 엔트로피가 가장 큰 예제는 무엇인가? 그 예제는 가장 높은 확률이 가장 낮은 예제와 같은가?
계산할 것도 없이 B예요. 가장 높은 확률이 0.45로 셋 중에 제일 낮으니까 모델이 제일 헷갈리는 거죠.
이 절에서 헷갈리는 정도를 잰 양은 무엇이었죠? 셋 다 계산해 볼까요?
−Σ p ln p로 하면 A는 0.39, B는 0.95, C는 1.04 nat이에요. C가 제일 크네요? 가장 높은 확률은 C가 0.5로 B보다 높은데요.
B는 두 클래스 사이에서만 헷갈리고 셋째는 0.1로 거의 지웠잖아. C는 첫째가 조금 앞서도 나머지 둘이 똑같이 살아 있고. e^(엔트로피)로 바꾸면 B는 후보 2.6개, C는 2.8개쯤 사이에서 헷갈리는 셈이야.
맞아요. 가장 높은 확률만 보는 방법은 첫째 말고 나머지가 어떻게 퍼졌는지를 버리고, 엔트로피는 모든 클래스의 퍼짐을 다 봐요. 그렇다고 엔트로피가 늘 정답은 아니에요. 두 클래스를 가르는 경계가 궁금하다면 첫째와 둘째 확률의 차이가 0인 B를 먼저 묻는 편이 나을 수 있고, 실제로 그 차이로 고르는 방법도 써요. 무엇을 불확실하다고 부를지부터 정해야 하는 거죠.
시험 전에 조교님께 물어볼 문제를 고를 때, 두 답 사이에서 헷갈리는 문제를 물을지 아예 감이 안 오는 문제를 물을지 먼저 정하는 거랑 같네요.