메트로폴리스 알고리즘: Z 없이 볼츠만 분포 뽑기
세부 균형은 확률의 비만 요구했다. 볼츠만 분포 pᵢ = e^(−βEᵢ)/Z에서 두 상태의 확률의 비는 e^(−β(Eⱼ − Eᵢ))이고, 여기에는 Z가 없다. 그렇다면 「옮겨 갈 확률의 비가 볼츠만 인자의 비와 같다」는 조건을 지키도록 업데이트 규칙을 정하면, Z를 한 번도 계산하지 않고 볼츠만 분포를 정상 분포로 갖는 체인을 만들 수 있지 않을까?
역사: 로스앨러모스의 다섯 사람
1953년 『화학 물리학 저널』에 「빠른 계산 기계로 계산한 상태 방정식」이라는 논문이 실렸다. 저자는 니컬러스 메트로폴리스, 아리아나 로젠블루스와 마셜 로젠블루스 부부, 오거스타 텔러와 에드워드 텔러 부부의 다섯 사람이었고, 계산은 로스앨러모스 연구소의 컴퓨터 MANIAC으로 했다. 그들이 알고 싶었던 것은 2차원 상자에 담은 단단한 원판(많게는 224개)의 압력이었다. 압력은 모든 배치에 대한 평균인데, 배치를 무작위로 고르게 뽑아 볼츠만 인자로 가중 평균하는 방법은 쓸모가 없었다. 원판이 빽빽하면 무작위로 뽑은 배치는 거의 모두 원판끼리 겹쳐서 볼츠만 인자가 0이기 때문이다.
그들이 쓴 방법은 거꾸로였다. 배치를 고르게 뽑고 무게를 다는 대신, 원판 하나를 조금 움직여 보고 그 움직임을 에너지에 따라 받아들이거나 물리는 스텝을 되풀이해서, 배치들이 처음부터 볼츠만 분포의 확률로 나오게 했다. 그러면 나온 배치들을 무게 없이 그대로 평균하면 된다. 뒤에 첫 저자의 이름을 따 메트로폴리스 알고리즘이라 불린 이 방법에서 저자 다섯 사람이 각각 무엇을 했는지는 뒤의 회고로 전해진다. 마셜 로젠블루스는 2003년 로스앨러모스의 강연에서, 시간 평균 대신 여러 배치의 평균을 내자는 결정적인 제안은 에드워드 텔러가 했고, 실제 작업은 자신과 아리아나가 했으며, 메트로폴리스는 컴퓨터 시간을 내준 것 말고는 개발에 관여하지 않았다고 회고했다. 1970년에는 캐나다 토론토 대학교의 통계학자 키스 헤이스팅스가 이 방법을 대칭이 아닌 제안에까지 넓혀 통계학의 일반적인 도구로 만들었다.
에너지 다섯 칸의 사다리
가장 작은 예로, 에너지가 0, 1, 2, 3, 4인 칸 다섯 개가 한 줄로 있고 온도가 kT = 1인 경우를 해 보자. 공은 매 스텝 왼쪽이나 오른쪽 옆 칸 하나를 1/2씩 제안받고, 제안이 줄 밖이면 물리고 제자리에 머문다. 내려가는 제안은 늘 받아들이고, 올라가는 제안은 e^(−1) = 0.368의 확률로만 받아들인다. 맨 위 칸에서 출발해 이 규칙으로 10만 스텝을 걸으며 칸마다 머문 비율을 세면 0.639, 0.233, 0.086, 0.031, 0.011이다. 같은 칸들의 볼츠만 분포를 Z로 나눠 정확히 계산하면 0.636, 0.234, 0.086, 0.032, 0.012다. 업데이트 규칙 어디에도 Z는 없었다.
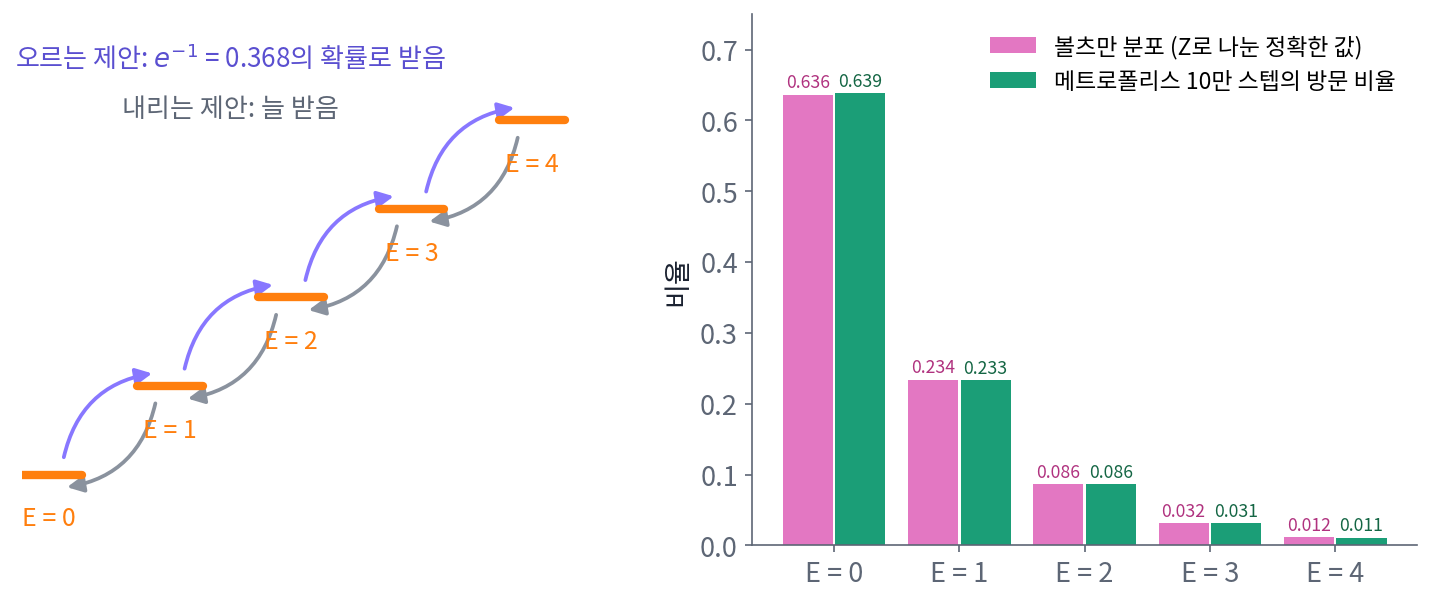
왜 이 규칙이 볼츠만 분포를 정상 분포로 갖는지는 세부 균형으로 확인할 수 있다. 이웃한 두 칸 i와 j(Eⱼ = Eᵢ + 1)를 보자. 제안 확률은 양쪽으로 1/2로 같으므로, 옮겨 갈 확률의 비는 받아들일 확률의 비 e^(−1)/1이다. 이 비 e^(−1)이 두 칸의 볼츠만 인자의 비와 같으므로 세부 균형이 성립하는데, 이를 일반적으로 적으면 이렇다.
제안이 대칭이라면, 곧 i에서 j를 제안받을 확률과 j에서 i를 제안받을 확률이 같다면, 이 받아들일 확률로 세부 균형이 성립한다. 높은 쪽이 j라고 하면 A(i → j) = π(j)/π(i)이고 A(j → i) = 1이므로, 두 받아들일 확률의 비가 정확히 확률의 비가 된다. 분자와 분모에 똑같이 들어 있던 Z는 비를 내는 순간 지워진다. 이렇게 옆 상태를 제안하고 확률의 비에 따라 받아들이거나 물리는 스텝을 되풀이해, 정규화 합 없이 원하는 분포를 정상 분포로 갖는 체인을 만드는 방법을 메트로폴리스 알고리즘 (확률의 비로 받아들이는 샘플러, Metropolis algorithm)이라 한다. 물린 스텝에서는 제자리에 머문 것도 샘플로 한 번 센다는 점을 잊지 말자. 이 칸들이 높은 확률을 갖는 것은 체인이 거기에 오래 머물기 때문이다.
ML에서: 베이즈 사후분포의 증거
베이즈 학습에서 파라미터 θ의 사후분포는 p(θ | 데이터) = p(데이터 | θ) p(θ) / p(데이터)다. 분자의 우도와 사전분포는 θ마다 계산할 수 있지만, 분모의 증거 p(데이터)는 모든 θ에 대한 적분이라 신경망 가중치처럼 차원이 크면 계산할 수 없다. 이 증거 p(데이터)가 볼츠만 분포의 정규화 합 Z와 같은 구실을 한다. 메트로폴리스 알고리즘은 두 θ의 사후확률 비만 쓰므로 증거 없이 사후분포에서 샘플을 뽑는다. 제안이 대칭이 아닐 때 받아들일 확률에 제안 확률의 비를 곱해 바로잡는 것이 헤이스팅스의 일반화이고, 그 모양은 아래 문제 14에서 직접 만들어 본다. 로그 사후확률의 그래디언트를 따라 멀리 제안하는 해밀토니안 몬테카를로도, 제안을 물리로 만들었을 뿐 마지막에는 이 받아들이기 단계로 정확성을 지킨다.
문제 13. 점심 메뉴 고르기
서연이는 점심마다 지금 먹는 메뉴 말고 다른 메뉴 하나를 떠올리는데, 메뉴는 둘뿐이고 만족도 점수는 김치찌개 2점, 칼국수 1점이다. 떠올린 메뉴의 점수가 더 높으면 내일 그것으로 바꾸고, 더 낮으면 e^(점수 차이) 확률로만 바꾼다. (가) 오래 지나면 김치찌개를 먹는 날의 비율은 얼마인가? (나) 김치찌개를 먹는 날의 비율은 두 점수의 softmax와 어떤 관계인가?

왜 굳이 점수가 낮은 걸로 바꿔요? 김치찌개가 더 좋으면 계속 김치찌개만 먹으면 되잖아요. 그럼 비율은 1이요.

매일 같은 것만 먹으면 질리잖아. 그리고 그게 문제의 규칙이야.

규칙대로 보면 김치찌개에서 칼국수로 바꿀 확률은요?

점수 차이가 −1이니까 e^(−1) = 0.368이요. 칼국수에서 김치찌개로는 점수가 오르니까 늘 바꾸고요.
오래 지나 비율이 멈추려면 무엇이 같아야 하죠?

두 도시 문제처럼 주고받는 게 같아야죠. 김치찌개 날이 a라면 a × 0.368 = (1 − a) × 1에서 a = 0.731이에요.
softmax로 계산하면 e²/(e² + e¹) = 0.731로 똑같아요. 점수를 음의 에너지로 보고 온도 1인 볼츠만 분포를 뽑은 거네요. 그런데 업데이트 규칙에는 e² + e¹이라는 합이 한 번도 안 나왔어요.

그래요. 온도를 0.5로 낮추면 바꿀 확률이 e^(−2) = 0.135가 되어 김치찌개 비율이 0.881로 오르고, 온도를 2로 올리면 0.622로 내려가요. 민준 학생이 말한 「좋은 것만」은 온도가 0일 때예요.

메뉴가 둘이면 softmax를 바로 계산하는 게 빠른데, 메뉴가 10^30개면 이 방법밖에 없겠네요. 옆 메뉴 하나만 떠올리면 되니까요.
문제 14. 끝 칸에서 제안이 한쪽뿐이면
칸 0, 1, 2가 한 줄로 있고, 목표는 세 칸에 고르게 1/3씩 머무는 것이다(세 칸의 에너지가 같다). 끝 칸 0과 2에서는 안쪽 칸 1만 제안하고, 가운데 칸 1에서는 양옆을 1/2씩 제안한다. (가) 에너지가 같으니 제안을 늘 받아들이면 어떤 분포가 나오는가? (나) 받아들일 확률에 「돌아오는 제안 확률 ÷ 가는 제안 확률」을 곱해 min(1, ·)을 취하면 어떻게 되는가?
에너지가 다 같으니까 e^0 = 1이라 늘 받아들여요. 그러면 고르게 1/3씩 나오겠죠.
전이 행렬을 짜서 정상 분포를 구해 봐요.
0에서는 늘 1로, 2에서도 늘 1로, 1에서는 반반으로 가니까… 정상 분포가 (0.25, 0.5, 0.25)예요. 가운데에 두 배로 머물러요!

가운데 칸은 양쪽 끝에서 다 1을 제안하니까 들어오는 제안이 몰리는 거야. 에너지가 같아도 제안이 대칭이 아니면 메트로폴리스의 받아들일 확률만으로는 세부 균형이 안 돼.

그럼 (나)대로 바로잡아 봐요. 0에서 1로 가는 제안은 확률 1, 1에서 0으로 돌아오는 제안은 1/2이에요.

0 → 1을 받아들일 확률은 min(1, (1/2)/1) = 1/2, 1 → 0은 min(1, 1/(1/2)) = 1이에요. 그러면 0에서는 반은 1로 가고 반은 제자리라서, 정상 분포가 (1/3, 1/3, 1/3)으로 돌아와요. 제안이 많이 몰리는 가운데 칸 1은 그만큼 덜 받아들여서 맞추는 거네요.
그게 헤이스팅스의 일반화예요. 받아들일 확률을 min(1, (π(j) q(j → i))/(π(i) q(i → j)))로 잡으면, 제안 q가 어떻게 생겼든 세부 균형이 성립해요. 제안이 대칭이면 q가 지워져서 메트로폴리스의 식이 되고요.
조교 눈에 앞자리 학생 손만 잘 보이면, 앞자리 질문은 조금 덜 받고 뒷자리 질문을 일부러 더 받아 줘야 공평해지는 거랑 같네요.
문제 15. 증거 없이 동전의 사후분포 뽑기
동전을 10번 던져 앞면이 7번 나왔고, 앞면 확률 θ(세타)의 사전분포는 0과 1 사이에서 고르므로 사후분포는 θ⁷(1 − θ)³에 비례한다. 메트로폴리스로 지금 θ에 표준편차 0.1인 정규분포 노이즈를 더해 제안한다. (가) θ = 0.5에서 0.6을 제안받았을 때와 0.7에서 0.8을 제안받았을 때 받아들일 확률은? (나) 0과 1 밖의 제안은 어떻게 하는가? (다) 20만 스텝의 표본 평균이 무엇과 같아야 하는가?
사후확률을 계산하려면 정규화 상수부터 구해야 해요. θ⁷(1 − θ)³을 0부터 1까지 적분해야 하니까 격자를 촘촘히 깔아서…
받아들일 확률은 비만 쓰잖아. 정규화 상수는 분자와 분모에서 지워져.
아, 그렇지. (0.6/0.5)⁷ × (0.4/0.5)³ = 1.835니까 1보다 커서 늘 받아들이고, (0.8/0.7)⁷ × (0.2/0.3)³ = 0.755니까 75.5% 확률로 받아들여요.
(나)는요? 정규분포 노이즈라 −0.05 같은 제안도 나와요.
사전분포가 0과 1 밖에서 0이니까 사후확률도 0이고, 비가 0이라 늘 물려요.
물린 스텝에서는 샘플에 무엇을 적죠?
아무것도 안 적고 다음 스텝으로 넘어가면 되지 않아요?
그러면 경계 가까운 θ에서 물리는 일이 잦으니까 그 θ가 덜 세어지잖아. 물린 스텝에서는 지금 θ를 한 번 더 세야 해. 그리고 제안을 0과 1 안으로 접어 넣으면 안 되나 생각했는데, 그러면 경계 근처에서 제안이 대칭이 아니게 되니까 헤이스팅스 보정이 필요해지겠네요.
그래요. (다)는 이 문제에서는 정확한 답을 알 수 있어서 확인이 돼요. 정규화 상수는 1/1320이고 사후 평균은 8/12 = 0.667이에요.
돌려 보니까 앞 2,000스텝을 버린 표본 평균이 0.668이에요. θ가 0.5보다 클 확률도 샘플로 0.887이고, 정확한 값도 0.887이에요. 1/1320은 한 번도 안 썼는데요!
반 등수를 매길 때 전교생 점수 합을 몰라도 두 사람 점수만 비교하면 되는 거랑 같네요.