17장 — 스핀 글래스와 레플리카 방법
이 장의 물음
장·벵지오·하르트·레흐트·비냘스(2017)는 이미지 분류용 합성곱 신경망이 무작위로 바꾼 라벨도, 구조 없는 노이즈 이미지도 「쉽게 맞춘다」고 보고했다. 그렇다면 가장 단순한 분류기는 무작위 라벨을 몇 개까지 외울 수 있을까? 입력이 100개인 퍼셉트론을 생각해 보자. 편향 없이 입력의 가중합 부호로 +1이나 −1을 내는, 가장 단순한 선형 분류기다. 표준정규분포에서 뽑은 무작위 입력 벡터 P개에 동전을 던져 라벨을 붙인 뒤, 모든 라벨을 맞히는 가중치가 있는지를 선형계획법(부등식 조건을 모두 만족하는 해가 있는지 판정해 주는 표준 계산법)으로 확인한다. 문제를 200번씩 새로 뽑아 보면 P가 160일 때는 99.5%가 외워지고, 180이면 91%, 200이면 49%, 220이면 11.5%로 떨어지며, 240이면 한 번도 외워지지 않는다. 입력 수의 두 배 근처에서 외울 수 있는 문제가 외울 수 없는 문제로 바뀌는 것이다. 입력을 400개로 늘리면 이 바뀜은 더 날카로워져, 입력 수의 1.8배에서는 거의 늘 외워지고 2.2배에서는 거의 외워지지 않는다.
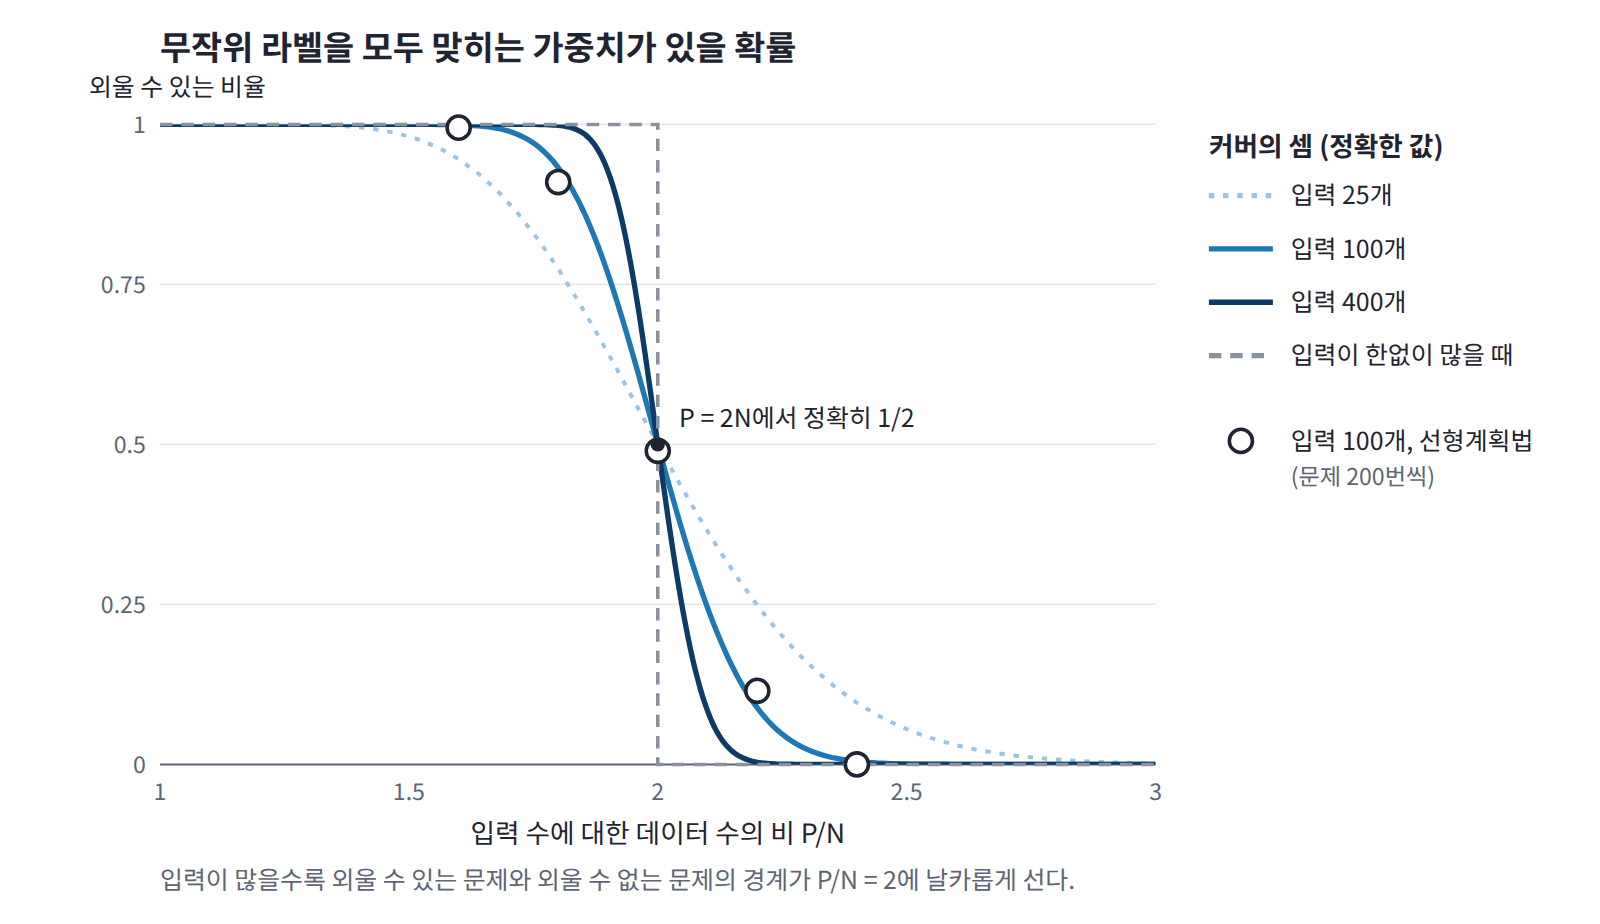
이 실험에서 첫째로, 외울 수 있는지는 데이터를 뽑을 때마다 달라지는 운의 문제인데도, 입력이 많아지면 답이 거의 하나로 정해진다. 둘째로, 경계의 값 2는 특정한 데이터 하나가 아니라 무작위로 뽑힌 데이터 전체가 가진 성질이다. 이런 값을 계산하려면 데이터를 고정한 채 조건을 모두 만족하는 가중치가 얼마나 많은지를 재고, 그 가중치 수의 로그를 데이터에 대해 평균해야 한다. 이 평균 계산은 결합 계수가 무작위로 뽑히는 스핀 계에서 ln Z의 평균을 구하는 문제와 모양이 같다. 이 계산에 이르려면 다음 물음들을 차례로 풀어야 한다.
- 데이터를 뽑을 때마다 달라지는 문제인데, 왜 입력이 많아지면 외울 수 있는지가 거의 하나로 정해질까?
- 무작위로 뽑히는 것이 섞인 계에서 평균은 어떤 순서로 내야 실제로 만나는 계 하나를 알려 줄까?
- 로그의 평균은 직접 계산하기 어려운데, 어떻게 구할까?
- 결합이 무작위인 스핀들은 낮은 온도에서 어떤 모습으로 굳을까?
- 홉필드 네트워크는 패턴을 몇 개까지 기억하고, 퍼셉트론의 경계는 왜 하필 입력 수의 2배일까?
굳은 무질서: 한 번 뽑히면 그대로인 무작위성
장 첫머리의 퍼셉트론에는 무작위로 정해지는 것이 두 가지 있다. 하나는 문제를 낼 때 한 번 뽑고 나면 학습하는 동안 바뀌지 않는 입력과 라벨이고, 다른 하나는 그 라벨을 맞히려고 찾는 가중치로 학습하는 내내 움직인다. 외울 수 있는지가 데이터를 뽑을 때마다 달라진 것은 입력과 라벨의 무작위성 때문인데, 이렇게 성격이 다른 두 무작위성이 한 계에 섞여 있으면 평균은 어떻게 내야 할까? 퍼셉트론에서는 조건을 만족하는 가중치가 연속으로 퍼져 있어 그런 가중치들의 부피를 재기 어렵다. 그래서 상태가 ±1뿐이라 스핀 16개면 배치 65536개를 모두 세어 정확한 답을 낼 수 있고, 무작위성에 대한 평균까지 손으로 계산되는 스핀 계에서 먼저 살펴보자.
역사: 무작위 결합 모델
자성 없는 금속에 자성 원자를 조금 섞은 합금에서는 자성 원자가 박힌 자리가 합금을 만들 때 한 번 정해지고, 그 뒤로는 원자의 자석(스핀)이 아무리 뒤집혀도 그대로 남는다. 이론은 1975년에 두 논문으로 시작되었다. 에드워즈와 앤더슨은 실제 합금 대신 이웃한 스핀 쌍마다 평균 0인 정규분포에서 결합을 뽑는 모델을 세웠다. 같은 해 셰링턴과 커크패트릭은 모든 쌍을 무작위 결합으로 묶어 끝까지 풀릴 것 같은 모델을 만들었고, 이 모델은 두 사람의 이름을 따 셰링턴–커크패트릭 모델, 줄여서 SK 모델이라 부른다.
스핀 16개의 무작위 결합
스핀 16개의 모든 쌍 (i, j)를 결합 J_ij로 묶되, 결합은 평균 0, 분산 1/16인 정규분포에서 무작위로 뽑는다. 에너지는 E(s) = −Σ_(i<j) J_ij s_i s_j이므로 결합이 양수인 쌍은 같은 방향을, 음수인 쌍은 반대 방향을 좋아한다. 결합을 한 번 뽑으면 배치(configuration: 계를 이루는 것 하나하나의 상태를 빠짐없이 적은 목록, 곧 배치 공간의 한 점. 여기서는 스핀 16개가 저마다 +1인지 −1인지 적은 수 16개. ML의 미니배치와 다르다) 2¹⁶ = 65536개를 모두 더해 Z를 정확히 구할 수 있다. 결합을 300번 뽑아 스핀 하나당 ln Z를 평균한 값과, 평균 Z의 로그를 스핀 수로 나눈 값을 나란히 적으면 다음과 같다.
| 역온도 β | ln Z의 평균 (스핀 하나당) | 평균 Z의 로그 (스핀 하나당) | 결합 300개로 낸 평균 Z의 로그 |
|---|---|---|---|
| 0.5 | 0.751 | 0.752 | 0.751 |
| 2 | 1.430 | 1.631 | 1.611 |
| 3 | 2.029 | 2.803 | 2.496 |
가운데 칸은 샘플 없이 손으로 계산한 값이다. 볼츠만 인자는 쌍마다의 인자 e^(βJ_ij s_i s_j)의 곱이고 결합들은 서로 독립이므로, 평균도 쌍마다 따로 내면 된다. 분산이 σ²인 정규 변수 J에 대해 e^(cJ)의 평균은 e^(c²σ²/2)이므로 쌍 하나의 평균은 배치와 상관없이 e^(β²/(2N))이다.
스핀 하나당으로는 ln 2 + β²(N − 1)/(4N)이고, β = 3에서 2.803이다.
두 칸의 값이 갈리는 것은 결합과 스핀이 무작위성의 성격부터 다르기 때문이다. 스핀은 열평형에서 쉼 없이 뒤집히지만, 결합은 한 번 뽑히면 스핀이 움직이는 동안 그대로 있다. 결합처럼 계를 정하는 파라미터가 무작위로 뽑히되, 한 번 뽑히면 스핀이 움직이는 동안 바뀌지 않는 무작위성을 굳은 무질서 (스핀이 평형을 이루는 동안 굳어 있는 무작위 파라미터, quenched disorder)라 한다. 합금에서 자성 원자가 박힌 자리, 홉필드 네트워크에 저장한 패턴, 학습에 쓰는 데이터 샘플이 모두 굳은 무질서다. 이런 계에서는 평균을 두 가지 순서로 낼 수 있다. 결합마다 ln Z를 먼저 구한 뒤 결합에 대해 평균할 수도 있고(표의 둘째 칸), Z를 결합에 대해 먼저 평균한 뒤 로그를 씌울 수도 있다(셋째 칸). 어느 순서가 맞을까?
ML에서: 데이터는 굳은 무질서다
신경망 학습 이론에서 무작위로 뽑히는 것은 대개 데이터다. 데이터 샘플을 굳은 무질서로, 가중치나 뉴런의 상태를 스핀으로 보면 이 장의 계산이 그대로 옮겨 간다. 장 첫머리의 퍼셉트론에서는 입력과 라벨이 SK 모델 에너지 식의 결합 구실을, 가중치가 스핀 구실을 한다.
문제 1. 학습에서 굳어 있는 것과 움직이는 것
이미지 분류 신경망을 학습할 때 무작위로 정해지는 것이 여럿 있다. ① 학습 데이터로 뽑힌 이미지 5만 장 ② 가중치의 처음 값 ③ 에폭마다 새로 섞는 미니배치 순서 ④ 드롭아웃(학습 스텝마다 뉴런 일부를 무작위로 끄는 기법)이 끄는 뉴런. (가) 학습하는 동안 그대로인 것과 스텝마다 바뀌는 것을 가르라. (나) 스핀 16개의 계에서 결합 Jᵢⱼ의 자리에 서는 것, 곧 손실 함수의 모양을 정하는 것은 어느 것인가?

학습 내내 그대로인 건 ①하고 ②예요. 처음 값도 한 번 뽑으면 끝이니까요. ③과 ④는 스텝마다 바뀌고요. 그러니까 결합 자리에 서는 건 ①과 ②죠.

③도 한 에폭 안에서는 순서가 정해져 있잖아. 그럼 에폭 하나 동안은 ③도 굳어 있는 거 아니야?

하나씩 따져 봐요. 민준 학생, 가중치의 처음 값을 다른 걸로 뽑으면 손실 함수의 모양이 바뀌나요?

아… 손실은 데이터와 모델 구조로 정해지니까 그대로예요. 처음 값은 그 지형 위 어디서 출발하느냐만 바꾸네요. 스핀 계로 치면 결합이 아니라 스핀이 처음 놓인 배치예요.

서연 학생, 스핀 계에서 결합은 스핀이 평형에 이르는 동안 내내 그대로였죠. 학습 전체에 걸쳐 보면 ③은요?
에폭마다 바뀌니까 학습 전체로는 내내 흔들리는 쪽이네요. 스핀이 열 때문에 뒤집히듯 가중치를 흔드는 노이즈예요. ④도 같고요.

그럼 결합 자리에 서는 건 ① 하나네요. 같은 모델이라도 이미지 5만 장을 새로 뽑으면 지형이 바뀌고요.
그래요. 이 장의 계산을 어디로 옮기든, 무엇이 끝까지 굳어 있고 무엇이 움직이는지부터 가르면 돼요.

시험 범위는 학기 초에 정해지고, 제가 외운 내용은 밤마다 바뀌는 거랑 같네요. 시험 범위가 굳은 무질서고요.