굳힌 평균: 로그를 먼저, 평균은 나중에
스핀 16개의 무작위 결합에서 두 순서로 낸 평균은 역온도 3에서 2.029와 2.803으로 크게 달랐다. 실험실에서 재는 합금은 결합이 한 번 정해진 시료 하나이고, 우리가 학습에 쓰는 데이터도 한 번 뽑힌 샘플 하나다. 그렇다면 둘 가운데 어느 쪽이 결합을 한 번 뽑아 만든 실제 계를 알려 줄까? 스핀 계보다 익숙한 예부터 보자.
투자: 기대 자산과 전형적인 자산
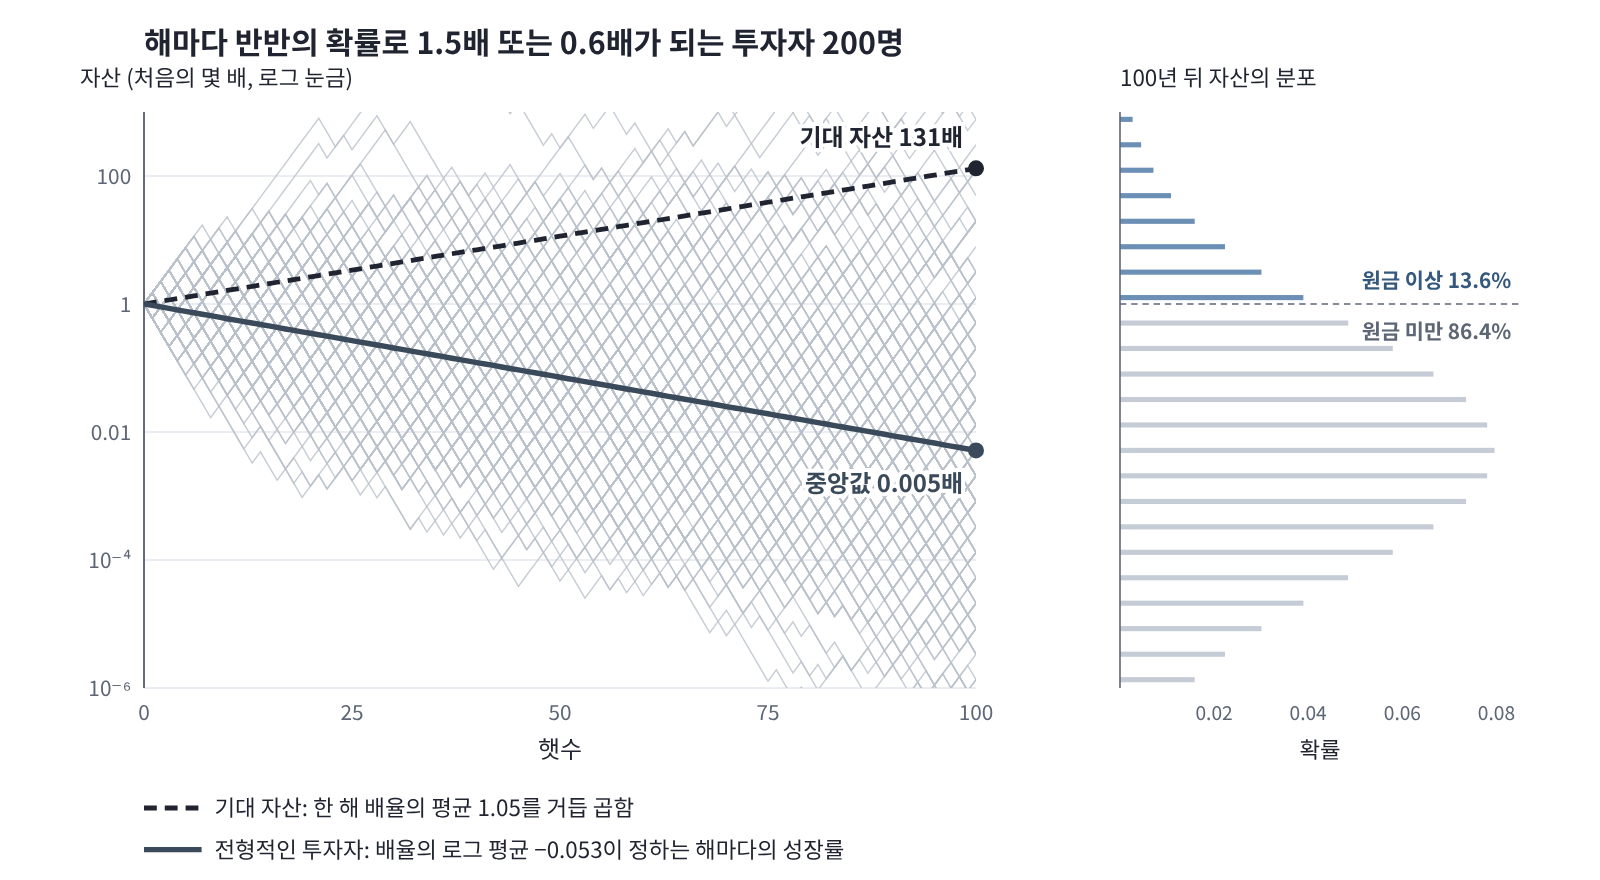
두 평균의 차이는 투자에서 쉽게 볼 수 있다. 해마다 자산이 반반의 확률로 1.5배나 0.6배가 되면 한 해 배율의 평균은 1.05라 기대 자산은 해마다 5%씩 늘지만, 전형적인 투자자의 자산이 해마다 불어나는 비율은 배율의 로그 평균 (ln 1.5 + ln 0.6)/2 = −0.053이 정하므로 대부분은 해마다 약 5%씩 잃는다. 100년 뒤 기대 자산은 처음의 131배인데 중앙값은 0.005배다. 기대 자산은 운 좋은 극소수가 끌어올린 값이고, 전형적인 투자자를 알려 주는 것은 로그의 평균이다.
스핀 계의 두 평균
스핀 계로 돌아가면, 두 순서로 낸 평균 사이에는 늘 부등식이 선다. 로그가 위로 볼록하므로 로그를 먼저 씌워 평균한 값은 평균에 로그를 씌운 값보다 클 수 없다.
왼쪽을 굳힌 평균 (결합을 한 번 뽑아 굳힌 계마다 ln Z를 구하고 그 값을 결합에 대해 평균한 것, quenched average)이라 하고, 물리 문헌에서는 담금질(quench, 달군 금속을 급히 식혀 굳히기)에서 따와 담금질 평균이라고도 옮긴다. 오른쪽처럼 결합까지 스핀과 함께 열평형에 드는 변수로 풀어 두고 Z를 먼저 평균한 뒤 로그를 씌운 것은 풀린 평균(annealed average)이라 부른다. 투자에서 기대 자산이 풀린 평균에, 로그의 평균이 정하는 전형적인 자산이 굳힌 평균에 해당한다. 실제로 관찰하는 것은 결합이 고정된 계 하나이므로 물리적인 값은 굳힌 평균이고, 풀린 평균은 계산하기 쉬운 상한이다.
역사: 굳은 불순물은 로그부터
로그를 먼저 씌워야 한다는 생각은 스핀 글래스보다 오래되었다. 1950년대 말 브라우트는 고체 속에 무작위로 박힌 불순물을 다루면서 두 경우를 갈랐다. 불순물도 늘 열평형에 드는 경우라면 분배함수를 먼저 평균하면 된다. 그러나 우리가 알고 싶은 것은 불순물이 제자리에 굳은 시료 하나의 자유에너지이므로, 열평형에 있는 스핀에 대한 합으로 분배함수를 먼저 구하고 그 로그를 불순물의 배치에 대해 평균해야 한다고 그는 적었다. 무엇을 계산해야 하는지는 이렇게 일찍 분명해졌지만, 로그의 평균을 실제로 계산하는 방법은 오래 막혀 있었다.
계 하나가 평균을 대신한다
그런데 굳힌 평균도 결국 결합에 대한 평균이고, 우리가 관찰하는 것은 결합을 한 번 뽑아 고정한 계 하나다. 그 계 하나에서 잰 값이 굳힌 평균과 가까우리라고 믿어도 될까?
스핀이 많아지면 결합을 한 번만 뽑아도 스핀 하나당 ln Z가 거의 늘 그 평균값에 가까워진다. β = 2에서 스핀 하나당 ln Z의 표준편차는 스핀 8·12·16·20개일 때 0.178·0.137·0.117·0.103으로 줄지만, Z 자체의 상대 표준편차는 줄지 않는다. 이처럼 계 하나에서 잰 값이 계가 커질수록 무질서에 대한 평균으로 모이는 성질을 자기 평균(self-averaging)이라 한다. 스핀 하나당 ln Z는 자기 평균이고 Z는 자기 평균이 아닌데, 투자에서 본 것과 같은 구조 때문이다. 스핀 하나당 ln Z는 결합의 우연이 스핀들 사이에서 서로 상쇄되어 평균 근처로 모이지만, Z는 그 값에 스핀 수를 곱해 지수로 올린 e^(N × 스핀 하나당 ln Z)라서, 스핀 하나당으로는 작은 표준편차가 N배로 불어나 지수에 들어간다. 로그 자산은 모이고 자산은 모이지 않던 것과 같다.
Z가 자기 평균이 아니라는 것은 스핀 16개의 표에서도 보인다. 결합 300개로 낸 평균 Z의 로그는 β = 3에서 2.496으로, 손으로 계산한 2.803에 한참 못 미쳤다. 표본 평균이 참값에 이르지 못하는 것은 평균 Z가 드물게 뽑히는 결합 몇 개에 좌우되기 때문이다. 결합을 2000번 뽑아 보면 β = 3에서 Z가 큰 순서로 상위 1%인 결합 20개가 Z 합계의 93%를 차지한다. 투자에서 기대 자산을 운 좋은 극소수가 끌어올린 것과 같은 모습이니, Z는 결합에 따라 얼마나 흔들릴까?
ML에서: 「어닐링」이라는 같은 이름
1983년 IBM에 있던 커크패트릭은 겔라트, 베키와 함께 무작위 결합 스핀 계의 시뮬레이션 방법을 컴퓨터 칩의 부품 자리 정하기 같은 최적화 문제에 옮겨 시뮬레이티드 어닐링(simulated annealing)을 만들었고, 온도를 천천히 내리며 분포를 옮기는 ML의 여러 절차가 이 이름을 물려받았다. 금속 가공에서는 급히 식혀 굳히는 것(quench)을 담금질, 천천히 식혀 푸는 것(anneal)을 풀림이라 부른다. ML에서는 온도나 노이즈 레벨을 천천히 바꾸는 절차를 어닐링이라 부르고, 어닐드 중요도 샘플링(annealed importance sampling)과 어닐드 랑주뱅이 그 예다. 그 어닐링은 분포를 옮기는 절차의 이름이고, 여기의 굳힌 평균(quenched average)과 풀린 평균(annealed average)은 무질서에 대해 평균을 내는 순서의 이름이다. 영어로는 같은 anneal 에서 왔지만 두 이름이 섞이지 않도록, 이 장은 평균의 이름에 역할이 드러나는 「굳힌」과 「풀린」을 쓴다.
ML에서: 입력이 많을수록 날카로워지는 경계
장 첫머리에서 입력이 100개일 때는 P/N = 1.8에서 외워질 확률이 0.933, 2.2에서 0.088이었지만, 입력이 400개이면 0.999와 0.003이었다. 외울 수 있는지는 데이터를 뽑을 때마다 달라지는 운의 문제인데, 입력이 많아질수록 무작위 데이터 하나로 얻은 답이 평균적인 답과 같아진다. 외우기의 경계가 데이터 샘플 하나가 아니라 무작위 데이터 전체의 성질로 정해지는 것은 자기 평균 덕분이다.
문제 2. 기대 수익 20%짜리 투자
해마다 자산이 반반의 확률로 2배가 되거나 0.4배가 되는 투자가 있다. (가) 한 해 배율의 평균과, 배율의 로그 평균이 정하는 전형적인 한 해 배율을 구하라. (나) 10년 뒤 기대 자산과 중앙값은 처음의 몇 배인가? (다) 이 투자를 한 사람 가운데 10년 뒤 원금 이상을 가진 사람의 비율은 얼마이고, 기대 자산은 누가 만드는가?

평균 배율이 (2 + 0.4)/2 = 1.2니까 해마다 20%씩 버는 투자예요. 10년이면 1.2¹⁰ ≈ 6.19배고요. 무조건 해야죠.

로그 평균은 (ln 2 + ln 0.4)/2 = −0.112야. 전형적인 한 해 배율이 e^(−0.112) ≈ 0.894라서 해마다 10%쯤 잃어.

10년 동안 다섯 번 2배, 다섯 번 0.4배가 된 사람은 얼마를 갖고 있죠?
2⁵ × 0.4⁵ = 0.8⁵ ≈ 0.328배요. 3분의 1로 줄었네요. 이게 중앙값이라고요? 기대 자산은 6.19배인데요.
원금 이상이 되려면 2배가 몇 번 나와야 하지? 다섯 번이면 0.328배였으니까… 열 번 가운데 여섯 번 이상이네.

그럼 이항계수로 더하면 (210 + 120 + 45 + 10 + 1)/1024 ≈ 37.7%야.
열 명 가운데 여섯 명은 손해를 보는 거네.

그럼 6.19배라는 기대 자산은 누가 만들었을까요?
열 번 다 2배가 된 사람은 1024배예요. 1024명 가운데 한 명이요. 2배가 여덟 번 이상 나온 5.5%가 기대 자산의 78%를 만들어요. 평균은 그 사람들이 끌어올린 거네요.
기대 자산이 풀린 평균 자리고, 로그의 평균이 굳힌 평균 자리네.
문제 3. 시험 문장 네 개의 로그 확률
언어 모델에게 시험 문장 네 개를 보여 주었더니, 모델이 매긴 문장 확률의 로그가 −20, −30, −40, −50이었다. (가) 문장마다 로그 확률을 먼저 구해 평균한 값과, 확률을 먼저 평균한 뒤 로그를 씌운 값을 구하라. (나) 이 모델이 전형적인 문장에 매기는 로그 확률은 어느 쪽인가? 시험 문장이 1000개라면 뒤의 값은 무엇에 끌려가는가?

확률을 평균한 다음 로그를 씌웠어요. ln((e⁻²⁰ + e⁻³⁰ + e⁻⁴⁰ + e⁻⁵⁰)/4) = −21.39예요. 평균 확률의 로그니까 이게 전형적인 값이죠.
로그를 먼저 평균하면 −35야. 14 가까이 차이가 나는데, 네 값은 −20에서 ln 4 = 1.39를 뺀 것과 거의 같아.
민준 학생 값에 둘째, 셋째, 넷째 문장은 얼마나 보태졌죠?
e⁻³⁰은 e⁻²⁰의 e⁻¹⁰ ≈ 0.00005배라… 거의 안 보태졌어요. 첫 문장 하나가 다 정했네요.
문장이 1000개면 확률이 가장 높은 한 문장의 로그 확률에서 ln 1000 ≈ 6.9를 뺀 값 근처가 되겠다. 나머지 999개는 거의 보이지 않고.
모델을 평가할 때 문장마다 손실을 구해 평균하죠. 그 손실은 어느 쪽이었나요?

문장마다 음의 로그 확률을 먼저 구하고 평균하는 크로스 엔트로피요. 로그를 먼저 씌우는 쪽이었네요. 아까 투자에서 로그 평균이 전형적인 사람을 알려 준 거랑 같아요.