15장 — 브라운 운동, 랑주뱅, 포커–플랑크
이 장의 물음
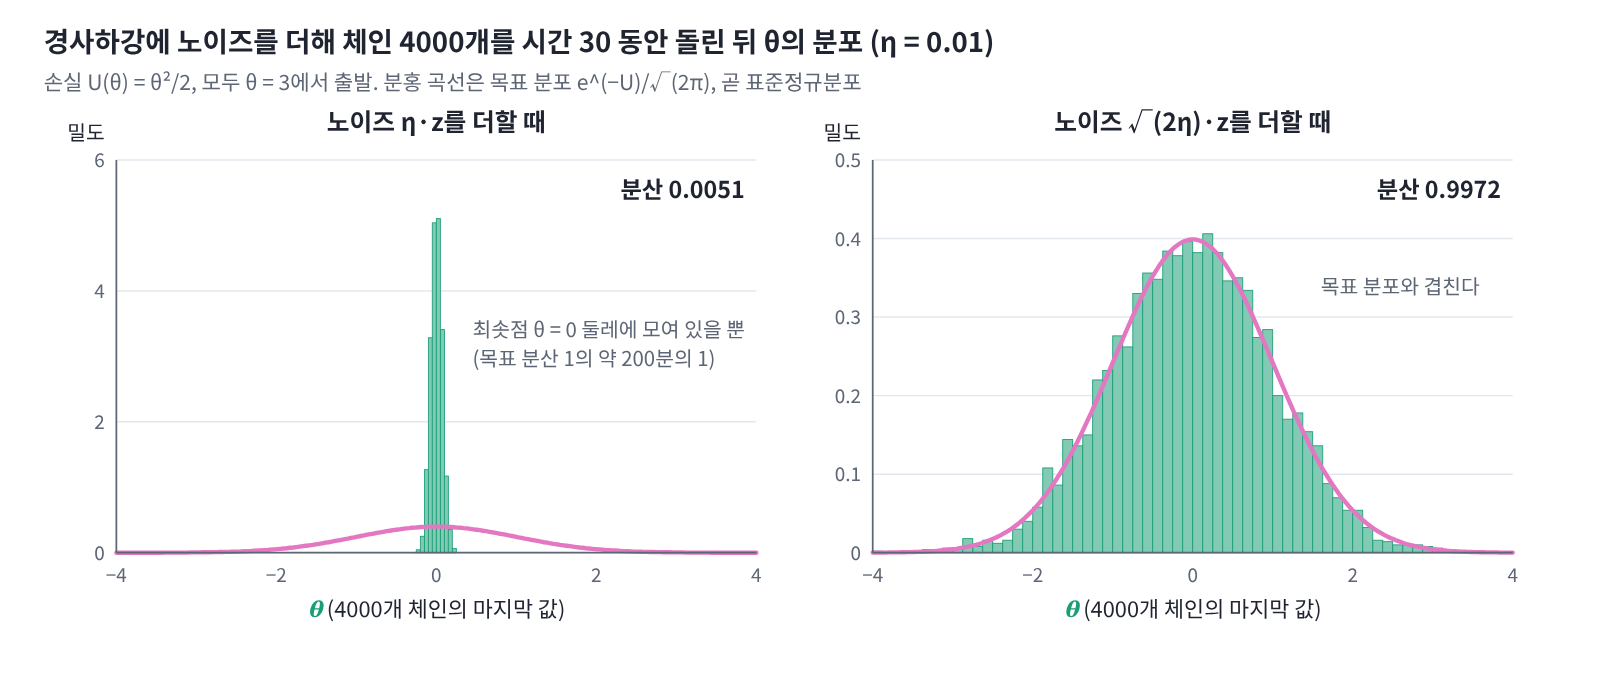
경사하강에 노이즈를 조금 섞으면 이상한 일이 생긴다. 손실 U(θ) = θ²/2를 θ = 3에서 출발해 학습률 η(에타) = 0.01로 경사하강하면 θ는 손실이 가장 낮은 점 θ = 0으로 모여들어 멈춘다. 한 스텝마다 표준정규 노이즈에 η를 곱해 더하면 θ는 0 둘레에서 조금 흔들릴 뿐이고, 마르코프 체인(따로 돌리는 샘플러 하나) 4000개로 재 보면 그 분산은 0.0051이다. 그런데 노이즈에 η 대신 √(2η)를 곱하면 θ가 퍼지는 폭이 갑자기 커져 분산이 0.997이 되고, θ의 값들을 모으면 표준정규분포, 곧 e^(−U)에 비례하는 분포가 나온다. 학습률을 0.1로 바꿔 보면 차이가 더 분명하다. η를 곱한 노이즈에서는 분산이 0.052로 학습률을 따라 변하지만, √(2η)를 곱한 노이즈에서는 1.04로 거의 바뀌지 않는다. 웰링과 테(2011)는 학습률과 상관없이 e^(−U)에 비례하는 분포에 이르는 이 성질을 큰 데이터의 베이즈 학습에 썼고, 논문 요약에 「표준적인 확률적 경사 최적화 알고리즘에 알맞은 양의 노이즈를 더하면, 스텝 크기를 줄여 갈 때 반복값들이 참 사후분포의 샘플로 수렴함을 보인다」고 적었다. 이 방법이 SGLD(stochastic gradient Langevin dynamics)다.
디퓨전 모델에서도 같은 모양이 나온다. DDPM(denoising diffusion probabilistic model, 호·자인·아빌 2020)은 한 단계마다 샘플에 √(1 − ε)를 곱하고 표준편차 √ε인 노이즈를 더한다(논문의 기호는 β이지만 역온도 β와 겹치므로 이 장에서는 ε로 쓴다). ε가 작으면 √(1 − ε) ≈ 1 − ε/2이므로, 이 단계는 U(x) = |x|²/2를 스텝 크기 ε/2로 경사하강하면서 노이즈 √(2 × ε/2)를 더하는 것과 같다. 분산을 끝없이 키우는 분산 폭발형과 달리 샘플을 원점 쪽으로 조금씩 당기므로, ε를 10⁻⁴에서 0.02까지 늘려 가며 1000단계를 지나면 원래 이미지는 0.0064배만 남고 분포는 데이터와 상관없이 거의 표준정규분포가 된다. 두 경우 모두 「에너지의 내리막으로 η만큼 가고, √(2η)만큼 흔든다」는 규칙을 쓰고, 도착하는 분포는 e^(−에너지)에 비례한다. 노이즈는 왜 스텝의 제곱근만큼이어야 하고, 이 규칙은 왜 하필 볼츠만 분포에 도착할까?
이 물음에 답하려면 몇 가지를 차례로 알아야 한다.
- 노이즈를 조금씩 더해 가는 샘플 하나는 어떤 길을 걷고, 그 경로의 속도는 얼마라고 말할 수 있을까?
- 그런 샘플을 아주 많이 모으면, 그 분포는 어떤 규칙에 따라 바뀔까?
- 내리막으로 끄는 힘과 노이즈가 함께 있을 때 분포는 어디에 도착하고, 노이즈의 크기는 그 도착점을 어떻게 정할까?
- 끌려가는 흐름과 퍼지는 흐름이 맞서는 골짜기가 여럿이면, 샘플은 골짜기 사이를 얼마 만에 건너갈까?
- 모멘텀을 쓰는 경사하강처럼 샘플이 운동량(물리량 p. 최적화 기법인 모멘텀과 영어 이름 momentum이 같다)을 가지면, 노이즈는 얼마나 넣어야 할까?
랜덤 워크: 동전으로 걷는 사람들의 분포
이 장 첫머리의 두 규칙(노이즈 섞은 경사하강 SGLD와 DDPM의 한 단계)은 모두 샘플에 노이즈를 조금씩 더해 간다. 내리막으로 끄는 힘은 잠시 빼고, 노이즈만 더해 가는 가장 단순한 경우부터 보자. 노이즈를 한 번씩 더할 때마다 샘플 하나는 어디로 가고, 그런 샘플을 아주 많이 모으면 그 분포는 어떤 규칙에 따라 바뀔까?
역사: 피어슨의 편지
1905년 여름 통계학자 칼 피어슨은 모기가 개간한 숲으로 무작위로 퍼져 들어가는 모습을 셈으로 다루려다 『네이처』에 편지를 보내, 한 사람이 일정한 거리를 곧게 걷고 아무 방향으로나 돌아 다시 같은 거리를 걷기를 n번 되풀이할 때 출발점에서 얼마나 떨어져 있을지를 물으며 이것을 「랜덤 워크」라 불렀다. 레일리 경이 곧 답을 보내, 이 물음이 크기가 같고 위상이 제멋대로인 소리 n개를 겹치는 문제와 같다고 짚었다. 피어슨은 그 답을 받아 들고 「트인 들판에서 제 발로 설 수 있는 술 취한 사람을 찾으려면 출발점 근처가 가장 가능성 높은 곳」이라는 교훈을 적었다.
동전을 던져 격자 위를 걷기
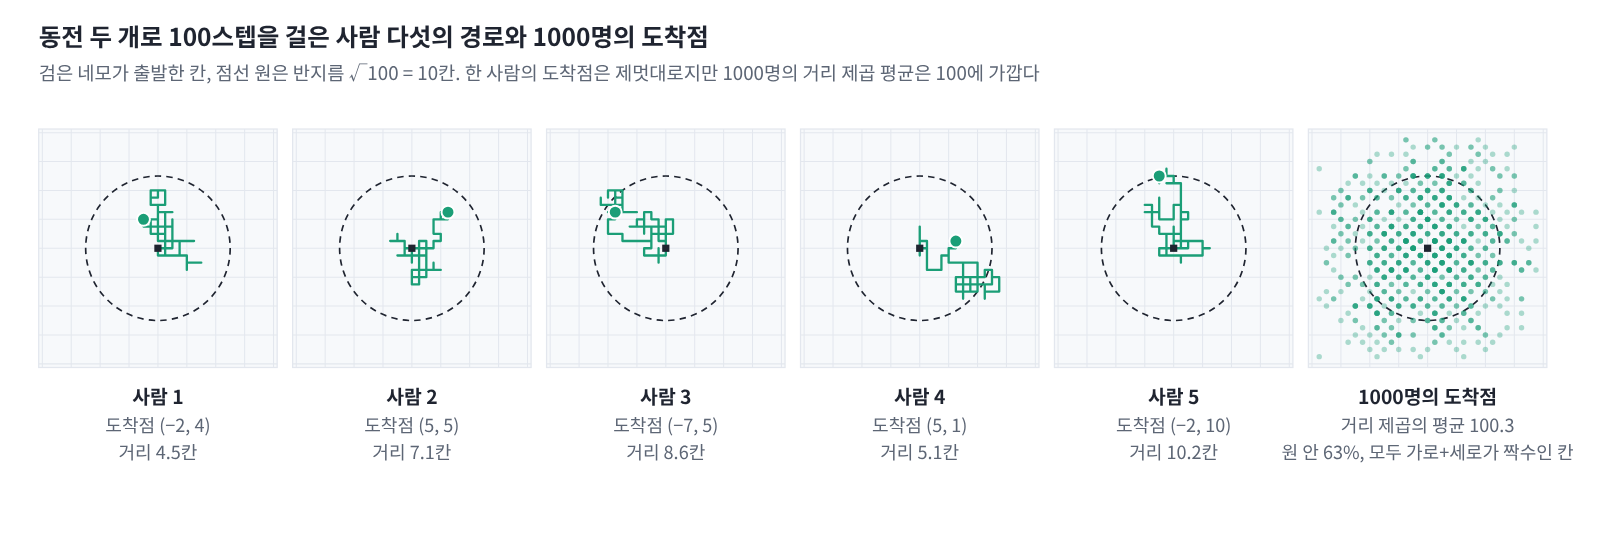
정사각 격자의 한가운데 칸에 100만 명이 서 있다. 신호가 울릴 때마다 모든 사람이 동전 두 개를 던져 위, 아래, 왼쪽, 오른쪽 가운데 하나를 똑같은 확률 1/4로 고르고 그쪽으로 한 칸 옮겨 간다. 사람마다 동전을 따로 던지므로 같은 칸에서 출발해도 곧 흩어진다.
이처럼 스텝마다 따로 뽑은 무작위 이동을 더해 가는 과정을 랜덤 워크 (random walk)라 한다.
한 사람의 경로는 제멋대로다. 왼쪽으로 세 번 연달아 갔다가 오른쪽으로 두 번 돌아오기도 하고, 100스텝 뒤에 출발점에 서 있기도 하고 15칸 떨어진 곳에 가 있기도 하다. 그러나 100만 명을 모아 보면 규칙이 보인다. n스텝 뒤 출발점에서 떨어진 거리 제곱의 평균과, 출발점에 서 있는 사람의 비율, 출발점에서 가로로 10칸 떨어진 칸 (10, 0)에 서 있는 사람의 비율을 재어 보자. 옆에는 한가운데 칸에만 1을 두고 모든 칸을 동시에 이웃 넷의 평균으로 바꾸기를 n번 되풀이했을 때 칸 (0, 0)과 칸 (10, 0)에 남는 값을 나란히 적었다.
| 스텝 수 n | 거리 제곱의 평균 | 원점에 선 비율 | 이웃 평균: 원점 | (10, 0)에 선 비율 | 이웃 평균: (10, 0) |
|---|---|---|---|---|---|
| 99 | 99.07 | 0 | 0 | 0 | 0 |
| 100 | 100.10 | 0.00622 | 0.00633 | 0.00228 | 0.00235 |
| 400 | 400.00 | 0.00161 | 0.00159 | 0.00117 | 0.00124 |
표를 읽으면, 첫째로 거리 제곱의 평균이 스텝 수와 거의 같다. 100스텝 동안 한 칸씩 쉬지 않고 움직였는데도 출발점에서 떨어진 거리는 평균적으로 √100 = 10칸 남짓이다. 둘째, 사람들의 비율이 이웃 평균을 되풀이한 값과 소수 넷째 자리에서만 조금 다를 뿐 거의 같다. 한 사람 한 사람은 동전에 따라 제멋대로 걸었을 뿐, 누구도 이웃과 평균을 내지 않았는데 말이다. 셋째, 99스텝 뒤에는 원점에도 (10, 0)에도 아무도 없다. 한 스텝마다 가로와 세로 칸 번호의 합이 1씩 바뀌어 홀짝이 뒤집히므로, 홀수 스텝 뒤에는 모두 그 합이 홀수인 칸에 서 있다. 이웃 평균의 값도 99번째에는 두 칸 모두 0이다.
그렇다면 한 사람의 랜덤 워크와 모든 칸의 동시 평균은 무슨 관계일까?
사람들의 분포는 이웃 평균을 따른다
n + 1스텝 뒤 어떤 사람이 칸 x에 서 있으려면, n스텝 뒤 x의 이웃 네 칸 가운데 하나에 서 있다가 x 쪽을 가리키는 동전이 나와야 한다. 그 동전이 나올 확률은 1/4이고 동전은 그 사람이 지금까지 어디를 걸어왔는지 기억하지 않으므로, n + 1스텝 뒤 x에 있을 확률은 이웃 네 칸에 있을 확률에 각각 1/4을 곱해 더한 것이다.
오른쪽 식은 칸마다 이웃 넷의 평균을 내는 규칙과 같은 식이다. 한 사람이 서 있을 확률의 분포는 이웃 평균 규칙을 정확히 따르고, 100만 명의 비율은 그 확률을 샘플로 잰 것이어서 샘플 오차만큼만 다르다. 이웃 평균의 규칙은 거꾸로 보면 모든 칸이 제 값을 네 등분해 이웃 네 칸에 하나씩 나눠 주는 것과 같은데, 한 칸의 값을 그 칸에 서 있을 확률로 읽으면 이것은 「그 칸에 선 사람이 네 방향 가운데 하나로 한 칸 옮겨 간다」는 말과 같다. 값을 나눠 주는 결정론적 규칙과 한 사람의 랜덤 워크는 같은 것을 두 쪽에서 본 것이다.
거리 제곱은 왜 스텝 수와 같을까
거리 제곱의 평균이 스텝 수와 거의 같았던 이유도 한 사람의 랜덤 워크로 읽을 수 있다. n스텝 뒤 위치는 스텝 s₁, s₂, …, sₙ의 합이므로 거리의 제곱은 스텝마다의 제곱 |sᵢ|² = 1의 합 n에, 서로 다른 두 스텝의 곱 sᵢ·sⱼ의 합을 더한 것이다. 두 스텝은 서로 따로 던진 동전으로 정해지고 한 스텝의 평균 이동은 0이므로, 곱의 평균도 0이 되어 교차항이 모두 사라진다. 그래서 거리 제곱의 평균은 정확히 n이다. 여기서 쓴 것은 한 스텝의 평균 이동이 0이라는 것과 스텝들이 서로 독립이라는 것 두 가지뿐이다. 동전 대신 한 스텝에 정규분포를 따르는 변위를 쓰든 스텝 크기를 제멋대로 섞든, 평균이 0이고 서로 독립이면 분산이 스텝마다 더해진다.
ML에서: 샘플 하나와 분포 전체
디퓨전 모델을 학습하는 코드도 이 두 쪽을 오간다. 코드는 이미지 한 장에 노이즈를 한 번씩 더할 뿐이어서, 한 사람이 동전을 던져 한 칸씩 걷는 것과 같다. 가로세로 32픽셀짜리 컬러 이미지(CIFAR-10 데이터 모음의 이미지 한 장)는 픽셀마다 빨강·초록·파랑 세 값이 있어 숫자 32 × 32 × 3 = 3072개로 적힌다. 숫자마다 표준편차 0.1인 노이즈를 100번 더하면 숫자 하나가 얼마나 움직였는지는 제멋대로여서, 한 번 해 보니 −3.8에서 3.6까지 퍼졌다. 그러나 3072개를 모아 움직인 거리 제곱의 평균을 내면 이론값 100 × 0.1² = 1에서 크게 벗어나지 않고, 이렇게 더하기를 1000번 되풀이해도 그 평균은 1.000 둘레에서 표준편차 0.025만큼만 흔들렸다. 모델이 배워야 하는 것은 이런 이미지들을 모은 분포가 노이즈를 더할수록 어떻게 번져 가는지다. 한 장 한 장의 경로는 제멋대로여도, 모은 분포는 이웃 평균처럼 결정론적인 규칙을 따르기 때문에 배울 수 있다.
문제 1. 술 취한 사람은 언제 집에 닿을까
피어슨의 물음처럼 술 취한 사람이 한 스텝에 1 m씩, 격자를 따르지 않고 360° 아무 방향으로나 걷는다. 방향은 스텝마다 새로 정한다. (가) 100스텝 뒤 출발점에서 떨어진 거리의 제곱평균은 격자 위 동전 걷기와 같은가? (나) 집은 출발점에서 20 m 떨어져 있다. 떨어진 거리의 제곱평균제곱근이 20 m가 되려면 몇 스텝이 필요한가?

격자가 아니니까 다를 것 같아서 돌려 봤어요. 20만 명이 100스텝 걸었더니 거리 제곱의 평균이 100.2 m²예요. 격자랑 같네요.

스텝 하나의 길이 제곱이 1이고 방향이 제멋대로라 평균 이동이 0이잖아. 그 두 가지만 맞으면 격자든 아니든 교차항이 사라져.

(나)는요?

100스텝에 10 m니까 20 m면 200스텝이요.
스텝 수에 비례하는 건 거리가 아니라 거리의 제곱이야. 거리를 두 배로 하려면 거리 제곱은 네 배, 400스텝이 필요해.

아, 그렇네요. 400스텝으로 돌리니 제곱평균제곱근이 19.97 m예요. 두 배 멀리 가는 데 네 배 걸리는 거였어요.
그래서 피어슨의 말대로 술 취한 사람은 출발점 근처부터 찾는 게 낫죠.

조별 과제 회의가 매번 아무 쪽으로나 흘러가면, 안건에서 두 배 멀어지는 데 회의가 네 번 필요한 셈이네요.
문제 2. 스텝이 들쭉날쭉하거나 지난 스텝을 닮으면
격자 위의 사람이 스텝마다 네 방향 가운데 하나를 고른다. (가) 방향은 1/4씩 고르게 고르고, 한 스텝에 한 칸 또는 세 칸을 반반의 확률로 간다면 100스텝 뒤 거리 제곱의 평균은? (나) 이번에는 늘 한 칸씩 가되, 직전 스텝과 같은 방향을 확률 1/2로 다시 고르고 나머지 세 방향을 1/6씩 고른다면?
(가)는 한 스텝이 평균 두 칸이니까 2² × 100 = 400이요.

돌려 보면 501이야. 스텝마다 더해지는 건 스텝 길이 제곱의 평균이잖아. (1 + 9)/2 = 5니까 100스텝이면 500이지.
평균 스텝을 먼저 제곱해 버렸네요. 평균의 제곱이랑 제곱의 평균은 다르죠.
(나)는 스텝 길이가 늘 1이에요. 그럼 100이 나올까요?
평균 이동은 여전히 0인데… 두 스텝이 독립이 아니에요. 직전과 같은 방향이 1/2, 반대 방향이 1/6이니까 이웃한 두 스텝의 곱의 평균이 1/2 − 1/6 = 1/3이에요. 교차항이 사라지지 않아요.
돌려 보니 198이에요. 거의 두 배네요.

그래요. 스텝이 서로 닮으면 교차항이 남아서 더 빨리 퍼져요. 거리 제곱이 스텝 수와 같다는 결론은 평균 이동이 0이고 스텝들이 독립이라는 두 조건이 모두 있어야 서요.

서로 직교하는 벡터를 더할 때만 길이 제곱이 각 길이 제곱의 합이 되는 거랑 같네요. 직교가 깨지면 내적이 남고요.