상대적인 요동: 큰 계에서는 평균이면 충분하다
요동-응답 관계에 따르면 에너지의 분산은 열용량에 비례하고, 열용량은 입자 수에 비례해 커진다. 그렇다면 입자가 10²³개쯤 되는 물체의 에너지는 엄청나게 흔들려야 할 것 같은데도, 열역학은 왜 평균 에너지 하나만으로 이야기해도 될까?
입자 수와 에너지 요동
2준위 입자의 수를 바꿔 가며(βε = ln 2) 에너지의 평균, 분산, 표준편차를 계산한 표를 다시 보자.
| N | 평균 에너지 | 분산 | 표준편차 | 표준편차 / 평균 |
|---|---|---|---|---|
| 3 | 1 | 0.667 | 0.816 | 0.816 |
| 30 | 10 | 6.667 | 2.582 | 0.258 |
| 300 | 100 | 66.67 | 8.165 | 0.082 |
| 3000 | 1000 | 666.7 | 25.82 | 0.026 |
분산은 입자 수에 비례해 커지지만 평균도 입자 수에 비례하므로, 표준편차를 평균으로 나눈 상대 표준편차는 입자가 백 배 늘 때마다 10분의 1로 줄어든다.
에너지의 표준편차는 분배함수를 어림할 때도 나타난다. Z는 에너지 값마다의 비중 g·e^(−βE)를 모두 더한 합인데, 입자가 많으면 그 가운데 가장 큰 항 하나로 Z를 어림하곤 한다. 그렇게 어림하면 얼마나 틀릴까? 2준위 입자 N개에서 에너지 값마다 비중의 로그 ln g − βE를 매기고 그 가운데 가장 큰 값을 ln Z와 비교하면, 입자 수가 클 때 ln Z와 가장 큰 값의 차이는 ½ ln(2π × 분산)에 다가간다. N = 3000이면 분산이 666.7이므로 ½ ln(2π × 666.7) = 4.170이고, 이것은 ln Z = 1216.395와 가장 큰 항의 로그 1212.225의 차이와 소수 셋째 자리까지 같다. 가장 큰 항 근처에서 함께 더해지는 항들이 이루는 봉우리의 폭이 바로 에너지의 표준편차 √666.7 = 25.8이었던 것이다. 1216이 넘는 ln Z에서 4.17만 틀리기 때문에, 입자가 많을수록 가장 큰 항 하나로 어림해도 된다.
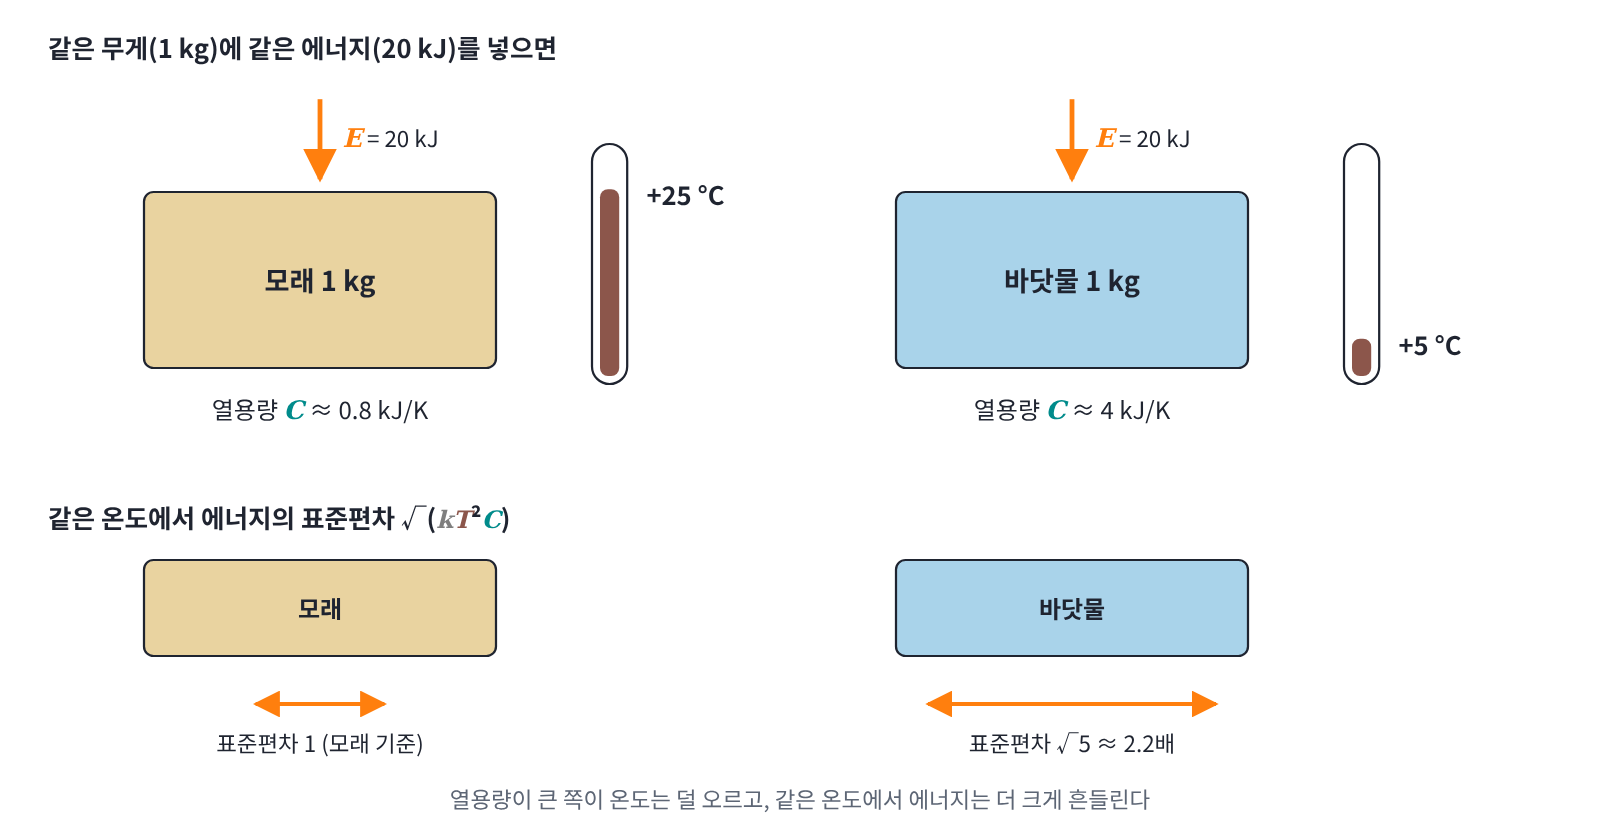
요동-응답 관계는 상대 표준편차가 왜 작은지도 설명한다. 열용량과 평균 에너지는 모두 계의 크기 N에 비례하므로 에너지의 표준편차 √(kT²C)는 √N에 비례하고, 표준편차를 평균으로 나눈 값은 1/√N으로 줄어든다. 표에서 입자가 백 배 늘 때마다 상대 표준편차가 10분의 1이 된 이유다. 입자가 10²³개쯤 되는 일상의 물체에서는 표준편차를 평균으로 나눈 값이 10⁻¹² 정도라서, 온도를 정하면 에너지도 사실상 하나의 값으로 정해진다. 열역학이 평균만으로 이야기해도 되는 근거가 여기 있다. 반대로 같은 온도에서 열용량이 큰 물체일수록 에너지의 표준편차 자체는 커서, 한낮의 바닷물은 모래보다 온도가 덜 오르는 대신 에너지가 더 크게 흔들리고 있다.
ML에서: 고차원 정규분포의 에너지
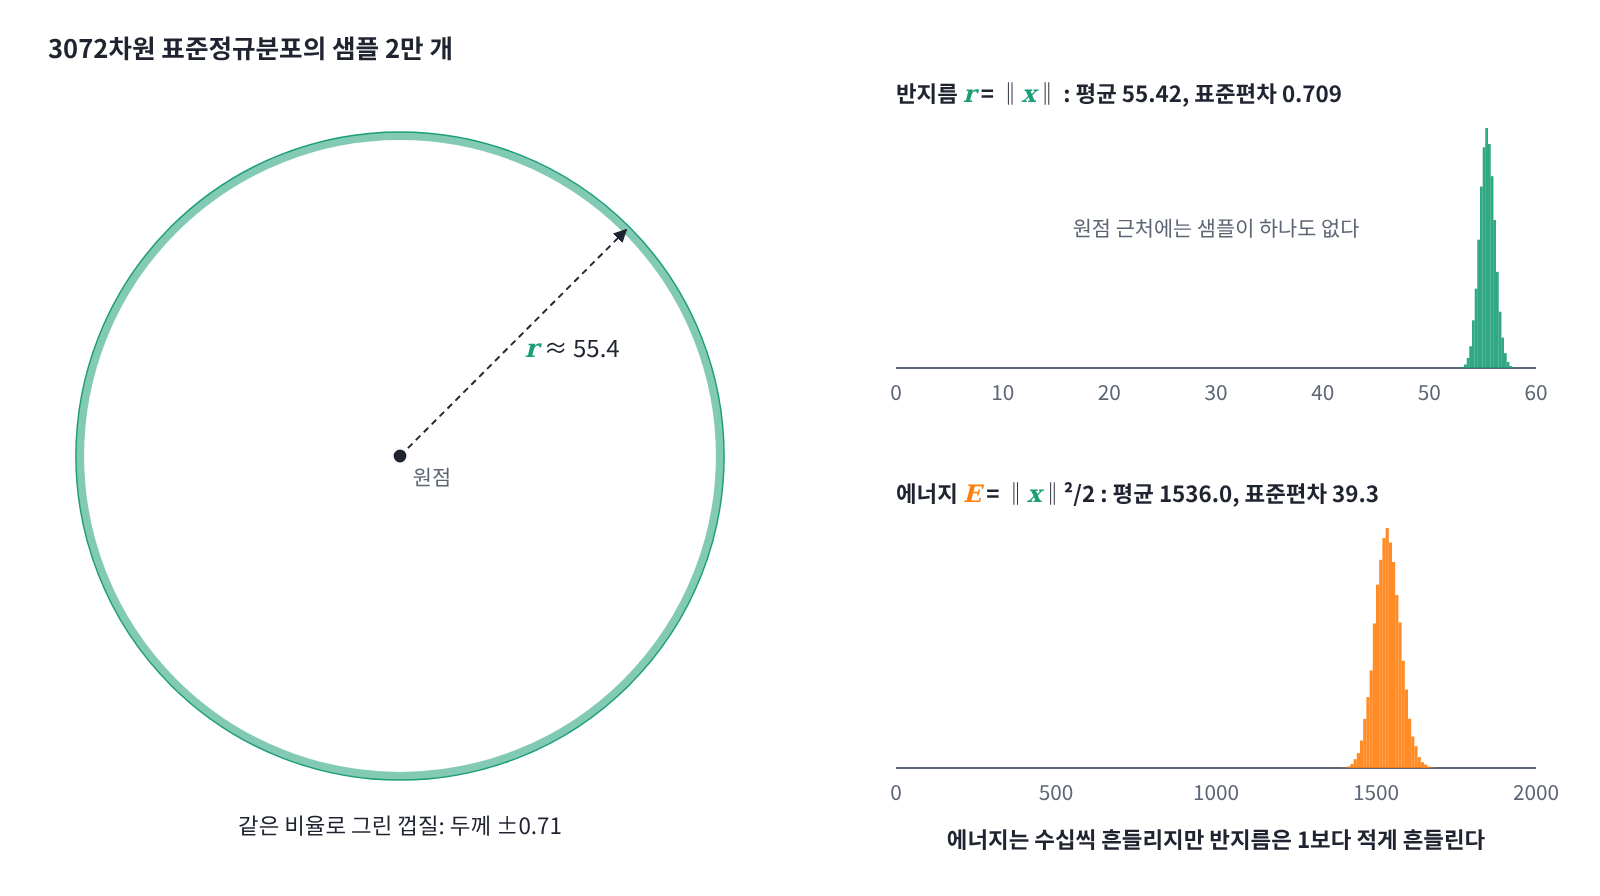
그렇다면 ML에서 입자 수가 큰 계는 무엇일까? 좌표 하나하나가 입자 노릇을 하는 고차원 정규분포가 그 예다. d차원 표준정규분포를 에너지 E = ‖x‖²/2, 온도 1인 볼츠만 분포로 보면 제곱 항 하나가 평균 에너지 ½kT를 받으므로 C = (d/2)k이고, 요동-응답 관계에 따라 에너지 분산은 kT²C = d/2다. 가로세로 32픽셀짜리 컬러 이미지 하나는 픽셀마다 빨강·초록·파랑 세 값이 있어 32 × 32 × 3 = 3072개의 숫자이고, 디퓨전 모델이 처음에 뽑는 노이즈도 같은 3072차원 표준정규분포에서 나온다. 이 3072차원이면 에너지의 표준편차가 √1536 = 39.2이니, 샘플의 에너지가 1536 근처에서 수십씩 흔들리는 것은 이 계의 열용량이 크다는 것과 같은 이야기다.
코드로 확인하기
3072차원 표준정규분포에서 샘플 2만 개를 뽑아 에너지와 반지름이 얼마나 흔들리는지 재 보자.
import torch
from math import sqrt

# d = 3072 표준정규분포: 에너지 ‖x‖²/2의 표준편차와 반지름 ‖x‖의 표준편차
torch.manual_seed(0)
d = 3072
x = torch.randn(20000, d, dtype=torch.float64)
E, r = 0.5 * (x ** 2).sum(1), x.norm(dim=1)
print(f"E: 평균 {E.mean():.1f}, 표준편차 {E.std():.2f} (예측 √(d/2) = {sqrt(d / 2):.2f})")
print(f"r: 평균 {r.mean():.3f} (√d = {sqrt(d):.3f}), 표준편차 {r.std():.4f} (예측 1/√2 = {1 / sqrt(2):.4f})")
# E: 평균 1536.0, 표준편차 39.31 (예측 √(d/2) = 39.19)
# r: 평균 55.421 (√d = 55.426), 표준편차 0.7091 (예측 1/√2 = 0.7071)
3072차원 정규분포에서는 에너지의 표준편차가 예측값 39.19와 샘플링 오차 안에서 맞고, 반지름의 표준편차는 0.709로 1/√2에 가깝다. 에너지는 수십씩 흔들리는데 반지름의 표준편차는 1보다 작은 이유는 아래 문제 5에서 따져 본다.
문제 5. 껍질의 두께
d차원 표준정규분포에서 에너지 E = ‖x‖²/2의 표준편차와 반지름 r = ‖x‖의 표준편차를 d = 2, 10, 100, 3072에서 구하라. 차원이 커지면 샘플이 모이는 껍질은 두꺼워지는가, 얇아지는가? (풀어 본 뒤 아래 위젯 3에서 d를 바꿔 가며 확인해 보자.)
에너지의 분산부터 볼게요. 제곱 항이 d개니까 열용량이 d/2이고, 온도가 1이니까 에너지 분산도 d/2예요.

표준편차로 바꾸면요?
√(d/2)라서 1, 2.24, 7.07, 39.2로 커져요. 차원이 커질수록 껍질이 두꺼워지는 거죠.
에이, 평균도 d/2로 커지잖아. 표준편차를 평균으로 나누면 1/√(d/2)로 줄어드니까 얇아지는 거지. 3072차원이면 2.6%밖에 안 돼.
너는 비율로 재고 나는 절대 크기로 잰 거잖아. 둘 다 맞는 말 아니야?

둘 다 에너지로 잰 이야기예요. 껍질은 반지름으로 정해지는 모양인데, 반지름으로 재면 어떻게 되죠?
E = r²/2니까 에너지가 조금 변하면 ΔE ≈ rΔr이에요. Δ는 작은 변화요. 그럼 Δr ≈ ΔE/r이고요.

ΔE와 r에는 각각 무엇을 넣으면 되죠?

ΔE는 에너지의 표준편차 √(d/2), r은 거의 √d이니까 Δr ≈ √(d/2)/√d = 1/√2… 차원이 안 남아요. 반지름의 표준편차는 차원과 상관없이 0.707이에요.
진짜? 코드에서 3072차원은 0.709였고, 나머지도 돌려 보면 d = 2에서 0.656, 10에서 0.693, 100에서 0.706이에요. 작은 차원에서만 조금 모자라고 금방 0.707에 붙네요. 고차원 샘플의 노름을 쟀을 때 본 「55.4 ± 0.71」의 0.71이 이거였구나.
그러니까 두께 자체는 차원과 상관없이 거의 그대로이고, 반지름이 √d로 커지니 반지름에 대한 비율로는 1/√(2d)로 얇아져요. 「두꺼워진다」와 「얇아진다」는 무엇을 자로 쓰느냐에 달린 말이었어요. 디퓨전 모델이 처음에 뽑는 3072차원 노이즈는 반지름 55.4짜리 구면에서 안팎으로 0.7쯤밖에 벗어나지 않아요.
에너지의 표준편차가 √d로 커지는 건 열용량이 차원에 비례하기 때문이고, 그걸 반지름으로 옮기면 √d끼리 약분돼서 상수가 남는 거네요.
너 아까 두꺼워진다고 자신 있게 말할 때부터 알아봤어. 뭐, 나도 반은 틀렸지만.
