크로스 엔트로피: 모델이 정답에 놀란 정도
분류와 언어 모델의 표준 손실에는 cross-entropy라는 이름이 붙어 있다. 앞에서 본 놀라움의 평균과는 어떤 관계이고, 이 loss는 왜 학습을 아무리 오래 해도 0까지 내려가지 않을까?
정답에 대한 놀라움
모델이 정답 y에 확률 q(y)를 주었다면 손실은 −ln q(y)로, 정답이 나왔을 때 모델이 얼마나 놀랐는지를 nat으로 잰 값이다. 이 손실 −ln q(y)를 데이터 분포 p에 대해 평균하면 크로스 엔트로피 (정답에 놀란 정도의 평균, cross-entropy)가 된다.
loss의 하한: KL 발산
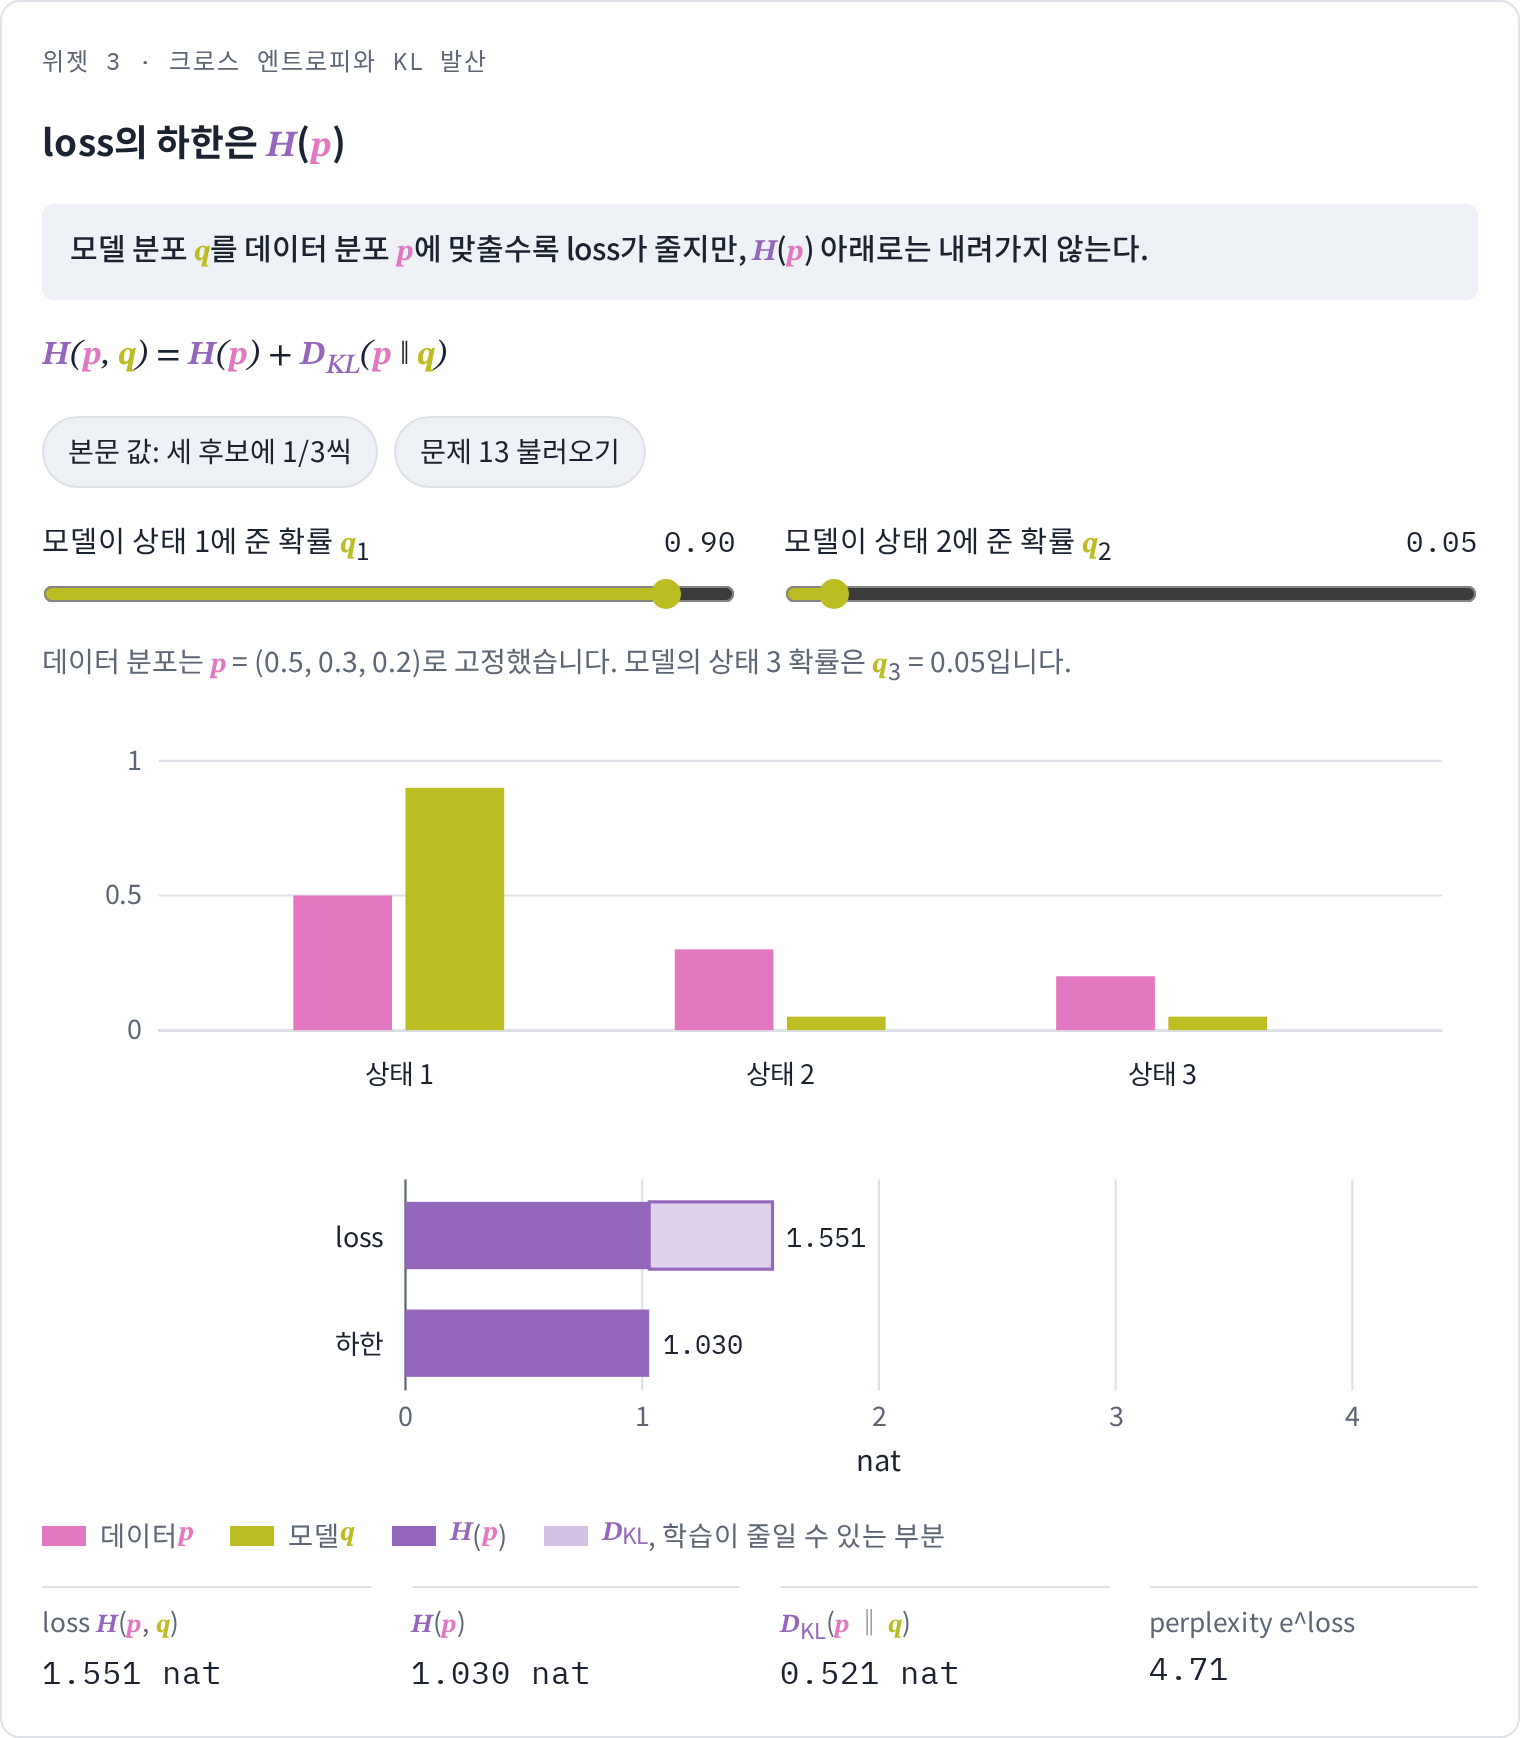
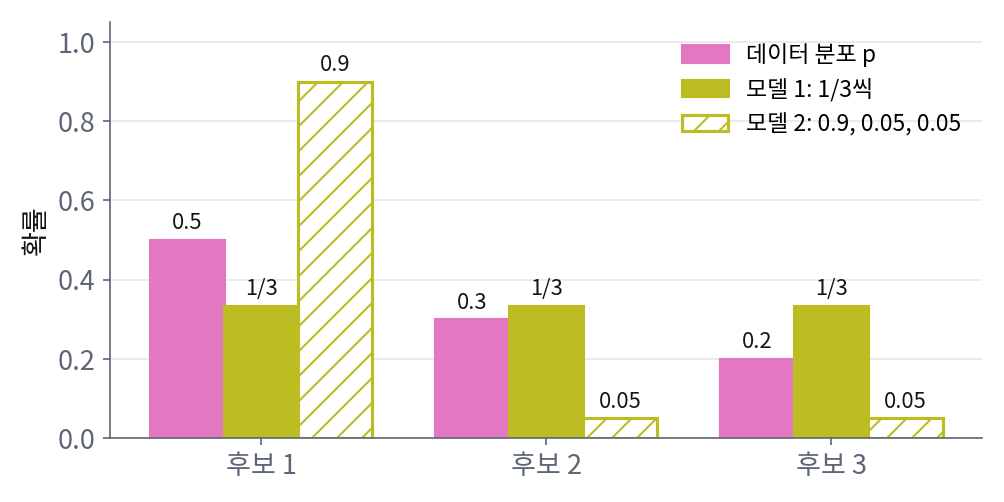
그렇다면 모델을 아무리 잘 학습시켜도 loss가 0이 되지 않는 이유는 무엇일까? 작은 예로 확인해 보자. 정답의 실제 분포가 p = (0.5, 0.3, 0.2)인데, 아직 아무것도 배우지 못한 모델이 세 후보에 1/3씩 준다고 하자. 그러면 loss는 ln 3 ≈ 1.099 nat이고, 그 가운데 1.030 nat은 데이터 자체의 엔트로피 H(p), 나머지 0.069 nat만 모델 탓이다.
이 나눔은 이 예에서만 생긴 우연이 아니다. 크로스 엔트로피는 언제나 모델과 상관없는 H(p)와 모델에 따라 달라지는 나머지 항의 합으로 나뉜다.

여기서 D_KL(p‖q)를 KL 발산(Kullback–Leibler divergence)이라 한다. D_KL는 글자를 곱한 것이 아니라 한 덩어리 이름이다. D는 발산(divergence)의, KL은 쿨백(Kullback)과 라이블러(Leibler) 두 사람 이름의 머리글자다. 괄호 안의 세로 두 줄 ‖은 두 분포를 가르는 표시로, 앞에 실제 분포를, 뒤에 믿은 분포를 두며, 두 자리를 바꾸면 값도 대개 달라진다. 뜻은 "실제 분포가 p인데 q라고 믿어서 추가로 당하는 놀라움"이다. KL 발산은 항상 0 이상이고, q = p일 때만 0이 된다.
왜 0 아래로는 내려가지 않을까? 위젯 3에서 q를 어떻게 움직여도 KL 값이 0 아래로 내려가지 않는 것은 로그의 성질 하나 때문인데, 곡선 ln u는 직선 u − 1보다 늘 아래에 있고 u = 1에서만 닿는다. u 자리에 q/p를 넣고 p로 평균하면 −D_KL = Σ p ln(q/p) ≤ Σ p(q/p − 1) = Σ q − Σ p = 1 − 1 = 0이다. 등호는 모든 후보에서 q/p = 1일 때, 곧 q = p일 때만 선다.
그러므로 loss의 하한(더 내려갈 수 없는 값)은 0이 아니라 H(p), 즉 데이터 자체의 엔트로피다. 학습이 줄일 수 있는 것은 KL 부분뿐이다.
역사: 아카이케와 기대 로그우도
데이터에 잘 맞는 모델을 고르는 일이 KL 발산을 줄이는 일이라는 다리는 모델의 크기를 정하는 고민에서 놓였다. 1960년대 말 일본 통계수리연구소의 아카이케 히로쓰구(Hirotugu Akaike)는 시멘트 회전 가마를 컴퓨터로 제어하는 공동 연구에서, 가마에서 잰 시계열의 다음 값을 바로 앞 값 몇 개의 가중합으로 예측하는 자기회귀 모델을 썼다. 앞 값을 몇 개까지 쓸지(차수)가 문제였다. 차수를 늘리면 가진 데이터에는 늘 더 잘 맞지만, 새로 들어올 데이터의 예측은 어느 차수부터 오히려 나빠진다. 1969년 그는 새 데이터에서의 예측 오차 제곱을 추정한 기준(최종 예측 오차, FPE)으로 차수를 골랐는데, 이 기준은 자기회귀 모델의 예측 오차에 맞춘 것이었다.
아카이케는 모델의 꼴에 매이지 않는 기준을 찾았다. 1971년 9월 소련 아르메니아의 차하조르에서 열린 제2회 국제 정보이론 심포지엄에서 그는 「고전적인 최대우도 원리는 매우 일반적인 정보이론적 기준에 대해 최적 추정을 점근적으로 실현하는 방법으로 볼 수 있다」고 발표했다(논문집은 1973년에 나왔다). 그가 내세운 기준은 새 데이터에서의 기대 로그우도, 이 절의 기호로 Σ p ln q였다. 기대 로그우도는 −H(p, q) = −H(p) − D_KL(p‖q)이므로, 기대 로그우도를 키우는 것은 참 분포에서 모델까지의 KL 발산을 줄이는 것과 같다. 이 KL 발산은 1951년 암호 기관의 수학자 쿨백과 라이블러가 두 가설을 가르는 평균 정보로 정의한 양이다. 가진 데이터로 잰 평균 로그우도는 기대 로그우도를 부풀려 추정하므로, 아카이케는 부풀린 만큼을 파라미터 수로 보정한 기준을 내놓고 처음에는 「an information criterion」이라 불렀다. 오늘날의 AIC다.
처음 유도는 가정이 강했다. 1976년 다케우치 게이(Kei Takeuchi)가 가정을 크게 늦춘 판을 냈지만 일본어로 나와 오래 알려지지 않았다.

차수를 고르는 거면 데이터를 떼어서 검증셋으로 재 보면 되잖아요. 수업 실습에서는 늘 그렇게 했는데요.

위 그림의 실험처럼 시계열이 길이 60뿐이라고 해 봐요. 그중 20개를 검증용으로 떼면 무슨 일이 생길까요?

맞추는 데 쓸 점이 줄어요. 차수 15짜리는 계수만 15개인데… 점이 모자라서 차수가 높은 모델일수록 손해를 보겠네요.

데이터를 떼면 재는 모델이 실제로 쓸 모델과 달라지는 거예요. 가진 데이터를 다 쓰면서 새 데이터에서의 성적을 알아내야 했어요.
그런데 가진 데이터에서는 차수를 올릴수록 점수가 계속 오르잖아요. 그 점수로는 고를 수가 없고요.
그래서 부풀려진 만큼을 파라미터 수로 깎았구나. 그런데 깎은 값이 새 데이터 점수를 따라간다는 건 어떻게 믿어요?
아카이케가 기준으로 삼은 건 새 데이터에서의 기대 로그우도였어요. 기대 로그우도가 크로스 엔트로피와 어떤 관계인지는 이 절에서 이미 봤죠.
기대 로그우도가 −H(p, q)라면, 최대우도로 학습하는 것도 D_KL(p‖q)를 줄이는 일이라고 말할 수 있어요?
ML에서: 최대우도 = 크로스 엔트로피 최소화
마지막으로 최대우도 학습과의 관계를 정리해 두자. 데이터의 log-likelihood를 최대화하는 것은 데이터에 대한 크로스 엔트로피를 최소화하는 것과 부호만 다를 뿐 같은 최적화 문제다. 게다가 H(p)는 모델과 상관없는 상수이므로, 최대우도 학습은 결국 D_KL(p‖q)를 줄이는 일이 된다.
문제 13. 확신이 넘치는 모델
정답의 실제 분포가 p = (0.5, 0.3, 0.2)다. 세 후보에 1/3씩 주는 모델과, 가장 흔한 첫 후보에 0.9, 나머지 둘에 0.05씩 주는 모델 가운데 어느 쪽의 크로스 엔트로피가 작은가? 둘째 모델의 KL 발산은 얼마인가? (풀어 본 뒤 위젯 3의 「문제 13 불러오기」로 확인해 보자.)
둘째가 낫죠. 가장 자주 나오는 답을 가장 높게 찍었으니까요.
계산해 보세요. 정답이 둘째나 셋째 후보일 때 둘째 모델은 얼마나 놀라죠?

−ln 0.05 ≈ 3.00 nat이요. 첫 후보일 때는 −ln 0.9 ≈ 0.11이고요. 둘을 그냥 평균하면 되나….
그 두 놀라움을 실제로는 얼마나 자주 겪죠?

아, 정답이 나오는 비율로 무게를 줘야겠네요. 0.5 × 0.11 + 0.3 × 3.00 + 0.2 × 3.00 ≈ 1.55 nat. 1/3씩 준 모델의 ln 3 ≈ 1.10보다 크네요.
H(p) ≈ 1.03을 빼면 KL은 약 0.52 nat이야. 균등한 모델의 KL 0.07보다 일곱 배 넘게 커. 0.05를 0까지 줄이면 −ln 0이라 loss가 끝없이 커지겠다.

맞아요. 크로스 엔트로피는 "드물다고 장담했는데 나온 답"을 무겁게 벌해요. 비 올 확률 0%라던 날 비가 오면, 30%라던 날 비가 온 것보다 그 예보를 훨씬 덜 믿게 되는 것과 같아요.
위젯 3에서 문제 13 설정을 불러와 loss가 데이터 엔트로피와 KL로 어떻게 나뉘는지 확인해 보세요.