perplexity: loss를 후보 수로 되돌려 읽기
학습 기록에는 loss가 숫자 하나로만 찍히는데, loss가 2.3 nat이라는 말은 모델이 얼마나 헷갈린다는 뜻일까? nat이라는 단위로는 감이 잘 오지 않으니, 엔트로피가 경우의 수의 로그였으니, 거꾸로 경우의 수로 되돌려 읽어 보자.
유효 경우의 수
볼츠만의 S = ln W를 거꾸로 풀면 W = e^S이다. 같은 방법으로 토큰당 loss를 후보 수로 되돌린 값을 perplexity (유효 후보 수, perplexity)라 부른다.
그래서 perplexity는 "모델이 매 토큰마다 몇 개의 후보 중에서 고르는 것처럼 헷갈리는가"로 읽을 수 있다.
| 상황 | 토큰당 loss (nat) | perplexity |
|---|---|---|
| 초기화 직후, 어휘 50,257개에 균등 | ln 50257 ≈ 10.8 | 50,257 |
| 학습 후 | 2.3 | 약 10 |
ML에서: 처음 loss로 버그 찾기
표의 첫 줄은 실무에서 유용한 점검 방법이 된다. GPT-2 어휘 크기의 모델을 막 초기화했을 때 처음 loss가 10.8 근처가 아니라면, 출력층 초기화나 라벨 처리에 문제가 있을 가능성이 크다.
문제 14. 날씨 예보 앱의 놀라움
날씨를 맑음, 흐림, 비, 눈 네 가지로만 적는 도시에서, 아무것도 모르는 예보는 네 가지에 1/4씩 준다. 어떤 예보 앱은 지난 한 달 동안 실제로 온 날씨에 준 확률 q로 잰 놀라움 −log₂ q의 평균이 1.2 bit였다. 두 예보는 각각 날씨 몇 가지 가운데 하나를 찍는 것만큼 헷갈리는가?
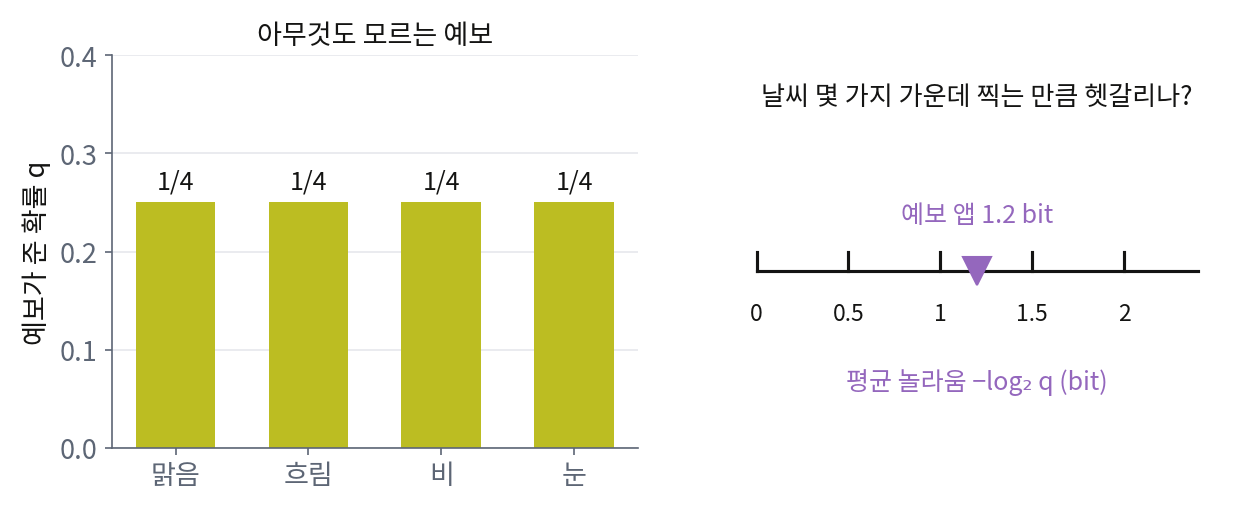

1/4씩 주면 놀라움이 매일 log₂ 4 = 2 bit니까 두 가지 중에 찍는 거고, 앱은 1.2가지 중에 찍는 거네요.
놀라움은 후보 수의 무엇이었죠?

로그요. 아, 후보 수로 되돌리려면 2를 거듭제곱해야 하네요. 균등한 예보는 2² = 4가지로 날씨 네 가지 그대로고, 앱은 2^1.2 ≈ 2.3가지예요.

맞아요. bit로 잰 평균 놀라움이 H면 2^H가 "실제로 몇 가지 중에서 헷갈리는가"예요. 날씨는 네 가지인데 앱 덕분에 2.3가지쯤으로 좁혀진 거예요.
수학 시간에 로그 눈금 그래프 읽을 때랑 같네요. 눈금 한 칸이 10배라서, 눈금 숫자를 그대로 읽으면 안 되고 되돌려 봐야 크기가 보여요.
문제 15. 언어 모델의 loss 읽기
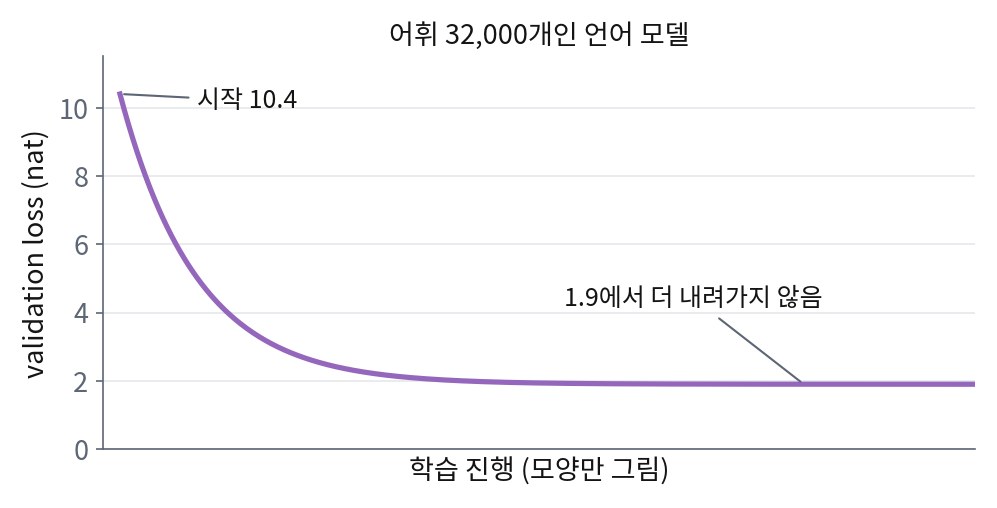
어휘가 32,000개인 언어 모델의 validation loss(PyTorch
cross_entropy, 토큰당 평균)가 10.4에서 시작해 1.9에서 더 내려가지 않는다. 각각의 perplexity를 구하고 의미를 설명하라.

문제 14(날씨 예보 앱의 놀라움)랑 같네요. perplexity는 2^loss니까 2^1.9 ≈ 3.7이에요.
날씨 문제의 놀라움은 bit였어요. PyTorch loss는 어느 단위였죠?
자연로그니까 nat이요. 아, 그럼 e^1.9 ≈ 6.7이에요.
거듭제곱의 밑은 로그의 밑과 같아야 해요. 2^loss는 loss를 bit로 잰 때만 맞아요. 시작값 10.4는요?
e^10.4 ≈ 33,000. 어휘 전체에서 골고루 찍는 거네요. ln 32000 ≈ 10.37이랑 거의 맞아요.

그래서 막 초기화한 모델의 첫 loss가 ln(어휘 크기) 근처인지 확인하는 건 좋은 습관이에요. 학습 후 perplexity 6.7은 "매 토큰마다 후보 일곱 개쯤 중에서 고르는 정도로 헷갈린다"는 뜻이고요. 볼츠만의 W를 거꾸로 계산한 것과 같아요.

저는 1.9에서 멈춘 게 이상해요. 모델이 충분히 크면 다음 토큰을 다 맞혀서 0까지 내려가야 하지 않아요? 버그 아닌가요?
"나는 오늘 점심으로 ___"의 빈칸을 생각해 봐요. 짜장면, 김밥, 샐러드… 어떤 모델도 하나로 확정할 수 없어요. 문장 자체에 불확실성이 있다는 뜻이에요. cross-entropy는 H(p) + D_KL(p‖q)이고, 학습이 줄일 수 있는 건 KL 부분뿐이에요. H(p)가 loss의 하한이에요.
그럼 학습 데이터를 통째로 외우면요?

train loss는 0에 가까워질 수 있어요. 하지만 그건 문장의 진짜 분포 p를 배운 게 아니라 그 문장들을 외운 거라서, 처음 보는 문장의 validation loss는 오히려 올라가요.
과제에서 train loss는 계속 내려가는데 val loss가 올라간 적 있어요. 오버피팅이라고 배웠는데, 엔트로피로 보니까 val loss가 왜 데이터의 엔트로피 밑으로는 못 내려가는지 알겠네요.