정보량: 맞히기 어려운 글자일수록 담긴 정보가 많다
섀넌은 영어 글자 하나가 평균 몇 비트를 알려 주는지 추정했지만, 글자마다 알려 주는 양은 제각각이었다. 그렇다면 글자 하나, 사건 하나가 알려 주는 양을 숫자 하나로 나타낼 수 있을까? 그리고 사건 하나에 붙인 숫자는 −Σ p log₂ p 안에 들어 있는 −log₂ p 한 항과 어떻게 이어질까?
사건 하나의 정보량
베티의 놀이를 받아 적는 쪽에서 보자. LIGH 다음의 T처럼 첫 추측에 맞힐 글자는 받는 사람도 이미 알고 있기 때문에 전화로 불러 줄 필요가 거의 없다. 반대로 새 단어의 첫 글자처럼 여러 번 틀린 글자는 따로 알려 주어야 한다. 그러니 글자 하나가 알려 주는 양은 그 글자가 얼마나 맞히기 어려웠는지, 곧 그 글자의 확률에 달려 있다.
글자 하나가 알려 주는 양을 숫자로 만들 때는 스무고개를 떠올리면 되는데, 똑같이 그럴듯한 후보가 8개 있으면 예/아니오 질문 3번으로 답을 찾는다. 확률이 1/8인 결과는 후보 8개 가운데 하나가 나온 것만큼 맞히기 어렵고, 어느 후보가 나왔는지 알리는 데는 예/아니오 답 3개가 든다. 그래서 확률 p인 일이 일어났을 때 얻는 정보량 (알리는 데 드는 예/아니오 답의 수, information content)을 다음과 같이 정한다. 단위 bit는 예/아니오 답 하나다.
| 사건 | 확률 | 정보량 |
|---|---|---|
| LIGH 다음의 T (확률을 0.99로 치면) | 0.99 | 0.01 bit |
| 동전 앞면 | 1/2 | 1 bit |
| 주사위 6 | 1/6 | 2.58 bit |
| 로또 1등 | 1/8,145,060 | 23.0 bit |
정보량은 흔히 놀라움(surprisal)이라고도 부른다. 거의 확실하던 일이 일어나면 놀라지 않고 드문 일이 일어나면 크게 놀란다는 느낌에서 붙은 이름이다. 하지만 이 책에서 "놀라움"은 느낌이 아니라 늘 정보량 −log₂ p, 다시 말해 "일어난 결과를 전해 듣는 사람이 새로 받아야 했던 예/아니오 답의 개수"를 가리킨다. 로또 1등의 23.0 bit는 "스무고개를 23번 해야 알아낼 만큼의 소식"이고, LIGH 다음의 T는 굳이 묻지 않아도 되는 소식이다.
엔트로피는 놀라움 −log₂ p의 평균이므로, 결과마다 놀라움과 확률을 곱해 더하면 다음과 같다.
섀넌이 추정한 "영어 글자 하나에 0.6~1.3비트"도 이 평균이다. 대부분의 글자는 거의 0비트이고 단어가 시작되는 몇 글자가 큰 값을 내는데, 그것을 모두 평균한 값이다.

ML에서: 언어 모델은 섀넌의 맞히기 놀이를 한다
베티가 한 일을 기계에게 시킨 언어 모델은 앞의 토큰들을 보고 다음 토큰마다 확률을 내놓는다. 실제로 온 토큰에 높은 확률을 주었다면 그 토큰은 모델에게 거의 0비트짜리 소식이고, 낮은 확률을 주었다면 큰 소식이다. 섀넌이 사람에게서 잰 "글자 하나에 몇 비트"를 모델에게서 재면, 그 모델이 글을 얼마나 잘 예측하는지 보여 주는 숫자가 된다.
섀넌은 1951년 논문에서 글을 잘 예측하는 만큼 그 글을 짧게 압축할 수 있다는 것도 보였다. 받는 쪽에 똑같이 추측하는 쌍둥이가 있다면, 글자 대신 "몇 번째 추측에 맞았는가"만 보내도 쌍둥이가 원래 글을 되살린다. 이 추측 순번은 대부분 1이라서 아주 짧게 줄어든다. 언어 모델로 글을 압축하는 오늘날의 방법도 같은 생각 위에 서 있어서, 모델이 잘 맞히는 글자에는 짧은 코드를, 못 맞히는 글자에는 긴 코드를 준다.
문제 11. 평균 질문 수
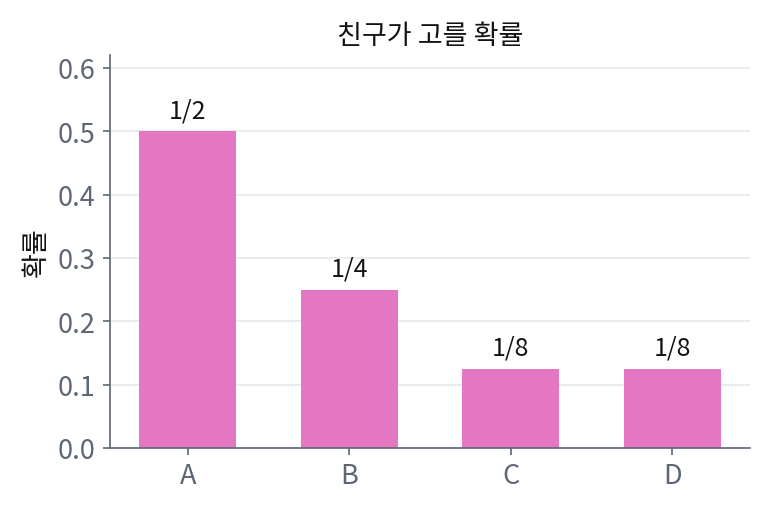
친구가 A, B, C, D 중 하나를 확률 1/2, 1/4, 1/8, 1/8로 골랐다. 예/아니오 질문으로 맞히려면 평균 몇 번이 필요한가?

후보가 4개니까 log₂ 4 = 2번.

확률이 다르잖아. 엔트로피를 계산하면 (1/2)·1 + (1/4)·2 + (1/8)·3 + (1/8)·3 = 1.75비트야. 근데 선생님, 질문은 정수 번만 할 수 있잖아요. 1.75번은 말이 안 되는 것 같은데요.

한 판에서는 정수지만, 여러 판을 하면 평균은 정수가 아닐 수 있어요. 질문 순서를 이렇게 정해 봐요. 먼저 “A야?” 아니면 “B야?” 그래도 아니면 “C야?”
A면 1번, B면 2번, C나 D면 3번. 평균은 0.5×1 + 0.25×2 + 0.125×3 + 0.125×3 = 1.75. 진짜 1.75번이네요.

자주 나오는 답을 먼저 물어보는 거예요. 이 방법이 2번보다 나은 건, 확률이 치우쳐 있다는 정보를 썼기 때문이에요. 엔트로피보다 평균 질문 수를 더 줄이는 방법은 없어요. 이게 섀넌이 증명한 압축의 한계예요.
모스 부호에서 자주 쓰는 영어 글자 E가 점 하나인 것도 같은 생각이에요?

같은 생각이에요. 자주 나오는 것에 짧은 코드를 주는 겁니다.
그런데 선생님, 이번엔 확률이 1/2, 1/4, 1/8처럼 딱 떨어져서 질문 수가 엔트로피와 같았던 거 아니에요? 확률이 0.5, 0.3, 0.2인 셋 중 하나를 맞히라면요?
직접 해 볼까요? 엔트로피는 몇 비트이고, 가장 좋은 질문 순서로는 평균 몇 번이죠?

엔트로피는 −Σ p log₂ p ≈ 1.485비트예요. 질문 순서는… 아까처럼 자주 나오는 것부터 물으면 될까요?
그렇게 해서 평균 몇 번인지 세어 보세요.
“첫째야?” 다음에 "둘째야?"로 하면 0.5 × 1 + 0.3 × 2 + 0.2 × 2 = 1.5번이요. 순서를 바꿔 봐도 이 셋으로는 이보다 줄일 수가 없는데, 엔트로피보다 조금 크네요.
한 판마다 정수 번씩 물어야 하니 확률이 2의 거듭제곱이 아니면 조금 남아요. 대신 여러 판을 묶어 한꺼번에 물으면 엔트로피보다 더 묻는 횟수가 줄어요. 세 판씩 묶으면 한 판에 1.496번, 네 판씩 묶으면 1.493번으로 1.485에 다가가요. 엔트로피는 한 판짜리 질문으로는 닿지 못할 수도 있지만, 묶음을 키우면 얼마든지 가까이 갈 수 있는 한계예요.
해석학의 하한(inf)도 꼭 닿는 값은 아니어도 얼마든지 가까이 갈 수 있는 값이었죠. 엔트로피가 평균 질문 수의 하한이고요.
문제 12. 문장 하나를 보내는 데 드는 비트
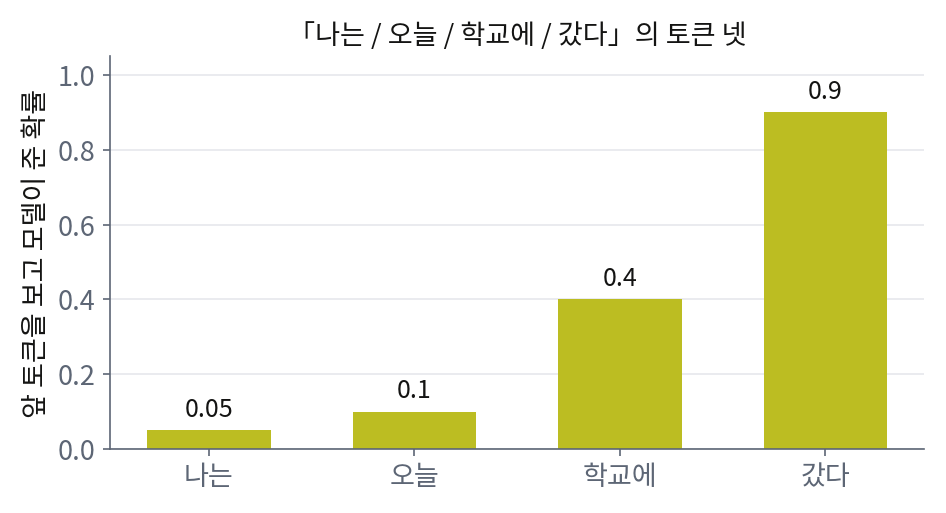
언어 모델이 「나는 / 오늘 / 학교에 / 갔다」라는 문장의 토큰 넷에, 앞 토큰들을 보고 차례로 0.05, 0.10, 0.40, 0.90의 확률을 주었다(설명을 위해 정한 값이다). 보내는 사람과 받는 사람이 이 모델을 똑같이 나눠 가졌다면, 이 문장을 보내는 데 몇 비트쯤 들까? 가장 많이 알려 주는 토큰은 무엇인가?
네 확률의 평균이 0.3625니까 −log₂ 0.3625 ≈ 1.46비트, 토큰 넷이면 5.86비트요.
문장 전체가 나올 확률은 네 확률의 평균이에요, 곱이에요?

차례로 다 나와야 하니까 곱이죠. 0.05 × 0.10 × 0.40 × 0.90 = 0.0018이고 −log₂ 0.0018 ≈ 9.12비트네요. 평균부터 내면 안 되는 거였어요.
곱의 로그는 로그의 합이니까 토큰마다 따로 구해서 더해도 돼. 4.32 + 3.32 + 1.32 + 0.15 = 9.12비트. 「나는」이 4.32비트로 가장 많이 알려 주고, 「갔다」는 0.15비트뿐이야.
「학교에」까지 들었으면 「갔다」는 거의 짐작이 가죠. 베티가 단어가 시작된 뒤의 글자를 거의 한 번에 맞힌 것과 같아요. 모델이 잘 맞히는 토큰에는 짧은 코드를, 못 맞히는 토큰에는 긴 코드를 주면, 문장 하나를 이 합에 가까운 비트로 보낼 수 있어요.
그래서 다음 토큰을 잘 맞히는 모델일수록 글을 더 짧게 줄일 수 있는 거네요. 조별 과제 회의록도 다들 아는 얘기는 빼고 새로 정한 것만 적으면 짧아지는 것처럼요.