분류 모델이 세 가지 답에 확률을 나눠 준다고 하자. 현실에서 세 답이 나오는 비율이 A라면, 모델 B와 모델 C 가운데 어느 쪽이 A에 더 가까울까? 자를 대 보기 전에, 자가 하나뿐인지부터 물어야 한다.
결과가 셋인 분포 세 개를 심플렉스(세 확률의 합이 1인 점들이 이루는 삼각형) 위에 놓는다.
A = (0.5, 0.3, 0.2), B = (0.6, 0.39, 0.01), C = (0.25, 0.25, 0.5).
유클리드 거리로 재면 A–B는 0.233, A–C는 0.394다. A는 B에 더 가깝다. 그런데 이 절에서 정의할 KL 발산이라는 다른 자를 A에서 대면 A–B는 0.429, A–C는 0.218이다. 이번에는 C가 더 가깝다. 같은 세 점인데, 자를 바꿨을 뿐이다.
무엇이 순위를 뒤집었을까. B는 결과 3에 겨우 1%를 준다. A는 그 결과에 20%를 준다. 유클리드 자에게 0.2와 0.01의 차이는 0.19라는 작은 좌표 차이일 뿐이다. KL 자에게는 "현실에서 다섯 번에 한 번 일어나는 일을 모형이 백 번에 한 번이라고 우긴다"는 심각한 착오다.
점을 "어떤 공간에 놓느냐"에 따라 가까움이 달라지듯, 같은 공간 안에서도 "어떤 자를 쓰느냐"에 따라 보이는 구조가 달라진다. 공간을 바꾸는 것과 자를 바꾸는 것은 같은 동전의 양면이다.
읽는 법은 이렇다. 두 줄 세로선 ‖ 의 앞 칸이 현실, 뒤 칸이 모형이다. 결과마다 "현실의 확률 ÷ 모형의 확률"에 로그를 씌우고, 현실에서 그 결과가 일어나는 확률을 무게로 삼아 평균을 낸다. 모형이 현실과 똑같으면 모든 비가 1이고 로그가 0이라서 KL도 0이다. 모형이 현실에서 흔한 결과를 드물다고 하면 그 결과의 비가 커지고, 현실이 그 결과에 준 확률만큼 벌점이 붙는다.
앞의 A를 현실 자리에, B를 모형 자리에 두고 결과마다 칸을 채워 보면 이렇다.
결과
현실 A
모형 B
비 A ÷ B
log(비)
A × log(비)
1
0.5
0.6
0.833
−0.182
−0.091
2
0.3
0.39
0.769
−0.262
−0.079
3
0.2
0.01
20
3.00
0.599
합
0.429
셋째 결과 한 칸이 0.599로, 합 0.429보다 크다. 모형이 현실보다 후하게 준 앞의 두 칸은 음수라 조금 깎아 낼 뿐이다. “다섯 번에 한 번을 백 번에 한 번이라 우긴” 착오가 KL의 거의 전부다.
이 식이 왜 하필 로그인지, 왜 항상 0 이상인지는 아직 말하지 않는다. 지금은 읽는 법만 손에 익히자.
p와 q의 역할
이 교재에서 p는 항상 “현실”(진짜 분포), q는 항상 “지도”(모형)다. KL(p‖q)는 “현실 p의 눈으로 본, 지도 q의 부정확함”. 평균을 내는 무게가 p라서, 현실에서 흔한 곳의 오차가 크게 잡힌다. KL(q‖p)는 “지도 q의 눈으로 본, 현실 p와의 어긋남”. 이번에는 무게가 q라서, 모형이 확신하는 곳의 오차가 크게 잡힌다. 같은 두 분포인데, 누구의 눈으로 보느냐에 따라 값이 다르다.
왜 "거리"가 아니라 "발산"인가
KL은 거리의 네 약속 중 첫 두 개는 지킨다. 항상 0 이상이고, 0이면 두 분포가 같다. 하지만 대칭이 아니고, 삼각부등식도 늘 지키지는 않는다. 세 분포를 잘 고르면 한 분포를 거쳐 돌아가는 쪽의 KL 합이 곧장 잰 KL보다 작게 나온다(피셔 정보를 다루는 절 끝의 문제 8에서 동전 셋으로 직접 확인한다). 그래서 수학자들은 이것을 거리(distance)라 부르지 않고 발산(divergence)이라 부른다. "한 점에서 다른 점으로 벌어져 나가는 정도"라는 뜻이다. 이 책도 KL을 거리라 부르지 않고 늘 "KL 발산"이라 부른다.
직접 움직여 보기
불러오는 중…
ML에서: 교차엔트로피 손실과 KL(p‖q)
분류 모델을 학습시킬 때 흔히 쓰는 교차엔트로피 손실 −Σ pi log qi 를 KL의 정의와 나란히 놓아 보자. KL(p‖q) = Σ pi log pi − Σ pi log qi 이므로, 교차엔트로피는 KL(p‖q)에 −Σ pi log pi(p의 엔트로피, 분포가 얼마나 고르게 퍼졌는지 재는 값)를 더한 것이다. 여기서 데이터의 정답 비율이 현실 자리, 모델이 모형 자리에 선다. 교차엔트로피로 학습하면 두 모델 가운데 어느 쪽을 고르는지, KL의 방향을 바꿔 재면 그 판단이 뒤집히는지는 아래 문제 5에서 따져 본다.
수확
“KL은 확률 세계의 무빙워크다.” 같은 두 분포라도 누구를 현실 자리에 두느냐에 따라 값이 다르다.
인물 이야기 — 쿨백과 암호해독의 자
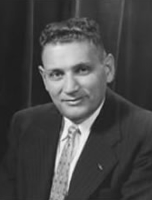
솔로몬 쿨백(1907–1994). 출처: Wikimedia Commons(미국 국가안보국 사진), 미국 정부 저작물이라 퍼블릭 도메인
사진: 솔로몬 쿨백(1907–1994). 출처 Wikimedia Commons(미국 국가안보국 사진), 미국 정부 저작물이라 퍼블릭 도메인
1930년 봄, 미 육군 신호정보국(Signal Intelligence Service)을 새로 꾸리던 윌리엄 프리드먼(William Friedman)이 공무원 시험으로 젊은 수학자 셋을 암호분석가로 뽑았다. 프랭크 롤렛, 에이브러햄 싱코프, 그리고 뉴욕 시립대학에서 수학을 공부한 솔로몬 쿨백(Solomon Kullback)이었다. 쿨백은 낮에는 암호를 풀고 밤에는 조지워싱턴 대학에서 공부해 1934년 수학 박사학위를 받았다.
암호해독은 빈도를 견주는 일이다. 평문 언어에서 글자가 나오는 빈도와 암호문에서 기호가 나오는 빈도를 견주고, 어떤 추측이 맞다면 지금 본 암호문이 얼마나 그럴듯한지를 따진다. 쿨백은 롤렛과 함께 일본 외무성의 암호기계(미국 쪽 암호명 RED)를 가로챈 전문만으로 풀어냈다. 전쟁 중인 1942년에는 영국 블레츨리 파크에 파견되어 영국이 독일 에니그마 암호를 읽어 내고 있다는 것을 보고 왔고, 돌아와서는 일본 암호를 맡은 부서의 책임자가 되었다.
그 블레츨리 파크에서 앨런 튜링(Alan Turing)은 관측 하나가 한 가설을 얼마나 편드는지를 로그 우도비(두 가설이 그 관측에 준 확률, 곧 우도의 비에 로그를 씌운 값)로 재어 더해 나가는 방법을 썼고, 그 양을 재는 단위로 「밴(ban)」을 만들었다. 함께 일한 굿(I. J. Good)은 이 양을 「증거의 무게」라고 불렀다. 그 무게를 한 가설이 옳다고 보고 평균 내면 — 그것이 뒤에 KL이라 불릴 양이다. 굿은 나중에 KL 발산을 「증거의 무게의 기댓값」이라 부르기도 했다.
전쟁이 끝나고 미국의 암호 기관들은 하나로 합쳐졌다(1949년 군 보안국, 1952년 국가안보국 NSA). 그 통합 기관에서 쿨백은 일리노이 대학 박사 출신의 수학자 리처드 라이블러(Richard Leibler)와 함께 일했다. 두 사람이 1951년에 발표한 논문 「정보와 충분성에 대하여」(On Information and Sufficiency)가 이 양에 이름과 체계를 주었다. 논문은 이 양을 "가설 1이 옳을 때, 관측 하나가 가설 1과 가설 2를 가려 주는 평균 정보"로 정의했다.
이 양은 대칭이 아니었다. "가설 1이 옳다고 보고 잰 평균"과 "가설 2가 옳다고 보고 잰 평균"은 다르다. 비대칭은 버그가 아니라 본질이었다. 암호해독에서 "내가 서 있는 가설"이 무엇인가에 따라 증거의 무게가 달라지는 것은 자연스러운 일이니까. 논문은 두 방향을 더한 대칭인 합에 「발산(divergence)」이라는 이름을 붙였는데, 이 합은 해럴드 제프리스(Harold Jeffreys)가 1948년 『확률론』 둘째 판에서 이미 쓰던 것이었다. 쿨백은 뒤에 한쪽 방향만 잰 양을 「방향이 있는 발산(directed divergence)」이라 불렀고, 오늘날의 「KL 발산」은 이 한쪽 방향을 가리킨다. 이 양이 늘 0 이상이라는 부등식은 그보다 앞서 통계역학의 깁스(Josiah Willard Gibbs)가 쓴 것이라 「깁스 부등식」이라 불린다.
쿨백은 1962년 NSA 수석 과학자로 은퇴할 때까지 30년 넘게 암호 기관에서 일했고, 은퇴한 뒤에는 조지워싱턴 대학에서 가르쳤다. 그의 이름이 붙은 KL 발산은 기계학습에서 손실함수의 핵심 재료가 되었고, 정보기하학에서는 공간의 구조를 정하는 자가 되었다. 암호해독가의 실용적 질문이 수학의 근본 개념이 된 셈이다.
문제 2. 두 동전, 두 방향
공정한 동전 (0.5, 0.5)과 기운 동전 (0.9, 0.1)이 있다. KL(공정‖기운)과 KL(기운‖공정)을 각각 구하라. 어느 쪽이 더 크고, 왜 그런가?
함께 풀기
선생님
동전 두 개, 방향 두 개. 숫자가 몇 나왔어요?
김민준
벌써 돌렸어요. KL(공정‖기운)이 0.511이고 KL(기운‖공정)은 0.368이요.
이서연
나도 같아. 손으로 해도 0.5 log(0.5/0.9) + 0.5 log(0.5/0.1)이니까 0.511 맞아.
선생님
좋아요. 그럼 왜 앞쪽이 커요?
김민준
음… 공정한 동전이 더 "무작위"하니까요? 엔트로피가 크니까 KL도 크다, 이런 거 아닐까요.
선생님
그 논리대로면 엔트로피가 큰 쪽이 앞에 오면 항상 KL이 커야겠네요. 서연 학생, 그런 것 같아요?
이서연
아니요, 식을 보면 엔트로피는 직접 안 들어가요. 항별로 보면… 공정한 동전이 뒷면에 0.5를 주는데 기운 동전은 0.1만 줘요. 그 항이 0.5 × log 5라서 0.80이에요. 거의 다 거기서 나와요.
선생님
맞아요. KL(p‖q)는 p가 자주 보는 곳에서 q가 얼마나 인색한지를 봐요. 공정한 동전에게 뒷면은 두 번에 한 번 보는 흔한 일인데, 기운 동전은 그걸 열 번에 한 번이라고 하니까요.
김민준
아, 반대 방향은 기운 동전이 뒷면을 거의 안 보니까 그 항이 가볍게 눌리는 거고요.
김민준
팀 과제 채점 기준표를 누가 만드느냐랑 비슷하네요. 조교가 만들면 조교가 중요하게 보는 항목에서 깎이고, 학생이 만들면 또 다른 데서 깎이고.
선생님
그 비유 괜찮아요. 무게를 누가 쥐고 있느냐, 그게 KL의 방향이에요.
문제 3. 모형 자리에 선 A
앞에서 본 세 분포 A, B, C를 다시 쓴다. 이번에는 A를 모형 자리에 두고 KL(B‖A)와 KL(C‖A)를 비교하라. A와 더 가까운 점은 여전히 C인가?
함께 풀기
김민준
이건 위젯에서 봤어요. C가 더 가까워요. KL은 B를 싫어해요, B가 결과 3에 1%밖에 안 주니까.
선생님
위젯 버튼은 어느 쪽에 놓여 있었어요?
김민준
…KL(A‖·)요. 아, 문제는 KL(·‖A)네요.
이서연
계산해 보면 KL(B‖A)가 0.182, KL(C‖A)가 0.239야. 이번엔 B가 더 가까워.
선생님
왜 다시 뒤집혔을까요?
이서연
이번엔 무게를 B가 쥐어요. B는 결과 3을 거의 안 보니까, A가 거기에 20%를 줬든 말든 신경을 안 써요. 1% 곱하기 로그라서 작아요.
이서연
그러니까 "A와 가장 가까운 점"이라는 질문 자체가 방향을 정해야 성립하는 질문이네요.
김민준
팀플 동료평가 같네. 내가 조원들을 매긴 순위랑 조원들이 나를 기준으로 매긴 순위가 다른 것처럼.
선생님
그래요. 유클리드 자에서는 "가까운 점"이 하나지만, KL에서는 누가 현실이고 누가 모형인지 먼저 정해야 해요.
문제 4. 모형이 0이라고 우기면
B = (0.6, 0.39, 0.01)의 셋째 칸을 더 줄여 Bε = (0.6, 0.4 − ε, ε)로 쓴다(ε = 0.01이면 B 그대로다). (가) ε = 0.001, 0.0001, 10⁻⁶, 10⁻¹²에서 KL(A‖Bε)를 구하라. ε → 0이면 어떤 값에 다가가는가? (나) 방향을 바꾼 KL(Bε‖A)는 어떻게 되는가? (다) ε = 0을 그대로 numpy에 넣으면 무엇이 나오고, 그 값을 어떻게 읽어야 하는가?
함께 풀기
김민준
(가) 돌렸어요. 0.883, 1.343, 2.264, 5.027이에요. 커지긴 하는데 10⁻⁶에서 10⁻¹²로 백만 배를 줄였는데도 2.8밖에 안 늘었어요. 이렇게 더디면 어디선가 멈추지 않을까요? 6쯤에서요.
선생님
ε를 열 배 줄일 때마다 얼마씩 늘었어요?
이서연
0.001에서 0.0001로 갈 때 0.46이요. 셋째 칸 항이 0.2 × log(0.2/ε)이니까, ε를 열 배 줄이면 0.2 × log 10 ≈ 0.46씩 늘어요. 몇 번을 줄여도 늘 같은 만큼 늘어요.
김민준
열 배 줄일 때마다 0.46씩이면… 멈추는 게 아니라 끝없이 커지는 거네요. 더디게 커지는 것과 멈추는 것은 다르구나.
선생님
(나)는요?
김민준
0.218, 0.224, 0.224, 0.224. 이건 정말로 0.224쯤에서 멈춰요.
선생님
같은 두 분포인데 한쪽은 끝없이 커지고 한쪽은 멈춰요. 왜 그럴까요?
이서연
KL(Bε‖A)에서 셋째 칸 항은 ε × log(ε/0.2)예요. log는 −∞로 가지만 앞에 곱한 ε가 더 빨리 0으로 가서, 항 전체가 0으로 가요. 무게를 쥔 Bε가 결과 3을 거의 안 보니까 그 결과의 어긋남은 셈에 거의 안 들어가요. 반대로 KL(A‖Bε)에서는 무게 0.2가 그대로 남은 채 로그만 커지고요.
nan은 셋째 칸의 0 × log 0에서 나왔을 거야. numpy는 0 × (−inf)를 계산하지 못하지만, 방금 본 대로 ε × log ε는 0으로 가니까 그 칸은 0으로 두면 돼. 그러면 0.224가 나와서 (나)에서 본 값과 이어져.
선생님
그래요. 0 × log 0은 0으로 약속하고, 현실에서 일어나는 결과에 모형이 0을 주면 KL은 무한대로 둬요. inf는 망가진 값이 아니라 정직한 답이에요.
김민준
무빙워크가 걷는 속도보다 빨라지니까 한쪽 방향만 영영 못 가던 거랑 같네요. 현실에서 일어나는 결과를 모형이 0이라고 우기면, 그쪽 방향 KL만 끝없이 커져요.
이서연
해석학 시간에 x log x가 0에서 0으로 간다는 걸 로피탈 정리로 보였는데, 그게 nan을 0으로 바꿔 주는 근거였네요.
문제 5. 교차엔트로피는 어느 쪽 KL을 고르나
사진 묶음의 정답 비율이 p = (고양이 0.7, 개 0.2, 여우 0.1)이다. 모델 가는 q₁ = (0.8, 0.19, 0.01)을, 모델 나는 q₂ = (0.5, 0.25, 0.25)를 낸다. (가) 두 모델의 교차엔트로피 −Σ pi log qi 를 구하라. 교차엔트로피로 학습하면 어느 모델을 더 낫다고 보는가? (나) 두 모델에 대해 KL(p‖q)와 KL(q‖p)를 구하라. 두 방향의 순위는 같은가? (다) 교차엔트로피의 순위가 한쪽 방향 KL의 순위와 늘 같은 까닭은 무엇인가? (이 절 첫머리 위젯의 「문제 5 불러오기」 단추로 p를 A 자리에, 모델 가를 B 자리에, 모델 나를 C 자리에 불러올 수 있다.)
함께 풀기
김민준
(가) 가는 0.949, 나는 0.901이에요. 나 쪽 손실이 작으니까 학습은 나를 더 낫다고 봐요.
이서연
(나) KL(p‖q)는 가가 0.147, 나가 0.099야. 교차엔트로피랑 같은 순서네.
김민준
교차엔트로피에서 KL을 빼면 가도 나도 0.802로 똑같네요. 그러면 KL은 어느 방향으로 재도 교차엔트로피랑 순위가 같겠네요.
선생님
KL(q‖p)도 재 봐요.
김민준
…가가 0.074, 나가 0.117이요. 이쪽으로 재면 가가 더 가까워요. 순위가 뒤집혔어요.
선생님
두 모델에서 똑같이 나온 0.802는 무엇이었어요?
이서연
−Σ pi log pi, 정답 비율 p의 엔트로피예요. p만으로 정해지니까 모델을 바꿔도 안 변해요. 교차엔트로피가 KL(p‖q)에 이 값을 더한 것이라서, 교차엔트로피를 줄이는 일은 KL(p‖q)를 줄이는 일과 순위까지 똑같아요. KL(q‖p) 쪽으로는 그런 식이 없으니 그쪽 순위는 따로 놀고요.
선생님
그러면 교차엔트로피로 학습할 때 크게 벌을 받는 건 어떤 모델이에요?
김민준
가는 여우에 0.01밖에 안 줬어요. 현실에서는 열 장에 한 장이 여우인데 백 장에 한 장이라고 우긴 셈이에요. KL(p‖q)는 현실 p의 무게로 평균하니까 그 착오를 크게 벌해요. 가의 눈으로 보면 여우는 거의 안 보이니까 KL(q‖p)에서는 그 착오가 가볍게 눌렸던 거고요.
선생님
그래요. 교차엔트로피 손실을 고르는 순간, 데이터를 앞 칸에 모델을 뒤 칸에 두는 방향이 정해져요. 학습은 방향을 이미 골라 놓고 있는 셈이에요.
이서연
A를 모형 자리에 두니까 가장 가까운 점이 C에서 B로 바뀌던 것과 같은 일이 모델 고르기에서 일어난 거네요.
김민준
조교님 채점표로 매기면 모두가 푼 흔한 문제의 비중이 커서 그런 문제를 크게 틀린 사람이 손해고, 제가 만든 채점표로 매기면 제가 자신 있는 문제만 크게 쳐 주는 거랑 같네요.