결과마다 놀라움이 있다면, 분포 전체의 불확실성은 그 놀라움을 결과가 나오는 빈도로 평균 내어 재면 되지 않을까? 스무고개로 먼저 해 보자.
스무고개로 먼저: 평균 질문 수
스무고개는 예/아니오 질문을 스무 번까지 던져 상대가 생각한 물건을 맞히는 놀이다. 질문 하나가 후보를 절반으로 줄이면, 20번으로 2²⁰ ≈ 100만 개 후보를 가를 수 있다. 후보가 8개이고 모두 같은 확률이면 매번 정확히 3번이 필요하다. 후보 넷의 확률이 (½, ¼, ⅛, ⅛)이면 "첫 번째 것이야?"부터 묻는 게 낫다. 첫 번째 것이면 1번, 두 번째면 2번, 나머지 둘이면 3번에 끝나므로 평균은 ½·1 + ¼·2 + ⅛·3 + ⅛·3 = 1.75번이다. 결과마다의 질문 수 1, 2, 3, 3이 곧 그 결과의 놀라움 −log₂ p이고, 1.75는 그 놀라움을 결과가 나오는 확률로 평균 낸 값이다. 이렇게 평균 낸 놀라움을 엔트로피라 부른다.
확률이 0인 결과는 일어나지 않으니 평균에 들어가지 않는다. 0 × log 0 = 0으로 약속한다.
질문 수와 엔트로피는 언제 맞고 언제 어긋나나
질문 수가 언제나 엔트로피와 딱 맞지는 않는다. 후보 셋이 같은 확률이면 엔트로피는 log₂ 3 ≈ 1.585 bit인데, 가장 잘 짠 질문(“A야?” 다음 “B야?”)도 1, 2, 2번이 걸려 평균 5/3 ≈ 1.667번이다. 질문은 정수 번만 할 수 있어서 놀라움 1.585를 그대로 쓸 수 없기 때문이다. 일반적으로 가장 잘 짠 질문 전략의 평균 질문 수 L은 H ≤ L < H + 1 (bit)을 만족한다. 엔트로피는 평균 질문 수의 바닥이다.
그러면 엔트로피는 어떤 분포에서 가장 클까? 하나가 거의 확실하면 질문은 거의 필요 없고, 엔트로피도 0에 가깝다. 한쪽으로 쏠린 분포는 흔한 결과부터 물어 평균 질문 수를 줄일 수 있지만, 모든 결과가 같은 확률이면 어느 것을 먼저 물어도 이득이 없다. 줄일 곳이 없으니 가장 많이 물어야 한다. 그래서 결과가 n가지인 분포의 엔트로피는 모두 같은 확률일 때 가장 크고, 그 값은 log n이다.
직접 움직여 보기
불러오는 중…
파이썬
import numpy as np

def H(p, base=2):
    p = np.asarray(p, dtype=float)
    p = p[p > 0]                        # 0 log 0 = 0 으로 약속
    return -np.sum(p * np.log(p)) / np.log(base)

print(f"물건 8개, 고르게      H = {H(np.ones(8) / 8):.3f} bit")
print(f"(1/2, 1/4, 1/8, 1/8)  H = {H([0.5, 0.25, 0.125, 0.125]):.3f} bit")
print(f"(0.97, 0.01, 0.01, 0.01) H = {H([0.97, 0.01, 0.01, 0.01]):.3f} bit")
print(f"세 결과 균등          H = {H(np.ones(3) / 3):.3f} bit = {H(np.ones(3) / 3, np.e):.3f} nat")
# 물건 8개, 고르게      H = 3.000 bit
# (1/2, 1/4, 1/8, 1/8)  H = 1.750 bit
# (0.97, 0.01, 0.01, 0.01) H = 0.242 bit
# 세 결과 균등          H = 1.585 bit = 1.099 nat
호기심 상자 — 키나 온도처럼 이어진 값의 엔트로피
후보가 키나 온도처럼 끊김 없이 이어진 값이면 스무고개는 끝나지 않는다. 키를 1 cm 단위로 맞히려면 몇 번이면 되지만, 1 mm 단위로 맞히려면 더 물어야 하고, 단위를 줄일수록 질문 수는 한없이 늘어난다. 그래서 이어진 값에서는 "질문 수"를 그대로 쓸 수 없다.
그래도 퍼진 정도를 재는 양은 있다. 정규분포의 모양은 평균 μ와 표준편차 σ 두 숫자로 정해진다. σ가 크면 분포가 넓게 퍼져 있다 — 불확실하다 — 엔트로피가 높다. σ가 작으면 뾰족하다 — 확실하다 — 엔트로피가 낮다. 연속분포에는 합 대신 적분으로 정의한 미분 엔트로피(differential entropy)를 쓴다. 엔트로피를 미분한 값이 아니라, 연속분포용 엔트로피의 이름이다. 정규분포라면 이렇다.
H=21log(2πeσ2)
Hσe정규분포의미분엔트로피 (nat)표준편차자연로그의밑2.718…
σ가 커질수록 커지는 건 같다. 그런데 σ < 1/√(2πe) ≈ 0.242이면 음수가 된다. 이산 엔트로피는 늘 0 이상인데 미분 엔트로피는 그렇지 않다. 미분 엔트로피는 확률이 아니라 확률밀도의 로그를 평균하기 때문이다. 밀도는 1보다 클 수 있다. 그래서 미분 엔트로피는 “질문 수” 같은 절대적인 뜻이 없고, 단위(cm냐 mm냐)를 바꾸면 값이 바뀐다. 위에서 본 대로 단위를 줄이면 질문 수가 늘어나는 것과 같은 일이다. 두 분포의 엔트로피 차이, 그리고 뒤에 나올 KL은 이런 문제가 없다.
“엔트로피는 심플렉스(확률들이 사는 삼각형) 위의 높이 지도. 한가운데(균등)가 가장 높다.”
인물 이야기 — 섀넌과 볼츠만, 70년을 사이에 둔 같은 식
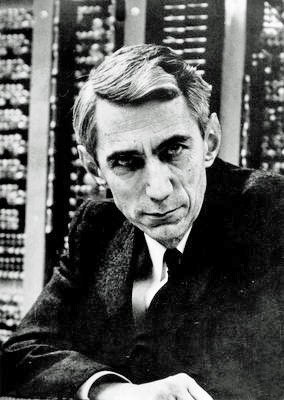
클로드 섀넌(1916–2001), 콘라트 야코프스 촬영. 출처: Wikimedia Commons(오버볼파흐 수학연구소 사진 자료), CC BY-SA 2.0 de
사진: 클로드 섀넌(1916–2001). 콘라트 야코프스 촬영, 출처 Wikimedia Commons(오버볼파흐 수학연구소 사진 자료), CC BY-SA 2.0 de
1948년, 벨 연구소의 클로드 섀넌(Claude Shannon)이 「통신의 수학적 이론(A Mathematical Theory of Communication)」을 발표했다. 이 논문이 풀고자 한 문제는 순수하게 공학적이었다. 잡음이 섞이는 전화선 하나로 메시지를 최대 얼마나 빨리, 틀리지 않게 보낼 수 있는가?
이 물음에 답하려면 먼저 "메시지의 양"을 재야 했다. 섀넌은 글자 수가 아니라, 받는 쪽이 아직 모르는 것을 가려내는 데 드는 0·1 자리의 수로 쟀다. 확률이 p인 결과 하나에는 −log p, 분포 전체에는 그 평균 H = −Σ p log p. 그리고 전화선의 용량은 보내는 쪽 분포를 바꿔 가며 얻을 수 있는 상호정보량(받은 신호가 보낸 신호에 대해 알려 주는 정보의 양)의 최댓값으로 표현된다.
이 양에 붙은 이름에는 일화가 전해진다. 1971년 마이런 트라이버스(Myron Tribus)가 섀넌에게서 들었다며 『사이언티픽 아메리칸』에 옮긴 이야기로, 이름을 고민하던 섀넌에게 수학자 존 폰 노이만(John von Neumann)이 이렇게 권했다는 것이다. “엔트로피라고 부르게. 두 가지 이유가 있네. 첫째, 자네의 불확실성 함수는 통계역학에서 이미 그 이름으로 쓰이고 있으니까. 둘째, 더 중요한 건, 아무도 엔트로피가 정말 뭔지 모르니까, 논쟁에서 항상 유리할 걸세.” 한 사람을 거쳐 훗날 전해진 말이라, 글자 그대로 오간 대화인지는 확실하지 않다.
농담 반 진담 반이었지만, "같은 식"이라는 부분은 정확했다. 70년 전인 1877년, 오스트리아 그라츠 대학의 루트비히 볼츠만(Ludwig Boltzmann)은 전혀 다른 문제를 풀고 있었다. 기체 분자가 셀 수 없이 많이 상자 안에서 날아다닌다. 각 분자의 속도를 하나하나 추적하는 것은 불가능하다. 대신 "분자들이 어떤 속도 분포를 가지고 있는가"를 묻는다.
볼츠만의 질문은 이것이었다. 분자들이 주어진 총 에너지를 나눠 가지는 방법은 몇 가지인가? 그 "방법의 수"의 로그가 엔트로피다. S = k log W — 뒤에 막스 플랑크(Max Planck)가 이 꼴로 정리했고, 빈 중앙묘지에 있는 볼츠만의 묘비에 새겨졌다. W는 미시 상태(분자 하나하나의 위치와 속도까지 다 정한 상태)의 수, k는 볼츠만 상수다.
전화선의 용량을 재는 공학자와 기체 분자의 무질서를 재는 물리학자가 70년의 간격을 두고 같은 수학에 도달했다. 우연이 아니었다. 두 문제 모두 “가능한 경우의 수를 세는” 문제였고, 경우의 수가 곱으로 커지는 세계에서 합으로 잴 수 있는 척도를 원했기 때문이다. 곱을 합으로 바꾸는 함수 — log — 가 두 문제에서 같은 이유로 등장한 것이다.
문제 4. 12면체 주사위의 엔트로피, bit와 nat
면마다 1부터 12까지 적힌 공정한 12면체 주사위의 엔트로피를 bit와 nat으로 각각 구하라. numpy로 계산할 때 어느 함수를 쓰는지, 두 단위를 어떻게 바꾸는지 적어라.
두 사람 숫자가 다르네요. 스무고개로 생각해 봐요. 눈이 열두 개인데 예/아니오 질문을 몇 번 하면 맞힐 수 있어요?
김민준
반씩 가르면 세 번으로는 여덟 개밖에 못 가르고, 네 번이면 열여섯 개니까… 세 번과 네 번 사이요.
김민준
그럼 2.485 bit는 너무 작네요. np.log는 자연로그였어요. 2.485는 nat이에요.
이서연
제 1.722는 더 작아요. 방향을 거꾸로 했네요. 1 nat이 1/ln 2 ≈ 1.443 bit니까 곱할 게 아니라 나눠야 해요. 2.485 / ln 2 ≈ 3.585 bit. 세 번과 네 번 사이 맞아요.
선생님
그래요. log₂ 12 = 3.585 bit = ln 12 = 2.485 nat. 같은 양을 다른 자로 잰 거예요.
이서연
로그의 밑 바꾸기 공식 log₂ x = ln x / ln 2를 거꾸로 쓴 거예요. 해석학 첫 주에 배운 건데.
김민준
과제 채점표에 단위 안 쓰면 감점이던 게 이래서였네요. 숫자만 보고는 cm인지 inch인지 모르는 거랑 같아요.
문제 5. 평균이 정해진 분포
결과가 1, 2, 3인 분포 p = (p₁, p₂, p₃)가 있다. (가) 평균 1·p₁ + 2·p₂ + 3·p₃가 2여야 한다면 엔트로피가 가장 큰 분포는? (나) 평균이 2.5여야 한다면 엔트로피가 가장 큰 분포는? 라그랑주 승수법(제약마다 새 미지수 하나를 곱해 목적식에 더한 뒤, 모든 변수로 미분한 값이 0이 되는 점을 찾는 방법)으로 풀고, 답이 정말 최댓값인지도 확인하라. (위 위젯의 「문제 5」 단추를 누르면 점 p가 평균이 2.5인 분포들 위로만 움직인다.)
함께 풀기
김민준
(가)는 균등분포요. 조건이 없어도 균등분포가 가장 크고, 그 평균이 (1 + 2 + 3)/3 = 2라서 조건을 이미 만족하니까요. (나)는 격자 탐색으로 풀었어요. 평균이 2.5면 p₃ − p₁ = 0.5라서 p₁ 하나만 0.01 간격으로 돌리면 돼요. (0.12, 0.26, 0.62)에서 엔트로피 0.901 nat이 최대예요.
선생님
0.01 간격 사이에 더 큰 값은 없어요?
김민준
없을 것 같은데… 장담은 못 해요. 간격을 줄이면 소수 셋째 자리가 움직일 수도 있고요.
이서연
라그랑주로 하면 정확히 나와요. 두 조건에 계수 α, λ(람다)를 붙인 −Σpi log pi − α(Σpi − 1) − λ(Σ i·pi − 2.5)를 pi로 미분하면 −log pi − 1 − α − λi = 0. 그러니까 pi ∝ ri 꼴, 이웃한 확률의 비가 일정해요.
이서연
비를 r이라 하면 p₁(r² − 1) = 0.5, p₁(1 + r + r²) = 1이라서 r² − r − 3 = 0, r = (1 + √13)/2 ≈ 2.303이에요. p ≈ (0.116, 0.268, 0.616), 엔트로피 0.901 nat이요.
선생님
민준 학생 격자 답이 거의 맞았네요. 그런데 서연 학생, 미분이 0인 점을 찾았어요. 그게 최댓값이라는 건요?
이서연
엔트로피가 오목함수니까… 아, 조건이 걸린 영역에 경계가 있어요. p₁ = 0이면 (0, 0.5, 0.5), p₂ = 0이면 (0.25, 0, 0.75). 라그랑주는 경계에서의 최댓값을 못 봐요.
이서연
경계 값을 재 보면 0.693, 0.562예요. 안쪽 0.901보다 작아요. 사실 −p log p를 p로 미분하면 −log p − 1이라서 p → 0에서 +∞예요. 경계에서 조금만 안으로 들어와도 엔트로피가 늘어나니까 경계는 최대가 될 수 없어요.
김민준
pi ∝ ri면 pi ∝ exp(λ′·i)잖아요. 이거 softmax 모양이에요. 평균 조건 하나 걸었더니 softmax가 나왔네요.
선생님
그래요. 제약 아래 엔트로피를 가장 크게 하면 지수 꼴이 나와요. 이 꼴에는 이름이 따로 있고, 앞으로 여러 번 다시 만나게 돼요.
김민준
격자 탐색은 조교님이 "답 근처에 있다는 증거"라고 하던 거랑 같네요. 답이라는 증명은 아니고요.
이서연
최적화 수업에서 "안쪽의 기울기가 0인 점과 경계를 둘 다 확인하라"는 말을 귀에 못이 박히게 들었는데, 막상 제가 빠뜨렸네요.
문제 6. 샘플링 온도와 엔트로피
언어 모델이 다음 토큰 후보 셋에 로짓(softmax에 넣기 전의 점수) (0, 1, 2)를 냈다. 샘플링할 때는 로짓을 온도 T로 나눈 뒤 softmax를 취해 확률을 만든다. (가) T = 1일 때 세 확률과 엔트로피(nat)를 구하라. (나) T를 0 쪽으로, 또 아주 크게 보내면 엔트로피는 어디로 가는가? (다) 앞 문제 (나)의 답 (0.116, 0.268, 0.616)이 나오는 T는 얼마인가?
함께 풀기
김민준
코드로 했어요. T = 1이면 (0.090, 0.245, 0.665), 엔트로피 0.832 nat. T = 0.5면 (0.016, 0.117, 0.867)로 뾰족해져서 0.441, T = 2면 1.020. T가 크면 퍼지고 작으면 뾰족해요. (나)는 T → 0이면 0이고, T → ∞이면 한없이 커지겠죠?
선생님
결과가 셋인 분포의 엔트로피는 어디까지 커질 수 있었죠?
김민준
아, 셋이 고르면 끝이에요. ln 3 ≈ 1.099 nat. 온도를 아무리 올려도 균등분포보다 퍼질 수는 없네요.
이서연
(다)는 앞 문제랑 이어져. 거기서 답이 pi ∝ ri, r ≈ 2.303이었잖아. 로짓 (0, 1, 2)를 T로 나누면 확률이 exp(i/T)에 비례하니까 1/T = ln r, T = 1/ln 2.303 ≈ 1.20.
이서연
그런데 이상해요. 앞 문제는 "평균이 2.5"라는 조건에서 엔트로피를 가장 크게 한 거였는데, 여기는 그런 조건을 준 적이 없잖아요. 온도만 바꿨는데 왜 같은 분포가 나와요?
선생님
T = 1.20일 때 이 softmax의 평균 1·p₁ + 2·p₂ + 3·p₃를 재 보세요.
이서연
0.116 + 0.536 + 1.848 = 2.5요. 온도를 하나 고르면 평균이 하나 정해지고, 그 평균을 지키는 분포 가운데 엔트로피가 가장 큰 것이 바로 그 softmax예요. 온도를 돌리는 건 평균 조건을 바꿔 가며 가장 퍼진 분포를 고르는 거네요.
김민준
챗봇 설정에서 temperature를 올리면 답이 들쭉날쭉해지는 게 이거였군요. 과제에서 temperature는 그냥 1로 두라길래 뜻도 모르고 뒀는데.
이서연
확률론 시간에 평균만 알고 나머지는 모를 때 가장 덜 가정한 분포를 고르라는 문제를 풀었는데, 그 답을 고르는 손잡이가 온도였네요.