KL 발산(두 분포가 얼마나 다른지 재는 비대칭의 양)은 멀리 떨어진 두 분포도 한 번에 비교한다. 그런데 매니폴드 위를 걸어가면서 한 걸음 한 걸음의 크기를 재려면? 좌표의 한 칸은 어디서나 같은 거리일까?
등산 지도의 등고선: 지도 위 1cm의 실제 거리
등산 지도에서 등고선이 빽빽한 곳은 경사가 급해서, 지도 위에서 1cm를 가는 동안 땅 위로는 비탈을 따라 더 먼 길을 걷는다. 등고선 간격이 넓은 곳은 완만해서 지도 위 1cm가 땅 위 거리와 거의 같으니, 같은 "지도 위 1cm"인데 실제 거리가 다르다.
그러니까 등산 지도를 제대로 읽으려면 각 지점에서 "여기서의 1cm는 실제로 몇 미터인가"를 알아야 한다. 그 정보가 등고선 간격에 들어 있다.
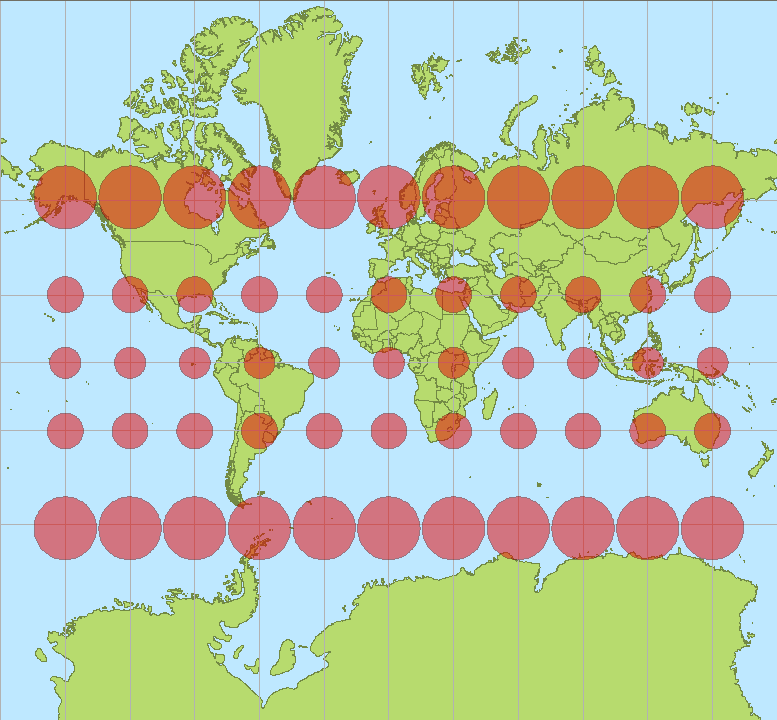
세계지도도 같다. 메르카토르 지도에서는 적도의 원과 극지방의 원이 지구 위에서 같은 크기인데, 지도 위에서는 극으로 갈수록 크게 그려진다. 지도 위 한 칸이 땅 위에서 얼마인지가 위도마다 다르다.
메르카토르 도법의 왜곡: 적도의 원과 극지방의 원이 같은 크기인데 지도에서는 다르다
파라미터 공간도 마찬가지다. θ를 0.01만큼 바꾸는 것이 어떤 곳에서는 분포를 확 바꾸고 어떤 곳에서는 거의 안 바꾼다. "좌표 지도의 등고선 간격"을 알아야 한 걸음의 진짜 크기를 알 수 있다.
곳마다 다른 눈금을 알려 주는 행렬은 KL 발산 안에 이미 들어 있다. KL 발산을 무한히 가까운 두 점 사이에서 전개하면 대칭적인 이차형식(dθᵀ A dθ 꼴)이 되고, 그 이차형식을 만드는 행렬 A가 피셔 정보 행렬이다. 피셔 정보 행렬이 바로 각 지점에서 "한 걸음이 분포를 얼마나 바꾸는가"를 알려 주는 국소적 자다. 수학은 이런 국소적 자를 계량(metric)이라 부른다.
계량을 식으로 쓰면
좌표 u¹, u², … 를 조금씩 움직일 때 실제 거리 ds는 이렇게 잰다. 좌표에 흔히 쓰는 x 대신 u 로 적는 것은 이 책에서 x 가 데이터(관측값)를 가리키기 때문이다. u 위에 붙은 작은 숫자와 글자(u¹, ui)는 거듭제곱을 뜻하지 않고 몇 번째 좌표인지 알리는 번호다. ds(디에스)는 d 곱하기 s가 아니라 「작은 한 걸음의 길이」를 뜻하는 한 덩어리 기호이고, ds²의 2만 제곱이다.
지도 위에서 같은 du라도 g가 크면 실제 걸음은 크고, g가 작으면 실제 걸음은 작다. 등고선 간격이 곧 g이고, 확률분포의 공간에는 이 g 자리에 피셔 계량 하나가 자연스럽게 놓인다.
정규분포족의 피셔 계량
평균 μ와 표준편차 σ로 정해지는 정규분포들의 모임에서 피셔 계량을 직접 적어 보자. 두 정규분포 사이의 KL 발산을 아주 가까운 두 점에서 전개하면 다음 계량이 나온다.
ds2=σ2dμ2+2dσ2
μσds평균 (좌표)표준편차 (좌표)피셔계량으로잰한걸음
분모에 σ²이 있으므로 σ가 크면 같은 dμ도 작은 걸음이다. 평균이 조금 다른 두 분포라도 둘 다 넓게 퍼져 있으면 서로 잘 구별되지 않기 때문이다. 아래 그림의 타원 하나하나는 피셔 계량으로 같은 한 걸음이 좌표 평면에서 차지하는 자리다. 메르카토르 지도에서 같은 크기의 원이 위도에 따라 달리 그려지듯, 같은 한 걸음이 σ에 따라 다른 크기로 그려진다.
정규분포족의 (μ, σ) 평면에 그린, 피셔 계량으로 같은 한 걸음(ds = 0.25)의 타원들. σ가 커질수록 타원이 커지고, 가로(μ 방향) 반지름은 세로(σ 방향) 반지름의 √2배다
경로의 길이: 모양과 걸음의 비용
두 분포를 잇는 길에는 m-길(확률을 섞는 길)과 e-길(로그를 섞은 뒤 합이 1이 되게 다시 나누는 길)이 있었다. 두 길의 "길이"를 비교하고 싶다면 각 지점에서 한 걸음의 크기를 알아야 한다. 같은 두 점 사이를 걸어가는데 경로의 길이가 다른 이유는 두 가지로, 첫째는 경로의 모양이 다르기 때문이고 둘째는 걷는 곳마다 한 걸음의 "비용"이 다르기 때문이다(이 절에서 보는 것). 계량이 있어야 경로의 길이를 잴 수 있고, 길이를 알아야 "더 짧은 길"을 물을 수 있다. 가장 짧은 길을 측지선(geodesic)이라 부른다.
측지선: 계량이 정하는 “가장 짧은 길”
평면에서 두 점 사이의 가장 짧은 길은 직선이다. 곡면에서는? 평면의 직선이 없으니, 대신 "가능한 모든 경로 중에서 길이가 가장 짧은 것"을 고른다.
지구 위에서 서울과 뉴욕을 잇는 가장 짧은 경로는 첫 절에서 잰 대원(지구 중심을 지나는 큰 원. 길이 11,052 km로, 위경도 지도 위의 곧은 선 13,716 km보다 짧았다)이다. 북쪽으로 크게 돌아가는 길이 오히려 짧았다.
가장 짧은 길은 계량이 정한다. 같은 좌표 위에서도 계량을 바꾸면 가장 짧은 길이 달라져서, 유클리드 계량을 쓰면 직선이 가장 짧고 피셔 계량을 쓰면 다른 곡선이 가장 짧다.
정규분포족의 (μ, σ) 평면에서도 그렇다. 피셔 계량 아래에서 두 정규분포를 잇는 가장 짧은 길이 좌표 위의 직선이 아닌 것은 "좌표에서 가까운 것"과 "분포로서 가까운 것"이 다르기 때문이다. 어느 쪽으로 돌아가는 길이 더 짧은지는 아래 문제에서 직접 잰다.
그러면 앞에서 말한 m-길과 e-길은 무엇인가? m-길과 e-길은 피셔 계량으로 잰 가장 짧은 길이 아니다. 계량은 하나이고 그 계량이 정하는 가장 짧은 길도 하나인데, m-길과 e-길은 그와 다른 종류의 "곧음"을 따른다. 길이를 줄이는 대신, 방향을 바꾸지 않고 곧게 나아가는 길. 무엇을 "방향을 바꾸지 않는다"고 부를지 정하는 규칙이 따로 있고, 그 규칙이 둘이어서 곧은 길도 둘이다. 이 장 뒤쪽의 두 절에서 그 규칙, 접속(connection)을 만난다.
지금은 한 가지만 기억하자. 계량은 피셔 계량 하나이고 그 계량이 가장 짧은 길을 정하며, 정보기하학에서 "둘"인 것은 계량이 아니라 곧음의 규칙(접속)이다.
볼록함수 F가 주는 계량: 두 번 미분한 값
지수족의 로그정규화자 F(θ)(분포의 합이 1이 되게 나누는 수의 로그)는 볼록함수다. 볼록함수가 얼마나 가파르게 오므라드는지(두 번 미분한 값)는 어디서나 같은가? y = x²/10 과 y = x² 를 두 번 미분한 값이 0.2와 2로 다르듯, F(θ)를 두 번 미분한 값도 θ에 따라 다르다. 그리고 F(θ)를 두 번 미분한 행렬(헤시안)이 바로 θ 좌표의 피셔 계량인 피셔 정보 행렬이다. 한 가지만 미리 짚자. F를 두 번 미분한 값은 계량의 눈금이지 공간의 곡률이 아니며, 둘을 가르는 것이 다음 절이다.
파이썬
정규분포의 (μ, σ) 공간에서 μ를 똑같이 0.1씩 옮기면서, σ = 0.5 근처와 σ = 5 근처에서 KL 발산이 얼마나 다른지 본다.
import numpy as np

def kl_gauss(m1, s1, m2, s2):
    return np.log(s2 / s1) + (s1**2 + (m1 - m2)**2) / (2 * s2**2) - 0.5

for s in [0.5, 5.0]:
    print(f"σ = {s}:  Δμ = 0.1 이 만드는 KL = {kl_gauss(0, s, 0.1, s):.5f}")
# σ = 0.5:  Δμ = 0.1 이 만드는 KL = 0.02000
# σ = 5.0:  Δμ = 0.1 이 만드는 KL = 0.00020
같은 좌표 한 칸인데 KL이 100배 다르다. KL은 (Δμ)²/(2σ²)으로 위 피셔 계량으로 잰 ds²의 절반과 같은 값이어서, σ가 10배 커지면 100배 작아진다. “좌표의 한 칸이 어디서나 같은 거리가 아니다.”
ML에서: 자연 그래디언트, 한 스텝을 어느 계량으로 재나
경사하강법은 "한 스텝씩 내려가는 것"이다. 한 스텝의 크기를 어떤 계량으로 재느냐에 따라 "가장 가파른 내리막"의 방향과 스텝 크기가 달라진다. 피셔 계량으로 잰 같은 크기의 스텝 가운데 손실을 가장 많이 줄이는 방향으로 가는 방법을 자연 그래디언트(natural gradient)라 부른다. 좌표로 스텝을 재는 보통의 경사하강법과 무엇이 달라지는지는 아래 문제 6에서 직접 계산해 본다.
이 절의 결론
“매니폴드 위에서 한 걸음의 크기를 재려면 계량이 필요하고, 계량의 눈금은 위치마다 다르다.”
인물 이야기: 마할라노비스와 「집단 사이의 거리」
곳마다 다른 계량으로 거리를 잰다는 생각은 1854년 리만의 교수 자격 강연에서 나왔다(그 이야기는 『미분기하학의 언어들』 1장). 그보다 소박하게, 방향마다 한 걸음의 값이 다른 거리는 20세기 초 통계학이 사람의 몸을 재는 일에서 먼저 필요로 했다.
프라산타 찬드라 마할라노비스(Prasanta Chandra Mahalanobis, 1893–1972)는 1920년 나그푸르에서 열린 인도 과학 회의에서 인도 동물학 조사국장에게 부탁을 받았다. 캘커타의 앵글로인디언(영국계와 인도계의 혼혈 집단)을 재어 모은 인체 측정 자료를 분석해 달라는 것이었다. 그 결과가 1922년의 첫 논문 「캘커타 앵글로인디언의 인류학적 관찰 I: 남성 키의 분석」이고, 뒤에는 벵골의 여러 집단을 견주는 연구로 넘어갔다.
거기서 부딪힌 고민은 이랬다. 키, 머리 길이, 머리 폭 같은 여러 측정값으로 두 집단을 견줄 때, 측정값마다 평균 차이를 재어 그냥 더하면 될까? 키가 큰 사람은 머리도 긴 편이듯 측정값들은 서로 얽혀 있어서, 그냥 더하면 얽힌 방향의 차이를 겹쳐 세게 된다. 그래서 그는 측정값의 퍼짐과 얽힘, 곧 공분산 Σ 로 나눠 재는 D² 를 쓰게 되었고, 1936년 4월 인도 국립 과학원 회보 2권 1호에 실은 「통계에서의 일반화된 거리에 대하여」로 정리했다. 두 집단의 평균 차이를 Δx 라 할 때 D² = Δxᵀ Σ⁻¹Δx 로 적는 이 양을 오늘날 마할라노비스 거리라 부른다.
두 측정값(표준화한 키와 머리 길이)이 상관 0.8 로 얽힌 점구름 위에, 가운데서 유클리드 거리 0.5 인 원과 마할라노비스 거리가 같은 타원 둘을 겹친 그림. 같은 0.5 차이라도 얽힌 방향으로는 D = 0.373, 가로지르는 방향으로는 D = 1.118 이다
두 측정값의 상관이 0.8 이면, 같은 0.5 차이라도 얽힌 방향(둘 다 큰 쪽)으로는 D = 0.373 이고 가로지르는 방향(하나는 크고 하나는 작은 쪽)으로는 D = 1.118 로 세 배다. 얽힌 방향의 차이는 흔해서 집단을 덜 가르고, 가로지르는 차이는 드물어서 더 많이 가르기 때문이다.
마할라노비스는 1931년 12월 17일 캘커타에 인도통계연구소를 세웠고, 라오가 1940년 그곳의 교육 과정에 들어와 1943년 11월부터 견습 연구원으로 일했다. 그의 거리는 방향마다 한 걸음의 값이 다르지만, 그 값을 정하는 계량은 어디서나 같다. 공분산이 Σ 로 고정된 정규분포의 모임에서 평균에 대한 피셔 계량이 바로 Σ⁻¹ 이어서, 두 평균 사이의 피셔 거리는 마할라노비스 거리 D 와 같다. 이 장의 계량은 그 계량마저 곳마다 달라지는 경우이고, 확률분포의 공간에서 그 길을 연 것이 라오의 1945년 논문이다.
왼쪽: 공분산을 고정한 정규분포의 평균 평면. 피셔 계량으로 같은 한 걸음의 타원이 어디서나 같다(마할라노비스 거리). 오른쪽: 정규분포족의 (μ, σ) 평면. 같은 한 걸음의 타원이 σ 에 따라 커진다(이 장의 계량)
김민준
오늘 같으면 측정값에서 공분산 행렬을 구하고 역행렬을 곱하면 끝이잖아요. numpy 로 한 줄인데, 그게 1936년에야 논문으로 정리됐다니 좀 의외예요.
선생님
그 한 줄을 종이와 연필로 한다고 해 봐요. 키, 머리 길이, 머리 폭 셋만 재도 공분산 행렬에 숫자가 몇 개 들어가죠?
김민준
3 × 3이라 아홉 개, 대칭이니까 따로 구할 건 여섯 개요. 그걸 한 사람 한 사람 잰 값을 곱하고 더해서 구한 다음, 역행렬까지 손으로… 측정값이 열 개면 쉰다섯 개네요.
선생님
계산보다 먼저 막힌 데도 있었어요. 측정값마다 평균 차이를 재어 그냥 더하면 왜 안 되는지부터가 물음이었죠.
이서연
위 그림에서 상관이 0.8이면 같은 0.5 차이가 0.373도 되고 1.118도 됐잖아요. 차이만 재서는 어느 쪽인지 모르니까, 사람들 사이의 퍼짐과 얽힘까지 같이 재야 했던 거네요.
선생님
그렇게 구한 Σ⁻¹ 는 어느 두 집단 사이를 재든 같은 자예요. 그런데 다루는 분포마다 퍼짐 자체가 다르다면요?
이서연
퍼짐이 크면 같은 평균 차이도 덜 가르니까… 퍼짐이 다른 분포들 사이를 오갈 때는, 한 걸음의 값을 정하는 계량도 위치마다 바뀌어야 하는 것 아닌가요?
문제 4. 등산 지도 1 cm는 땅 위로 몇 미터인가
축척 1:25,000 등산 지도에 등고선이 높이 10 m마다 그려져 있고, 지도 위 1 cm는 수평으로 250 m다. A 지점에서는 등고선이 지도 위 1 mm 간격으로, B 지점에서는 5 mm 간격으로 그려져 있다. (가) 두 지점에서 등고선에 수직으로, 곧장 비탈을 따라 지도 위 1 cm를 걸으면 땅 위로는 몇 m를 걷는가? (나) 지도 위 한 걸음 dx와 땅 위 한 걸음 ds를 ds² = g·dx²로 쓰면 g는 두 지점에서 각각 얼마인가? (다) 같은 A 지점에서 등고선을 따라 옆으로 걸으면 g는 얼마인가?
등고선 간격이 1 mm인 A 지점과 5 mm인 B 지점. 비탈을 따라 지도 위 1 cm를 걷는 화살표와, A 지점에서 등고선을 따라가는 화살표
직각삼각형이요. 걸은 길은 빗변이니까 더하는 게 아니라 √(250² + 100²) ≈ 269.3 m네요. B는 5 mm마다 10 m니까 1 cm에 20 m 올라서 √(250² + 20²) ≈ 250.8 m고요.
이서연
(나)는 비탈의 기울기로 쓰면 돼요. A는 수평 25 m에 10 m를 오르니까 기울기 0.4, g = 1 + 0.4² = 1.16. B는 기울기 0.08이라 g = 1.0064. 같은 dx인데 g가 곳마다 달라요.
선생님
(다)는요? A 지점 그대로예요.
이서연
등고선을 따라가면 높이가 안 바뀌니까 g = 1이에요. 같은 A 지점인데 방향에 따라 g가 달라요. 그러니까 한 점의 계량은 숫자 하나로는 모자라고 방향마다 값을 주는 행렬이어야 해요. 본문의 gij가 왜 행렬인지 이제 알겠네요.
김민준
지도 위 거리로 예상 소요 시간을 짜면 안 되는 거였네요. 조별 과제 분량을 쪽수로만 나누면 그림 많은 쪽을 받은 사람이 손해 보는 거랑 같아요.
문제 5. 돌아가는 길이 더 짧다
정규분포족의 피셔 계량 ds² = (dμ² + 2dσ²)/σ²에서, A = N(−2, 1²)와 B = N(2, 1²)를 잇는 두 길의 길이를 잰다. (가) σ = 1을 지키며 μ만 −2에서 2로 가는 좌표 직선의 길이는? (나) 먼저 σ를 1에서 s로 올리고, σ = s에서 μ를 −2에서 2로 옮긴 뒤, σ를 다시 1로 내리는 길의 길이 L(s)를 구하고 s = 2일 때 값을 구하라. (다) L(s)가 가장 작아지는 s와 그때의 길이는? (다)의 결과는 가장 짧은 길의 모양에 대해 무엇을 말하는가?
(μ, σ) 평면의 A = N(−2, 1²), B = N(2, 1²)와 길이를 잴 두 길: σ = 1을 지키는 좌표 직선, σ = s까지 올라가 건너는 길
함께 풀기
김민준
(가)는 σ = 1이니까 ds = dμ, 길이 4예요. (나)는 올라갔다가 내려오는 길이니까 계산하기 전에도 4보다 길 게 뻔하죠. 돌아가는 거잖아요.
선생님
계산하기 전에 뻔한가요? 가로로 가는 구간이 σ = s에서는 얼마예요?
김민준
ds = dμ/s니까 가로 구간은 4/s예요. 세로는 ds = √2 dσ/σ라서 한쪽이 √2 ln s, 오르고 내리니까 2√2 ln s. L(s) = 2√2 ln s + 4/s. s = 2면 2√2 × 0.693 + 2 ≈ 3.96이요.
김민준
어, 4보다 짧아요. 돌아갔는데 짧아졌어요.
이서연
그럼 가장 짧아지는 s가 따로 있겠네요. 미분해서 2√2/s − 4/s² = 0, s = √2예요. L(√2) = √2 ln 2 + 2√2 ≈ 3.81.
김민준
더 올라가면 더 짧아지는 거 아니야? s = 3도 넣어 볼게… 4.44, 다시 길어지네.
이서연
위로 조금만 올라가서 건너는 게 좋고, 너무 올라가면 오르내리는 비용이 커지는 거야.
선생님
왜 위로 올라가면 가로 비용이 싸질까요?
이서연
σ가 크면 평균이 조금 달라도 두 분포가 잘 안 구별되니까, 거기서의 μ 한 칸은 짧은 걸음이에요. 서울–뉴욕 비행기가 북쪽으로 올라갔다가 건너는 거랑 같은 구조네요.
선생님
그럼 (다)의 마지막 물음은요? 가장 짧은 길은 어떤 모양일까요?
이서연
이 길은 모서리가 있잖아요. 모서리를 깎아 매끈하게 휜 길이 더 짧을 테니까… 가장 짧은 길은 σ가 큰 쪽으로 불룩한 곡선이겠어요.
선생님
그래요. 좌표 위의 직선이 가장 짧은 길이라는 건 유클리드 계량을 쓸 때만 맞아요.
김민준
시험 기간에 도서관까지 큰길로 돌아가는 게 골목으로 곧장 가는 것보다 빠른 거랑 같네요. 지도 위 거리보다 걸음 하나의 비용이 중요했어요.
문제 6. 같은 학습률, 다른 σ
평균 x̄인 데이터에 정규분포 N(μ, σ²)의 μ만 맞추는데, σ는 알려져 있고 손실은 L(μ) = (μ − x̄)²/(2σ²)이다. 경사하강법 μ ← μ − lr·∂L/∂μ로 학습률 lr(learning rate 의 줄임. l 곱하기 r 이 아니다) = 0.3을 쓴다. (가) σ = 0.5와 σ = 5에서 오차 μ − x̄는 한 스텝마다 몇 배가 되는가? 오차를 처음의 1% 아래로 줄이려면 각각 몇 스텝이 필요한가? (나) lr 하나를 잘 골라 두 경우 모두 빠르게 만들 수 있는가? (다) 그래디언트에 σ²을 곱해서 업데이트하면 어떻게 되는가?
σ = 0.5와 σ = 5의 손실 L(μ)와 출발점 μ = x̄ + 1. 두 그래프의 세로 눈금은 다르다