분류 모델의 마지막 층은 확률을 곧바로 내놓지 않고 로짓이라는 숫자를 내놓으며, 소프트맥스나 시그모이드가 그 로짓을 확률로 바꾼다. 개수를 맞히는 모델도 평균 대신 그 로그를 내놓곤 하는데, 확률이 필요할 때 왜 모델은 늘 다른 숫자를 거쳐 갈까?
한편 볼록함수 F가 있으면 그 그래디언트 ∇F를 새 좌표로 삼을 수 있었다. 그래디언트로 맞물린 두 좌표에서는 F와 그 쌍대 F*(F가 정해지면 따라 정해지는 짝 함수)의 합이 두 좌표의 곱이 된다.
두 이야기를 나란히 놓고 물어 보자. 확률분포를 정하는 숫자인 파라미터에도 이런 볼록함수가 딸려 있을까, 있다면 로짓 같은 숫자와 확률 같은 숫자는 그 함수의 무엇일까?
지수족: 네 성분 θ, t, F, k 로 짜인 분포의 가족
베르누이, 푸아송, 정규분포. 동전, 한 시간에 걸려 오는 전화 수, 키의 분포. 세 분포가 세상에서 하는 일은 전혀 다르지만 수학자들은 세 분포를 같은 가족이라고 부른다. 어디가 같다는 걸까?
레고: 뒤집어 보면 같은 결합부
성, 우주선, 자동차. 겉모양은 완전히 다르지만 뒤집어 보면 결합부가 같다. 같은 돌기와 홈. 같은 규격.
분포도 그렇다. 겉모양(종 모양, 계단 모양, L자 모양)은 다르지만 뒤집어 보면 같은 규칙으로 끼워져 있다. 무엇이 끼워져 있는지는 가장 단순한 분포부터 뒤집어 보면 보인다.
손으로 한 번: 베르누이
결과가 앞면과 뒷면 둘뿐이라 더할 것이 두 항밖에 없기 때문에 동전 던지기를 먼저 고른다. 앞면 확률이 μ이면 p(x) = μˣ(1 − μ)¹⁻ˣ (x는 0 또는 1)이다. 앞면 확률을 p 나 θ 가 아니라 μ 로 적는 것은, 여기서 p 는 분포 전체를 가리키고 θ 는 곧 새로 만날 다른 좌표(자연 파라미터)에 쓸 글자이기 때문이다. 앞면 확률은 x 의 평균이기도 해서, 평균에 흔히 쓰는 μ 를 골랐으니, 이제 로그를 씌워 x에 대해 정리한다.
μx(1−μ)1−x=exp(xlog1−μμ+log(1−μ))
μx앞면확률 (익숙한파라미터)던진결과, 앞면 1 ⋅ 뒷면 0
μ = 0.3 이면 지수 안에 두 수가 나온다. x에 곱해진 수 log(0.3/0.7) = −0.847 과, x와 상관없는 수 log 0.7 = −0.357 이다. 앞면이면 exp(−0.847 − 0.357) = 0.3, 뒷면이면 exp(−0.357) = 0.7. 동전 하나의 모양이 이 두 수로 다 정해진다. 앞의 수 −0.847은 앞면 대 뒷면 확률 비의 로그인 로그 오즈이고, 기계학습에서는 로짓이라고 부른다. 뒤의 수 −0.357은 두 확률의 합이 1이어야 하므로 로그 오즈가 정해지면 따라 정해진다.
이 두 수에 이름을 붙이면 다른 분포에도 그대로 쓸 수 있다. x에 곱해지는 수를 θ, 데이터에서 그 수와 곱해지는 양을 t(x), 합을 1로 맞추려고 빼는 수를 F(θ)라 하고, θ와 상관없이 x마다 붙는 항을 k(x)라 하자.
푸아송의 캐리어를 보라. λˣexp(−λ)/x! 에서 1/x! 은 θ와 아무 상관 없이 x마다 붙는다. 1/x! 을 빼먹고 exp(θx − eᶿ)만 쓰면 확률의 합이 1이 아니라 무한대로 간다. 그러니 "θ, t, F만 바꿔 끼우면 전부 나온다"는 말은 반만 맞고, 성분은 θ, t, F, k 넷이다.
네 성분의 골격이 편리하다는 것은 알겠지만, 동전, 전화 수, 키처럼 하는 일이 전혀 다른 분포들이 왜 하필 이 꼴로 모일까?
주사위를 아주 많이 던졌는데 기록은 사라지고 「평균이 4.5였다」는 말만 남았다고 하자. 공정한 주사위라면 3.5였을 평균이 4.5였으니, 다음에 던질 때 각 면의 확률은 얼마로 매겨야 할까? 평균이 4.5인 분포는 셀 수 없이 많아서, (0, 0, 0, ½, ½, 0)도 평균이 4.5이고 (0, 0, ¼, ¼, ¼, ¼)도 그렇다. (0, 0, 0, ½, ½, 0)은 1·2·3·6이 절대 안 나온다고, (0, 0, ¼, ¼, ¼, ¼)은 1과 2가 절대 안 나온다고 우긴다. 들은 것은 평균 하나뿐인데 그런 말까지 보태도 될까?
들은 것 말고는 아무것도 보태지 않으려면, 평균 4.5를 지키면서 가장 고르게 퍼진 분포를 골라야 한다. 고른 정도는 엔트로피 H = −Σ p log p 로 잰다. 엔트로피는 분포가 얼마나 고르게 퍼졌는지, 다시 말해 결과를 얼마나 모르는지를 재는 양이다. 앞의 두 후보는 H가 log 2 = 0.693, log 4 = 1.386 이다. 평균 4.5를 지키면서 H를 가장 크게 하는 분포를 수치로 찾으면 (0.054, 0.079, 0.114, 0.165, 0.240, 0.347)이 나오고, H = 1.614 다. 이 H는 공정한 주사위의 log 6 = 1.792 보다 작은데, 그 차이만큼을 평균 조건이 깎은 것이다.
평균이 4.5인 주사위 분포 셋: 두 면만 쓰는 분포(H = 0.693), 네 면을 고르게 쓰는 분포(H = 1.386), 엔트로피가 가장 큰 분포(H = 1.614). 가장 큰 분포는 이웃한 면의 확률 비가 늘 1.449다
숫자를 보면 이웃한 두 면의 확률 비가 0.079/0.054, 0.114/0.079, … 모두 1.449로 늘 같다. 비가 일정하다는 것은 로그를 씌우면 눈 x에 대해 직선이라는 뜻이다.
이 분포는 지수족의 골격과 꼴이 같다. 평균을 정해 둔 양 x가 t(x) 자리에, 이웃 비의 로그 0.371이 θ 자리에, 분모의 로그가 F(θ) 자리에 앉는다. 평균 대신 x와 x²의 평균을 함께 정해 두고 엔트로피를 가장 크게 하면 정규분포가 나온다. 제약을 목적식에 더할 때 곱하는 계수(라그랑주 승수)를 써서 풀면, 제약 하나마다 곱해지는 계수가 θ의 성분 하나가 된다. 「전해 들은 평균만 지키고 나머지는 가장 고르게」라는 이 원칙을 최대 엔트로피 원리라 부르고, 지수족은 그 원칙이 내놓는 답의 모양이다. 이 주사위 물음은 최대 엔트로피 원리를 세운 제인스가 1962년 강의에서 든 예다.
이 절의 결론
“지수족 = 같은 골격(θ, t(x), F, k)을 공유하는 분포의 가족. 표준 꼴(정준형): p(x) = exp(θ·t(x) − F(θ) + k(x)).”
“t(x)의 평균만 정해 두고 나머지를 가장 고르게 퍼뜨리면 이 골격이 나오고, θ는 그때 제약마다 붙는 계수다.”
인물 이야기: 볼프의 주사위 2만 번
위의 주사위는 평균만 전해 들은 가상의 주사위였지만, 진짜 주사위를 아주 많이 던진 기록도 남아 있다. 스위스의 천문학자 루돌프 볼프(Rudolf Wolf, 1816–1893)는 태양 흑점의 수를 세어 기록한 사람으로 알려져 있는데, 통계 이론이 맞는지 확인하려는 듯 여러 무작위 실험을 했다. 그 가운데 하나에서 그는 주사위 두 개를 던졌고, 둘 가운데 한 개를 2만 번 던진 기록이 남았다.
면마다 나온 비율은 1부터 6까지 0.16230, 0.17245, 0.14485, 0.14205, 0.18175, 0.19660 이었다. 모두 1/6 ≈ 0.16667 근처여야 할 값인데 3과 4는 덜 나오고 5와 6은 더 나왔다. 2만 번이나 던졌으니 공정한 주사위에서 우연으로 이만큼 벗어날 확률을 계산하면 10⁻⁵⁶ 꼴이어서, 공정한 주사위라는 가설은 버려야 한다.
그러면 주사위의 무엇이 틀렸을까? 최대 엔트로피 원리를 세운 제인스가 훗날 이 자료를 분석하면서, 주사위를 직접 보지 않고 결함 두 가지를 가설로 세웠다. 첫째, 눈을 파낸 자리만큼 상아가 빠져 무게중심이 옮겨 가므로, 눈의 수에 비례하는 양 t₁(i) = i − 3.5 의 평균이 0이 아니게 된다. 둘째, 정육면체를 깎을 때 마지막에 깎은 방향의 길이가 조금 달라지기 쉬운데, 3과 4가 덜 나왔으니 3–4 방향이 조금 길다고 보면 t₂(i) = 1 (i = 1, 2, 5, 6), −2 (i = 3, 4) 의 평균이 0이 아니게 된다. 관측한 두 평균은 0.0983 과 0.1393 이었다.
볼프의 주사위에 세운 결함 가설 둘. 왼쪽: 눈을 파낸 만큼 상아가 빠져, 눈이 여섯인 면 쪽이 가볍고 무게중심이 눈이 하나인 면 쪽으로 옮겨 간다(t₁ = i − 3.5). 오른쪽: 3–4 방향이 조금 긴 상자라면 3과 4가 적힌 끝면은 좁고 나머지 네 면은 넓어, 3이나 4가 위로 오는 일이 드물어진다(t₂ = 1 또는 −2). 그림은 결함을 크게 과장했다
이 두 평균만 지키고 나머지는 가장 고르게 퍼뜨린 분포는 이 절의 골격 그대로 p(i) ∝ exp(θ₁t₁(i) + θ₂t₂(i)) 꼴이다. 두 평균을 맞추도록 풀면 θ₁ = 0.032, θ₂ = 0.072 이고, 분포는 (0.164, 0.170, 0.141, 0.146, 0.187, 0.193) 이 된다. 관측한 비율이 이 분포에서 우연으로 나올 만한지 다시 재면 그 확률은 약 2.5% 로, 10⁻⁵⁶ 에서 크게 올라왔다. 다만 흔히 쓰는 기준 5% 보다는 아직 작으므로, 두 결함이 차이의 대부분을 설명하지만 아주 작은 결함이 하나 더 있었을 수도 있다.
볼프의 주사위 2만 번에서 면마다 나온 비율(막대), 공정한 주사위의 1/6(점선), 결함 두 가지의 평균만 지키는 최대 엔트로피 분포(점). 점이 막대의 들쭉날쭉함을 대부분 따라간다
이 절의 결론을 실제 데이터로 읽으면, 골격의 t(x) 는 주사위의 물리적 결함 하나하나이고 θ 는 결함마다 붙는 계수다. 결함을 하나 더 의심하면 t 를 하나 더하고 θ 의 성분도 하나 늘리면 된다.
김민준
2만 번 던진 표가 있으면 지금은 카이제곱 검정 한 줄로 공정한 주사위인지 따질 수 있잖아요. 볼프도 그렇게 했겠죠?
선생님
피어슨(Karl Pearson)이 카이제곱 검정을 내놓은 게 1900년이에요. 볼프는 1893년에 세상을 떠났고요. 면마다 몇 번 나왔는지는 손에 있는데, 여섯 면이 1/6에서 벗어난 정도를 한꺼번에 놓고 우연인지 아닌지 재는 검정은 아직 없었어요.
이서연
그래도 4가 0.142, 6이 0.197 이면 눈으로도 차이가 보이잖아요.
선생님
보이죠. 그다음 물음이 더 어려워요. 주사위의 무엇이 틀렸느냐. 제인스는 주사위를 직접 보지 않고 비율 여섯 개만으로 그걸 따졌어요.
김민준
주사위를 못 보면 무게중심이 얼마나 옮겼는지는 잴 수가 없잖아요. 가설을 세워도 맞는지 어떻게 따져요?
선생님
제인스는 결함 하나를 「어떤 양의 평균이 0에서 벗어난다」로 바꿔 적었어요. 파낸 눈이면 t₁ = i − 3.5, 긴 상자면 t₂. 이렇게 바꿔 적는 데 쓴 최대 엔트로피 원리는 1957년에 제인스 자신이 세운 것이라, 볼프의 시대에는 그런 말도 셈법도 없었어요.
이서연
결함마다 평균 하나, 계수 θ 하나가 붙는 거네요. 그럼 exp(θ₁t₁ + θ₂t₂) 를 합이 1이 되게 나눌 때, 골격의 F와 k는 이 주사위에서 무엇이 되는 거예요?
문제 1. 평균만 전해 들은 주사위
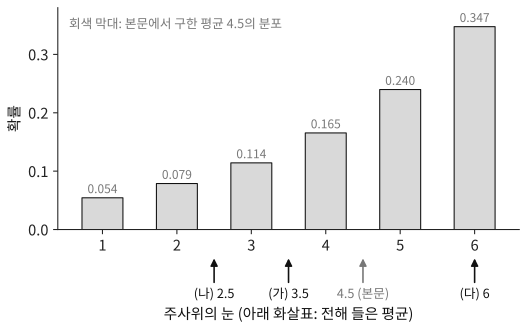
위 주사위처럼 평균만 전해 들었다. 평균을 지키면서 엔트로피가 가장 큰 분포를 구하고, 이웃한 두 면의 확률 비와 θ를 적어라. (가) 평균이 3.5 (나) 평균이 2.5(새로 계산하지 말고 평균 4.5의 답에서 구하라) (다) 평균이 6
본문에서 구한 평균 4.5의 최대 엔트로피 분포(회색 막대)와, 물음이 전해 준 세 평균 3.5, 2.5, 6의 자리(아래 화살표)(sources/07-지수족/problems_figs.py)
함께 풀기
김민준
(가)는 공정한 주사위 평균이니까 1/6씩 고르게요. 이웃 비는 1, θ = 0 이에요.
이서연
(나)는 눈을 뒤집으면 돼. 눈 x를 7 − x로 바꾸면 평균 2.5가 4.5로 바뀌니까, 4.5의 답을 거꾸로 읽으면 (0.347, 0.240, 0.165, 0.114, 0.079, 0.054). 이웃 비는 1/1.449 = 0.690, θ = −0.371.
선생님
(다)는요?
김민준
큰 눈 쪽으로 더 쏠리게 θ를 키우면 되죠. 돌려 보니 평균 5.9면 이웃 비가 11, 5.99면 101이에요. 6이 되려면 θ를 한 100쯤 넣으면…
선생님
평균이 정확히 6인 분포는 어떻게 생겼어요?
이서연
던질 때마다 6이어야 평균이 6이에요. 1부터 5까지는 확률 0, 답은 (0, 0, 0, 0, 0, 1) 하나뿐이에요.
김민준
그럼 θ를 100쯤 넣으면 그게 나오는 거 아냐?
이서연
그런데 exp(θx) 꼴은 θ가 아무리 커도 0을 못 만들어. θ = 100이어도 5는 6보다 e¹⁰⁰배 드물 뿐이지 0은 아니야.
선생님
그래요. 평균 6이면 고를 것도 없이 하나로 정해지는데, 그 하나는 θ를 끝없이 키울 때 다가가기만 하는 가족의 가장자리 너머에 있어요.
김민준
과제 평균이 만점이라는 말만 들으면 모두 만점이었다는 뜻이라 고르게 퍼뜨릴 여지가 없는 거네요.
문제 2. 푸아송의 네 번째 성분
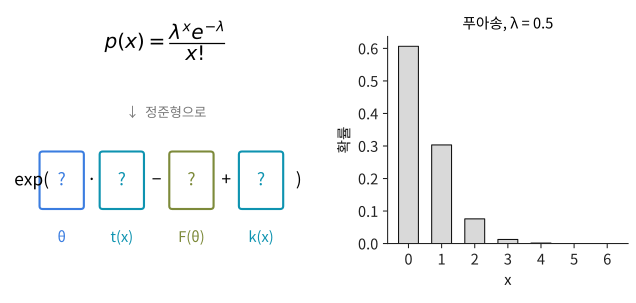
푸아송 분포 p(x) = λˣexp(−λ)/x! 를 정준형 exp(θ·t(x) − F(θ) + k(x)) 로 쓰고 네 성분을 밝혀라. 캐리어를 빼고 λ = 0.5 에서 확률을 x = 0부터 59까지 더하면 얼마인가? 모자라거나 남는 만큼 다시 나눠 합을 1로 맞추면 푸아송이 되는가? (위 위젯의 푸아송 카드에서 평균 λ를 0.5로 놓고 「캐리어 빼 보기」를 눌러 합을 확인할 수 있다.)
푸아송 분포의 식과 정준형의 네 자리 θ, t(x), F(θ), k(x)(비워 둠), 그리고 λ = 0.5 인 푸아송 분포(sources/07-지수족/problems_figs.py)
1.213 이요… 확률의 합이요? x! 을 빼먹었어요. 그런데 λ = 3 일 때처럼 끝없이 커지지는 않네요. 0.5ˣ 은 줄어드니까요.
이서연
유한하면 괜찮은 거 아냐? 1.213 으로 한 번 더 나누면 합이 1이 되잖아.
선생님
그렇게 나눈 분포의 x = 0, 1, 2 확률을 푸아송과 견줘 봐요.
이서연
0.5, 0.25, 0.125 예요. 푸아송은 0.607, 0.303, 0.076 이고요. 하나 늘 때마다 반씩 줄어드는 다른 분포예요. λ가 1 이상이면 나눌 합부터 끝없이 커지고요. 그럼 x! 은 어디에 넣지? x! 은 θ랑 상관없으니까 F에 넣으면 되지 않아? F(θ) = eᶿ + log x! 이렇게.
선생님
서연 학생, F는 무엇의 함수여야 하죠?
이서연
θ만의 함수요. 전체 확률을 1로 맞추는, θ마다 숫자 하나인 균형추니까… log x! 을 넣으면 x마다 균형추가 달라져요. 그건 균형추가 아니에요.
이서연
그래서 x에만 의존하는 조각은 따로 k(x) 자리가 있는 거네요. k(x) 자리를 비우면 가족 자체가 다른 가족으로 바뀌고요.
선생님
맞아요. k(x) 자리를 캐리어, 또는 기저측도라고 해요. θ가 무엇이든 x마다 깔려 있는 바탕 무게예요.
김민준
과제 채점표에서 기본 출석 점수는 과제 점수가 몇이든 따로 붙는 것 같은 거네요. 그걸 과제 점수 계산식에 넣으면 식이 꼬여요.
문제 3. 로짓에 같은 수를 더하면
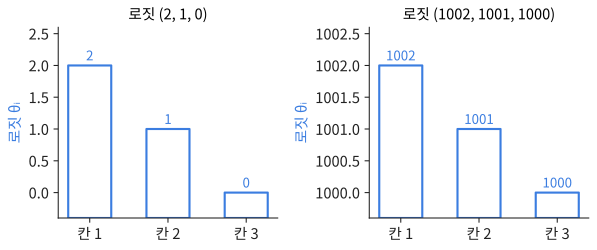
소프트맥스는 로짓 (θ₁, θ₂, θ₃)을 확률 pᵢ = exp(θᵢ) / Σⱼ exp(θⱼ) 로 바꾼다. (가) t(x)를 뽑힌 칸만 1인 원-핫 벡터로 잡고, 결과가 셋인 이 분포를 네 성분으로 써라. (나) 로짓 (2, 1, 0)과 (1002, 1001, 1000)이 주는 확률과 F 값을 구하라. (다) numpy 로 (나)의 두 번째를 식 그대로 계산하면 무슨 일이 생기고, 어떻게 피하는가?
물음의 두 로짓 (2, 1, 0)과 (1002, 1001, 1000). 오른쪽은 세로축을 1000 근처로 옮겨 그렸다(sources/07-지수족/problems_figs.py)