두 번째 등식 ∇²F(θ) = Cov[t(x)]는, 공분산 행렬에 음수 방향이 없으므로 F가 볼록함수임을 보장한다. 다만 조건이 하나 있다. 미분과 합(적분)의 순서를 바꾸었으므로, θ가 자연 파라미터 공간의 안쪽에 있어야 한다(아래 문제 9). F의 헤시안(두 번 미분한 행렬)이 곧 θ 좌표의 피셔 정보(파라미터를 조금 움직일 때 분포가 얼마나 민감하게 변하는지 재는 행렬)라는 것도 여기서 한 번 봐 두자.
η를 평균 내면 무엇이 되나
두 정규분포의 η를 반씩 평균 내면, 기댓값은 섞으면 섞인 대로 평균 나기 때문에 그 평균은 두 분포를 반반 섞은 혼합분포의 E[t(x)]와 같다. 그러나 혼합분포 자체는 봉우리가 둘일 수도 있어서 정규분포가 아니다. 그러면 정규분포 가족 안에서 그 η를 주소로 갖는 분포(혼합과 평균·이차모멘트가 같은 정규분포)는 혼합과 어떤 사이일까? 두 분포가 얼마나 다른지는 비대칭의 양인 KL 발산으로 잴 수 있다. 가족 안의 여러 정규분포 가운데 혼합까지의 KL이 가장 작은 것이 누구인지는 아래 문제에서 직접 재 본다.
결과가 유한한 범주분포(확률표) 전체에서는 결론이 달라진다. 확률표끼리는 섞어도 확률표이므로, 범주분포 전체에서는 η-직선 위의 점이 바로 두 분포를 섞은 혼합분포다. 정규분포족처럼 섞어서 얻은 분포가 가족 밖으로 나가면, η-직선 위의 점은 혼합을 대신하는 한 명이다.
직접 움직여 보기
불러오는 중…
파이썬
import numpy as np

mu, s = 1.0, 2.0
t1, t2 = mu / s**2, -1 / (2 * s**2)
F = lambda a, b: -a * a / (4 * b) + 0.5 * np.log(-np.pi / b)

h = 1e-5
g = [(F(t1 + h, t2) - F(t1 - h, t2)) / (2 * h), (F(t1, t2 + h) - F(t1, t2 - h)) / (2 * h)]
print(f"∇F(θ) 수치미분 = ({g[0]:.4f}, {g[1]:.4f})   (μ, μ²+σ²) = ({mu}, {mu**2 + s**2})")

x = np.random.default_rng(0).normal(mu, s, 2_000_000)
print("Cov[(x, x²)] 샘플:\n", np.round(np.cov(np.vstack([x, x**2])), 2))
print("정확한 값: [[σ², 2μσ²], [2μσ², 4μ²σ² + 2σ⁴]] =", [[s**2, 2 * mu * s**2], [2 * mu * s**2, 4 * mu**2 * s**2 + 2 * s**4]])

# η 의 평균 = 혼합의 모멘트 → 모멘트를 맞춘 정규분포
rng = np.random.default_rng(1)
mix = rng.normal(0, 1, 2_000_000) + rng.choice([-2, 2], 2_000_000)
print(f"½N(−2,1)+½N(2,1) 의 η = ({mix.mean():.3f}, {(mix**2).mean():.3f})  → 같은 η 의 정규분포 N(0, 5)")
# ∇F(θ) 수치미분 = (1.0000, 5.0000)   (μ, μ²+σ²) = (1.0, 5.0)
# Cov[(x, x²)] 샘플:
#  [[ 4.    8.02]
#  [ 8.02 48.1 ]]
# 정확한 값: [[σ², 2μσ²], [2μσ², 4μ²σ² + 2σ⁴]] = [[4.0, 8.0], [8.0, 48.0]]
# ½N(−2,1)+½N(2,1) 의 η = (0.000, 4.995)  → 같은 η 의 정규분포 N(0, 5)
이 절의 결론
“η는 데이터에서 바로 읽히는 좌표이자 F의 그래디언트이고, F의 헤시안은 t(x)의 공분산이라서 F는 볼록하다. η를 평균 낸 점은 섞인 두 분포의 모멘트를 평균 낸 주소다.”
문제 9. 그래디언트는 평균, 두 번 미분한 값은 공분산
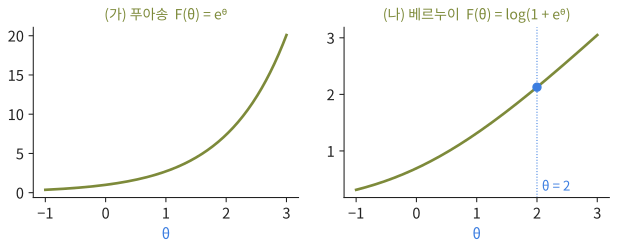
(가) 푸아송의 F(θ) = eᶿ 에서 F′(θ)와 F″(θ)를 구해, 푸아송 분포의 평균·분산과 견줘라. (나) 베르누이 F(θ) = log(1 + eᶿ) 에서 F″(θ) 를 수치로 구해 μ(1−μ) 와 비교하라. (다) 본문은 미분과 합(적분)의 순서를 바꿀 때 θ가 자연 파라미터 공간의 안쪽에 있어야 한다고 했다. 이 조건이 빠지면 무엇이 깨지는지 보이는 가족을 하나 만들어 보라.
(가) 푸아송의 로그정규화자 F(θ) = eᶿ, (나) 베르누이의 로그정규화자 F(θ) = log(1 + eᶿ)와 물은 자리 θ = 2(sources/07-지수족/problems_figs.py)
함께 풀기
이서연
(가)는 F′ = F″ = eᶿ = λ 예요. 푸아송은 평균과 분산이 둘 다 λ라고 배웠는데, 그게 여기서 한 번에 나오네요.
선생님
다른 가족에서도 두 번 미분한 값이 분산이 될까요?
이서연
본문처럼 Σ exp(θ·t − F + k) = 1 을 θ로 두 번 미분하면 어느 가족이든 ∇²F = Cov[t] 가 나와요. 이건 언제나 돼요. 공분산이니까 F는 언제나 볼록이고요.
김민준
(나)에서 이상한 게 나왔어요. θ = 2 에서 h = 1e-8 로 이차 차분을 했더니 F″ 이 −4.44 예요. 공분산이 음수라니, 그럼 F가 볼록이 아닌 거 아니에요?
선생님
참값은 얼마예요?
김민준
μ = 시그모이드(2) = 0.881, μ(1−μ) = 0.105 요. h = 1e-7 로 하면 0.044, 3e-8 이면 −0.49… h를 줄일수록 더 엉망이에요.
선생님
분자 F(θ+h) − 2F(θ) + F(θ−h) 는 얼마나 작아요?
김민준
0.105 × 10⁻¹⁶ 정도요. 그런데 F 자체가 2.13 이라 부동소수점 반올림 오차가 10⁻¹⁶ 쯤 깔려 있어요. 분자랑 오차가 같은 크기네요.
선생님
그 분자를 h² 으로 나누면요?
김민준
h² = 10⁻¹⁶ 이니까 오차가 1 크기로 부풀어요. 음수는 반올림 오차였어요.
선생님
이차 차분은 h = 1e-4 근처가 적당해요. 부호가 이상하면 식보다 먼저 숫자를 의심해요.
선생님
서연 학생, (다)요. "언제나 된다"고 했는데, 미분을 합 안으로 넣은 건 언제나 괜찮아요?
이서연
베르누이는 합이 두 항이라 괜찮은데… 적분이면 조건이 필요할 것 같아요. 그런데 안 되는 예가 떠오르지 않아요.
선생님
적분이 어떤 θ에서 겨우 유한해지는 가족을 일부러 만들어 봐요. x ≥ 0 에서 exp(θx)만 있으면 θ = 0 에서 적분이 무한이죠. 꼬리를 조금만 더 빨리 줄여 주는 바탕 무게를 붙이면요?
이서연
1/x² 쯤 줄여 주면 적분은 되니까, 0 근처에서 터지지 않게 1/(1 + x²)를 붙이면… x ≥ 0 에서 exp(θx)/(1 + x²). θ ≤ 0 이면 적분이 유한하고 θ > 0 이면 무한이에요.
선생님
θ = 0 에서 E[x] 는요?
이서연
(2/π) ∫ x/(1+x²) dx 인데… 무한대로 가요.
김민준
근데 F(0) 은 유한하잖아. 값은 있는데 평균은 무한대라고?
이서연
F(0) = log(π/2) 로 유한한데 평균은 무한대네. θ = 0 이 자연 파라미터 공간의 끝점이라, 오른쪽으로 미분할 수가 없어.
이서연
선생님, 제가 "언제나"라고 한 건 θ가 자연 파라미터 공간의 안쪽에 있을 때만 맞아요.
선생님
그래요. 안쪽에서는 지수족의 적분이 넉넉하게 수렴해서 미분과 적분을 바꿀 수 있어요. 끝점에서는 보장이 없어요.
이서연
해석학에서 "균등수렴이면 극한과 적분을 바꿔도 된다"를 조건 없이 쓰다가 감점당한 기억이 나요.
문제 10. η의 평균은 가족의 누구인가
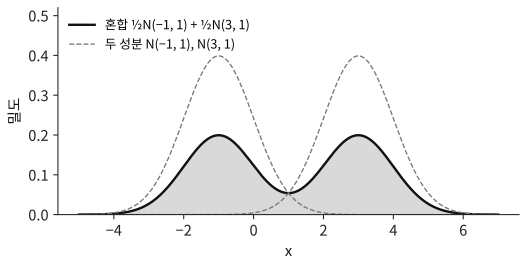
두 정규분포 N(−1, 1), N(3, 1) 의 η 를 반씩 평균 낸 점을 구하라. 그 η 를 주소로 갖는 정규분포는 무엇인가? 혼합 ½N(−1, 1) + ½N(3, 1) 과 그 정규분포, 그리고 분산만 다른 정규분포 몇 개 사이의 KL(혼합 ‖ q)를 재어 견줘라.
두 성분 N(−1, 1), N(3, 1)(파선)과 반반 혼합(회색 넓이)(sources/07-지수족/problems_figs.py)
함께 풀기
김민준
η 는 (−1, 2) 와 (3, 10) 이니까 평균은 (1, 6). 그러면 평균 1, 분산 6 인 N(1, 6) 이에요.
선생님
η₂ 는 무엇의 평균이었죠?
김민준
x² 의 평균이요… 분산이 아니라 이차모멘트였어요. 분산은 6 − 1² = 5. N(1, 5) 예요.
이서연
이상한데. 두 성분의 분산이 둘 다 1 인데 같은 η 의 정규분포는 분산이 5 야. 성분 분산을 그대로 가져오면 N(1, 1) 이어야 할 것 같은데.
선생님
그 N(1, 1) 의 E[x²] 는요?
이서연
2 요. 그런데 η₂ 는 6 이었어요. 4 나 차이가 나요.
선생님
그 4 는 어디서 왔을까요? 성분 하나의 E[x²] 부터 봐요.
이서연
각 성분의 E[x²] 는 분산 1 에 자기 평균의 제곱을 더한 거예요. 아, 그럼 혼합의 분산에는 성분 평균 −1 과 3 이 퍼진 정도 4 가 더 들어가요. 1 + 4 = 5 예요.
선생님
두 후보로 KL(혼합 ‖ q) 를 재 봐요.
김민준
N(1, 1) 은 1.367, N(1, 5) 는 0.172 예요. 분산을 4 나 6 으로 바꾸면 0.185, 0.180 이라 5 가 가장 작아요. 위젯에서 분산 배율을 움직여도 1 에서 가장 작아요.
선생님
정규분포 가족 안에서 혼합에 가장 가까운(KL(혼합 ‖ q) 최소) 한 명이 모멘트가 같은 N(1, 5) 예요. 이렇게 고르는 일을 m-사영이라고 불러요. m 은 혼합(mixture)의 머리글자예요. η 직선 위의 점은 혼합 자체가 아니라 혼합을 대신하는 한 명이에요.
김민준
두 조의 발표를 한 슬라이드로 합칠 때, 두 결론을 붙여 놓는 게 혼합이고, 평균 낸 결론 하나로 쓰는 게 모멘트 일치네요. 평균 결론은 두 조 누구의 주장과도 다를 수 있고요.
풀어 본 뒤 위 위젯(혼합분포와 같은 η 의 정규분포를 겹쳐 그린 그림)의 「문제 10 불러오기」 단추로 두 성분을 불러와, 분산 배율을 움직이며 KL(혼합 ‖ q)이 가장 작은 곳을 확인해 보자.
문제 11. 왜 크로스 엔트로피의 그래디언트는 「확률 빼기 정답」일까?
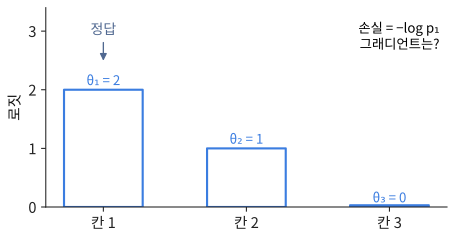
분류 모델이 로짓 (θ₁, θ₂, θ₃) = (2, 1, 0)을 내놓았고 정답은 첫째 칸이며, 손실은 크로스 엔트로피 −log p₁ 이다. (가) 손실을 세 로짓으로 미분한 그래디언트를 구하라. (나) 그래디언트 세 성분을 더하면 얼마이고, 왜 그런가? (다) 손실을 로짓으로 두 번 미분한 행렬은 무엇인가?
분류 모델이 내놓은 로짓 (2, 1, 0)과 정답 칸(sources/07-지수족/problems_figs.py)
함께 풀기
김민준
−log p₁ 을 미분하면 −1/p₁ 이니까, p₁ = 0.665 에서 −1.503 이에요. 나머지 두 로짓은 손실 식에 안 나오니까 그래디언트 성분이 0 이고요.
선생님
둘째 로짓을 올리면 p₁ 은 어떻게 돼요?
김민준
내려가요… 분모에 exp(θ₂)가 있으니까요. 그럼 그래디언트의 둘째 성분이 0 일 리가 없네요. −1/p₁ 은 확률로 미분한 거지 로짓으로 미분한 게 아니었어요.
이서연
로짓으로 바로 미분하려면 지수족 꼴로 써 보는 게 낫겠다. log p(x) = θ·t(x) − F(θ) 이니까 정답이 y 일 때 손실은 F(θ) − θ·t(y). 로짓으로 미분하면 ∇F(θ) − t(y).
김민준
∇F 는 숫자로 뭔데?
이서연
η 잖아. η 는 원-핫 벡터의 평균이니까… 확률 벡터 그 자체네. 그래디언트는 (0.665, 0.245, 0.090) − (1, 0, 0) = (−0.335, 0.245, 0.090).
김민준
수치미분으로도 (−0.335, 0.245, 0.090) 이에요. 소프트맥스 크로스 엔트로피의 그래디언트가 「확률 빼기 정답」이라고 외웠던 게 이거였네요. η 빼기 t(y) 였어요.
선생님
(나)는요?
김민준
−0.335 + 0.245 + 0.090 = 0 이에요.
이서연
로짓 셋에 같은 수를 더해도 분포가 그대로였잖아. 손실도 그대로니까 (1, 1, 1) 방향으로는 그래디언트 성분이 0 이어야 해. 식으로도 확률의 합 1 에서 정답의 합 1 을 빼니까 0 이고.
선생님
(다)는요?
이서연
∇²F 는 t 의 공분산이니까 원-핫 벡터의 공분산, diag(p) − ppᵀ 예요. 이 공분산 행렬도 (1, 1, 1) 방향으로는 0 이라 고윳값 하나가 0 이어야 해요.
김민준
계산해 보니 고윳값이 0, 0.119, 0.371 이에요.
선생님
그래요. 앞에 어떤 신경망이 있든, 마지막 로짓에서 손실까지의 그래디언트는 η − t(y), 두 번 미분한 행렬은 Cov[t] 로 이미 정해져 있어요.