같은 정규분포를 (μ, σ)로도 쓸 수 있고 다른 방식으로도 쓸 수 있다면, 어떤 방식이 분포의 '진짜 주소’일까?
집 주소: 행정 구역의 언어
“서울시 강남구 역삼동 123” 이 주소는 행정 구역의 언어다. 주소를 보면 "강남구에 있구나"는 바로 알지만, "역삼역에서 몇 미터인가"는 바로 안 보인다.
θ는 지수족의 "행정 주소"다. 골격 exp(θ·t(x) − F(θ) + k(x))에서 θ는 지수 안에 직접 들어앉는 좌표다. 그래서 자연 파라미터(natural parameter)라 부르는데, 집 주소에 견주어 보면 이렇다. θ를 보면 log p가 θ에 대해 곧은 식이라는 것(「어느 구에 있는지」)은 바로 안다. 하지만 그 분포의 평균이 얼마인지(「역에서 몇 미터인지」)는 θ만 봐서는 안 보이고 한 번 계산해야 나온다. 평균 3, 표준편차 2인 정규분포의 θ는 (0.75, −0.125)인데, 이 두 숫자에서 평균 3을 읽어 내려면 다음 소절의 식 μ = −θ₁/(2θ₂) 를 거쳐야 한다.
θ₁과 θ₂가 움직이는 방향
자연 파라미터의 두 성분이 어떻게 묶여 움직이는지 보려면 성분이 둘은 있어야 하는데, 베르누이나 푸아송은 자연 파라미터가 하나뿐이라 서로 묶일 것이 없다. 그래서 파라미터가 둘인 가장 익숙한 가족인 정규분포를 골라, 그 θ = (μ/σ², −1/(2σ²)) 를 거꾸로 풀면 이렇다.
θ₁만 움직이면 σ는 그대로이고 평균만 μ = θ₁σ² 로 움직인다. θ₂를 움직이면 폭이 바뀌는데, μ = −θ₁/(2θ₂) 에 θ₂가 들어 있기 때문에 θ₁ ≠ 0 이면 평균도 함께 끌려간다. (μ, σ) 좌표에서는 μ가 평균만, σ가 폭만 바꾸었는데, θ 좌표에서는 두 성분이 평균과 폭에 함께 묶여 있다.
θ가 직관적이지 않은 대신 얻는 것이 있다. 두 분포의 로그를 섞은 뒤 합이 1이 되게 다시 나누는(정규화) 길, 이 책에서 e-길(e는 exponential, 지수)이라 부르는 길이 θ 좌표에서 직선이 된다. log p와 log q를 3 : 1로 섞으면 지수 안의 θ도 그대로 3 : 1로, ¾θp + ¼θq 로 섞이기 때문이다. 반반으로 섞으면 두 θ의 한가운데다.
직접 움직여 보기
불러오는 중…
파이썬
import numpy as np

def to_theta(mu, sigma):
    return mu / sigma**2, -1 / (2 * sigma**2)

def from_theta(t1, t2):
    s2 = -1 / (2 * t2)
    return float(t1 * s2), float(np.sqrt(s2))

for mu, sigma in [(0, 1), (3, 2), (174, 5.8)]:
    t1, t2 = to_theta(mu, sigma)
    print(f"(μ, σ) = ({mu}, {sigma})  →  θ = ({t1:.4f}, {t2:.4f})  →  {tuple(round(v, 4) for v in from_theta(t1, t2))}")

t1, t2 = to_theta(3, 2)
print("θ₁ 만 두 배:", tuple(round(v, 4) for v in from_theta(2 * t1, t2)))
print("θ₂ 만 두 배:", tuple(round(v, 4) for v in from_theta(t1, 2 * t2)))
# (μ, σ) = (0, 1)  →  θ = (0.0000, -0.5000)  →  (0.0, 1.0)
# (μ, σ) = (3, 2)  →  θ = (0.7500, -0.1250)  →  (3.0, 2.0)
# (μ, σ) = (174, 5.8)  →  θ = (5.1724, -0.0149)  →  (174.0, 5.8)
# θ₁ 만 두 배: (6.0, 2.0)
# θ₂ 만 두 배: (1.5, 1.4142)
θ₁을 두 배로 하면 σ는 그대로 2이고 평균만 6이 되지만, θ₂를 두 배로 하면 σ가 1.414로 줄면서 평균도 1.5로 끌려간다.
이 절의 결론
“θ는 지수족의 골격에 맞춘 좌표이고, e-길(로그를 섞고 다시 정규화하는 길)이 직선이 되는 좌표다. θ의 두 성분은 (μ, σ)와 달리 평균과 폭에 함께 묶여 있다.”
문제 7. e-길의 한가운데
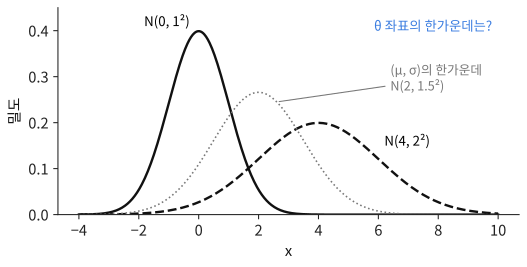
두 정규분포 N(0, 1²)과 N(4, 2²)이 있다. (가) 두 분포의 θ를 구하고, θ 좌표의 한가운데(로그를 반반 섞은 점)가 어떤 정규분포인지 (μ, σ)로 적어라. (나) (μ, σ) 좌표에서 한가운데를 잡으면 N(2, 1.5²)이다. 두 답의 평균은 왜 다른가? (위 위젯의 자연 파라미터 슬라이더를 θ₁ = 0.5, θ₂ ≈ −0.31 에 맞추면 (가)의 분포를 그림으로 볼 수 있다.)
두 정규분포 N(0, 1²), N(4, 2²)와 문제가 준 (μ, σ) 좌표의 한가운데 N(2, 1.5²)(점선)(sources/07-지수족/problems_figs.py)
로그를 반반 섞는 건 두 밀도를 곱해 제곱근을 씌우고 다시 나누는 거예요. 곱하면 두 분포가 함께 높은 곳만 남고요.
선생님
두 분포가 함께 높은 곳은 어디예요?
이서연
좁은 N(0, 1²)은 0 근처에서만 높으니까 0 근처요. 그래서 0 쪽으로 모여요. (μ, σ)의 한가운데 N(2, 1.5²)은 두 숫자의 가운데일 뿐이고요.
김민준
시험 범위를 조교는 「3장 근처」라고 딱 짚고 선배는 「1장에서 8장 사이 어딘가」라고 하면, 둘을 합칠 때 조교 말 쪽으로 기우는 거랑 같네요.
문제 8. 조건을 더 세게: 로짓을 늘여 더하기
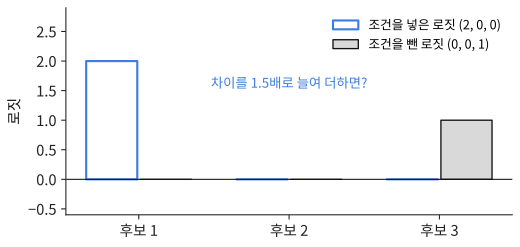
언어 모델이 프롬프트의 조건을 더 세게 따르게 하는 방법이 있다. 조건 없이 낸 로짓에서 조건을 넣고 낸 로짓 쪽으로 가는 차이를 1보다 크게 늘여 더한다(분류기 없는 안내, classifier-free guidance). 2023년 산체스(Sanchez) 등의 논문은 언어 모델에서 이 배율을 1.5로 둔 실험을 보고했다. 다음 단어 후보 셋에 대해 조건을 넣은 로짓이 (2, 0, 0), 뺀 로짓이 (0, 0, 1)이다. (가) 차이를 1.5배로 늘여 새 로짓을 만들고 확률을 구하라. (나) 같은 1.5배를 로짓이 아니라 확률에 적용하면 어떻게 되는가?
다음 단어 후보 셋에 대한 두 로짓. 조건을 넣은 로짓 (2, 0, 0)과 뺀 로짓 (0, 0, 1)(sources/07-지수족/problems_figs.py)
함께 풀기
김민준
(나)부터 해 봤어요. 확률은 조건을 넣으면 (0.787, 0.107, 0.107), 빼면 (0.212, 0.212, 0.576). 뺀 쪽에서 넣은 쪽으로 가는 차이를 1.5배로 늘여 더하면 (1.075, 0.054, −0.128)… 음수가 나와요. 그럼 이 방법에 1.5배 같은 건 애초에 못 쓰는 거 아니에요?