분류 모델이 세 가지 답에 확률을 나눠 준다고 하자. 현실에서 세 답이 나오는 비율이 A라면, 모델 B와 모델 C 가운데 어느 쪽이 A에 더 가까울까? 거리를 재 보기 전에, 재는 방법이 하나뿐인지부터 물어야 한다.
결과가 셋인 분포 세 개를 심플렉스(세 확률의 합이 1인 점들이 이루는 삼각형) 위에 놓는다.
A = (0.5, 0.3, 0.2), B = (0.6, 0.39, 0.01), C = (0.25, 0.25, 0.5).
유클리드 거리로 재면 A–B는 0.233, A–C는 0.394여서 A는 B에 더 가깝다. 그런데 이 절에서 정의할 KL 발산으로 A에서 재면 A–B는 0.429, A–C는 0.218이어서 이번에는 C가 더 가깝다. 같은 세 점인데 재는 방법만 유클리드 거리에서 KL 발산으로 바꿨다.
무엇이 순위를 뒤집었을까? 현실 A는 결과 3에 20%를 주는데, 모델 B는 같은 결과 3에 겨우 1%만 남겨 둔다. 유클리드 거리에게 0.2와 0.01의 차이는 0.19라는 작은 좌표 차이일 뿐이지만, KL 발산에게는 "현실에서 다섯 번에 한 번 일어나는 일을 모델이 백 번에 한 번이라고 우긴다"는 심각한 착오다.
점을 "어떤 공간에 놓느냐"에 따라 가까움이 달라지듯, 같은 공간 안에서도 "무엇으로 재느냐"에 따라 보이는 구조가 달라진다. 공간을 바꾸는 것과 재는 방법을 바꾸는 것은 같은 동전의 양면이다.
읽을 때는 두 줄 세로선 ‖ 의 왼쪽에 현실 p, 오른쪽에 모델 q를 쓴다는 것부터 기억하자. 결과마다 "현실의 확률 ÷ 모델의 확률"에 로그를 씌우고, 현실에서 그 결과가 일어나는 확률을 무게로 삼아 평균을 낸다. 모델이 현실과 똑같으면 모든 비가 1이고 로그가 0이라서 KL도 0이다. 모델이 현실에서 흔한 결과를 드물다고 하면 그 결과의 비 pi ÷ qi가 커지고, 현실이 그 결과에 준 확률 pi만큼 페널티가 붙는다.
앞의 A를 현실 p 자리에, B를 모델 q 자리에 두고 결과마다 칸을 채워 보면 이렇다.
결과
현실 A
모델 B
비 A ÷ B
log(비)
A × log(비)
1
0.5
0.6
0.833
−0.182
−0.091
2
0.3
0.39
0.769
−0.262
−0.079
3
0.2
0.01
20
3.00
0.599
합
0.429
셋째 결과 한 칸이 0.599로 합 0.429보다 크고, 모델이 현실보다 후하게 준 결과 1, 2의 두 칸은 음수라서 그 합을 조금 깎아 낼 뿐이다. 그러니 “다섯 번에 한 번을 백 번에 한 번이라 우긴” 착오가 KL의 거의 전부다.
KL 발산의 정의 식이 왜 하필 로그를 쓰는지, 왜 항상 0 이상인지는 아직 말하지 않는다. 지금은 읽는 법만 손에 익히자.
p와 q의 역할
이 교재에서 p는 항상 “현실”(진짜 분포), q는 항상 “지도”(모델)다. KL(p‖q)는 “현실 p의 눈으로 본, 지도 q의 부정확함”. 평균을 내는 무게가 p라서, 현실에서 흔한 곳의 오차가 크게 잡힌다. KL(q‖p)는 “지도 q의 눈으로 본, 현실 p와의 어긋남”. 이번에는 무게가 q라서, 모델이 확신하는 곳의 오차가 크게 잡힌다. 이처럼 같은 두 분포라도 누구의 눈으로 보느냐에 따라 KL의 값이 서로 달라진다.
왜 "거리"가 아니라 "발산"인가
KL은 항상 0 이상이고 0이면 두 분포가 같으므로 거리의 네 약속 가운데 첫 두 개는 지키지만, 대칭이 아니고 삼각부등식도 늘 지키지는 않는다. 세 분포를 잘 고르면 한 분포를 거쳐 돌아가는 쪽의 KL 합이 곧장 잰 KL보다 작게 나온다(피셔 정보를 다루는 절 끝의 문제 8에서 동전 셋으로 직접 확인한다). 그래서 수학자들은 이것을 거리(distance)라 부르지 않고 "한 점에서 다른 점으로 벌어져 나가는 정도"라는 뜻으로 발산(divergence)이라 부르며, 이 책도 KL을 거리라 부르지 않고 늘 "KL 발산"이라 부른다.
직접 움직여 보기
불러오는 중…
ML에서: 크로스 엔트로피 손실과 KL(p‖q)
분류 모델을 학습시킬 때 흔히 쓰는 크로스 엔트로피 손실 −Σ pi log qi 를 KL의 정의와 나란히 놓아 보자. KL(p‖q) = Σ pi log pi − Σ pi log qi 이므로, 크로스 엔트로피는 KL(p‖q)에 −Σ pi log pi(p의 엔트로피, 분포가 얼마나 고르게 퍼졌는지 재는 값)를 더한 것이다. 여기서 데이터의 정답 비율이 p, 학습하는 모델의 출력이 q다. 크로스 엔트로피로 학습하면 두 모델 가운데 어느 쪽을 고르는지, KL의 방향을 바꿔 재면 그 판단이 뒤집히는지는 아래 문제 5에서 따져 본다.
이 절의 결론
“KL은 확률 세계의 무빙워크다.” 같은 두 분포라도 누구를 현실 자리에 두고 누구를 모델 자리에 두느냐에 따라 KL의 값이 달라진다.
인물 이야기: 쿨백과 암호해독에서 나온 KL 발산
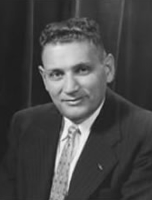
솔로몬 쿨백(1907–1994). 출처: Wikimedia Commons(미국 국가안보국 사진), 미국 정부 저작물이라 퍼블릭 도메인
사진: 솔로몬 쿨백(1907–1994). 출처 Wikimedia Commons(미국 국가안보국 사진), 미국 정부 저작물이라 퍼블릭 도메인
1930년 봄, 미 육군 신호정보국(Signal Intelligence Service)을 새로 꾸리던 윌리엄 프리드먼(William Friedman)이 공무원 시험으로 젊은 수학자 셋을 암호분석가로 뽑았다. 프랭크 롤렛, 에이브러햄 싱코프, 그리고 뉴욕 시립대학에서 수학을 공부한 솔로몬 쿨백(Solomon Kullback)이었다. 쿨백은 낮에는 암호를 풀고 밤에는 조지워싱턴 대학에서 공부해 1934년 수학 박사학위를 받았다.
암호해독은 빈도를 비교하는 일이다. 평문 언어에서 글자가 나오는 빈도와 암호문에서 기호가 나오는 빈도를 맞대 보고, 어떤 추측이 맞다면 지금 본 암호문이 얼마나 그럴듯한지를 따진다. 쿨백은 롤렛과 함께 일본 외무성의 암호기계(미국 쪽 암호명 RED)를 가로챈 전문만으로 풀어냈다. 전쟁 중인 1942년에는 영국 블레츨리 파크에 파견되어 영국이 독일 에니그마 암호를 읽어 내고 있다는 것을 보고 왔고, 돌아와서는 일본 암호를 맡은 부서의 책임자가 되었다.
그 블레츨리 파크에서 앨런 튜링(Alan Turing)은 관측 하나가 한 가설을 얼마나 편드는지를 로그 우도비(두 가설이 그 관측에 준 확률, 곧 우도의 비에 로그를 씌운 값)로 재어 더해 나가는 방법을 썼고, 로그 우도비를 재는 단위로 「밴(ban)」을 만들었다. 함께 일한 굿(I. J. Good)은 로그 우도비를 「증거의 무게」라고 불렀다. 증거의 무게를 한 가설이 옳다고 보고 평균 낸 값이 뒤에 KL 발산이라 불릴 양이고, 굿은 나중에 KL 발산을 「증거의 무게의 기댓값」이라 부르기도 했다.
영어 평문의 글자 빈도와 26글자가 고르게 나오는 무작위 글을 두 가설로 놓으면, 같은 증거의 무게 막대도 영어 평문에 서서 평균하면 글자당 +1.57 데시밴, 무작위 글에 서서 평균하면 −2.63 데시밴으로 크기가 다르다. 직접 그린 그림, 글자 빈도는 Lewand 『Cryptological Mathematics』(2000)의 표(위키백과 「Letter frequency」)
전쟁이 끝나고 미국의 암호 기관들은 하나로 합쳐졌다(1949년 군 보안국, 1952년 국가안보국 NSA). 그 통합 기관에서 쿨백은 일리노이 대학 박사 출신의 수학자 리처드 라이블러(Richard Leibler)와 함께 일했다. 두 사람이 1951년에 발표한 논문 「정보와 충분성에 대하여」(On Information and Sufficiency)가 KL 발산에 이름과 체계를 주었다. 논문은 KL 발산을 "가설 1이 옳을 때, 관측 하나가 가설 1과 가설 2를 가려 주는 평균 정보"로 정의했다.
KL 발산은 대칭이 아니었다. "가설 1이 옳다고 보고 잰 평균"과 "가설 2가 옳다고 보고 잰 평균"은 다르므로, 비대칭은 KL 발산이 본래 가진 성질이었다. 암호해독에서 "내가 서 있는 가설"이 무엇인가에 따라 증거의 무게가 달라지는 것은 자연스러운 일이니까. 논문은 두 방향을 더한 대칭인 합에 「발산(divergence)」이라는 이름을 붙였는데, 이 합은 해럴드 제프리스(Harold Jeffreys)가 1948년 『확률론』 둘째 판에서 이미 쓰던 것이었다. 쿨백은 뒤에 한쪽 방향만 잰 양을 「방향이 있는 발산(directed divergence)」이라 불렀고, 오늘날의 「KL 발산」은 이 한쪽 방향을 가리킨다. KL 발산이 늘 0 이상이라는 부등식은 그보다 앞서 통계역학의 깁스(Josiah Willard Gibbs)가 쓴 것이라 「깁스 부등식」이라 불린다.
쿨백은 1962년 NSA 수석 과학자로 은퇴할 때까지 30년 넘게 암호 기관에서 일했고, 은퇴한 뒤에는 조지워싱턴 대학에서 가르쳤다. 그의 이름이 붙은 KL 발산은 기계학습에서 손실함수의 핵심 재료가 되었고, 정보기하학에서는 공간의 구조를 정하는 양이 되었다. 암호해독가의 실용적 질문이 수학의 근본 개념이 되었다.
김민준
빈도를 맞대 보고 로그 우도비를 더해 가는 거면, 지금은 numpy 몇 줄이잖아요. 그런데 KL 발산이라는 이름은 1951년에야 붙었네요.
선생님
관측 하나의 증거를 밴으로 재서 더하는 법은 전쟁 중에도 있었어요. 그런데 전문을 받아 보기 전에 알고 싶은 것이 하나 더 있지 않을까요? 이 가설을 가려내려면 전문이 평균 몇 통 필요한가 같은 것.
이서연
음, 증거의 무게는 관측마다 다르니까 평균을 내야겠네요. 그런데 무엇을 무게로 평균을 내요? 어느 가설이 맞는지 모르는 채로요.
선생님
그게 막혔던 데예요. 게다가 그때는 「관측 하나가 주는 정보」를 수로 부르는 말이 없었어요. 섀넌이 정보를 비트로 세는 이론을 낸 것이 1948년이고, 쿨백과 라이블러의 논문은 그 3년 뒤예요.
김민준
아, 그래서 논문이 "가설 1이 옳을 때"라고 먼저 못 박은 거구나. 하나를 옳다고 정해야 그 가설의 확률로 평균을 낼 수 있으니까.
이서연
그러면 KL(p‖q)에서 ‖ 왼쪽의 p가 「옳다고 정한 가설」이고, 평균의 무게도 p인 거네요. 가설 2를 옳다고 정하면 증거의 평균은 얼마나 달라져요?
문제 2. 두 동전, 두 방향
공정한 동전 (0.5, 0.5)과 기운 동전 (0.9, 0.1)에 대해 KL(공정‖기운)과 KL(기운‖공정)을 각각 구하라. 어느 쪽이 더 크고, 왜 그런가?
공정한 동전 (0.5, 0.5)과 기운 동전 (0.9, 0.1)의 앞면·뒷면 확률
함께 풀기
선생님
동전 두 개, 방향 두 개. 숫자가 몇 나왔어요?
김민준
벌써 돌렸어요. KL(공정‖기운)이 0.511이고 KL(기운‖공정)은 0.368이요.
이서연
나도 같아. 손으로 해도 0.5 log(0.5/0.9) + 0.5 log(0.5/0.1)이니까 0.511 맞아.
선생님
좋아요. 그럼 왜 앞쪽이 커요?
김민준
음… 공정한 동전이 더 "무작위"하니까요? 엔트로피가 크니까 KL도 크다, 이런 거 아닐까요.
선생님
그 논리대로면 엔트로피가 큰 쪽이 앞에 오면 항상 KL이 커야겠네요. 서연 학생, 그런 것 같아요?
이서연
아니요, 식을 보면 엔트로피는 직접 안 들어가요. 항별로 보면… 공정한 동전이 뒷면에 0.5를 주는데 기운 동전은 0.1만 줘요. 그 항이 0.5 × log 5라서 0.80이에요. 거의 다 거기서 나와요.
선생님
맞아요. KL(p‖q)는 p가 자주 보는 곳에서 q가 얼마나 인색한지를 봐요. 공정한 동전에게 뒷면은 두 번에 한 번 보는 흔한 일인데, 기운 동전은 그걸 열 번에 한 번이라고 하니까요.
김민준
아, 반대 방향은 기운 동전이 뒷면을 거의 안 보니까 그 항이 가볍게 눌리는 거고요.
김민준
팀 과제 채점 기준표를 누가 만드느냐랑 비슷하네요. 조교가 만들면 조교가 중요하게 보는 항목에서 깎이고, 학생이 만들면 또 다른 데서 깎이고.
선생님
그 비유 괜찮아요. 무게를 누가 쥐고 있느냐, 그게 KL의 방향이에요.
문제 3. A를 모델 q 자리에 두면
앞에서 본 세 분포 A, B, C를 다시 쓴다. 이번에는 A를 모델 q 자리(‖의 오른쪽)에 두고 KL(B‖A)와 KL(C‖A)를 비교하라. A와 더 가까운 점은 여전히 C인가?
심플렉스 위의 세 분포 A, B, C. 점선 화살표는 B에서 A로, C에서 A로 재는 두 KL의 방향이다
함께 풀기
김민준
이건 위젯에서 봤어요. C가 더 가까워요. KL은 B를 싫어해요, B가 결과 3에 1%밖에 안 주니까.
선생님
위젯 버튼은 어느 쪽에 놓여 있었어요?
김민준
…KL(A‖·)요. 아, 문제는 KL(·‖A)네요.
이서연
계산해 보면 KL(B‖A)가 0.182, KL(C‖A)가 0.239야. 이번엔 B가 더 가까워.
선생님
왜 다시 뒤집혔을까요?
이서연
이번엔 무게를 B가 쥐어요. B는 결과 3을 거의 안 보니까, A가 거기에 20%를 줬든 말든 신경을 안 써요. 1% 곱하기 로그라서 작아요.
이서연
그러니까 "A와 가장 가까운 점"이라는 질문 자체가 방향을 정해야 성립하는 질문이네요.
김민준
팀플 동료평가 같네. 내가 조원들을 매긴 순위랑 조원들이 나를 기준으로 매긴 순위가 다른 것처럼.
선생님
그래요. 유클리드 거리에서는 "가까운 점"이 하나지만, KL에서는 누가 현실이고 누가 모델인지 먼저 정해야 해요.
문제 4. 모델이 0이라고 우기면
B = (0.6, 0.39, 0.01)의 셋째 칸을 더 줄여 Bε = (0.6, 0.4 − ε, ε)로 쓴다(ε = 0.01이면 B 그대로다). (가) ε = 0.001, 0.0001, 10⁻⁶, 10⁻¹²에서 KL(A‖Bε)를 구하라. ε → 0이면 어떤 값에 다가가는가? (나) 방향을 바꾼 KL(Bε‖A)는 어떻게 되는가? (다) ε = 0을 그대로 numpy에 넣으면 무엇이 나오고, numpy가 내놓은 결과를 어떻게 읽어야 하는가?
결과 3에 준 확률을 로그 눈금으로 그린 막대. 현실 A는 0.2, 모델의 셋째 칸 ε는 10⁻², 10⁻³, 10⁻⁴, 10⁻⁶, 10⁻¹²
함께 풀기
김민준
(가) 돌렸어요. 0.883, 1.343, 2.264, 5.027이에요. 커지긴 하는데 10⁻⁶에서 10⁻¹²로 백만 배를 줄였는데도 2.8밖에 안 늘었어요. 이렇게 더디면 어디선가 멈추지 않을까요? 6쯤에서요.
선생님
ε를 열 배 줄일 때마다 얼마씩 늘었어요?
이서연
0.001에서 0.0001로 갈 때 0.46이요. 그다음 칸들도 열 배마다 비슷하게 늘어난 것 같은데요.
선생님
ε가 들어간 건 셋째 칸뿐이에요. 그 항만 떼어 써 보면요?
이서연
셋째 칸 항이 0.2 × log(0.2/ε)이니까, ε를 열 배 줄이면 0.2 × log 10 ≈ 0.46씩 늘어요. 몇 번을 줄여도 늘 같은 만큼 늘어요.
김민준
열 배 줄일 때마다 0.46씩이면… 멈추는 게 아니라 끝없이 커지는 거네요. 더디게 커지는 것과 멈추는 것은 다르구나.
선생님
(나)는요?
김민준
0.218, 0.224, 0.224, 0.224. 이건 정말로 0.224쯤에서 멈춰요.
선생님
같은 두 분포인데 KL(A‖Bε)는 끝없이 커지고 KL(Bε‖A)는 멈춰요. 왜 그럴까요?
이서연
아까처럼 셋째 칸 항만 보면… KL(Bε‖A)에서는 ε × log(ε/0.2)예요. log는 −∞로 가는데 앞에 ε가 곱해져 있어요. 어느 쪽이 이기지?
선생님
ε가 0으로 가는 빠르기와 log가 −∞로 가는 빠르기, 어느 쪽이 빨라요?
이서연
ε 쪽이요. 그러면 항 전체가 0으로 가요.
김민준
그럼 (가)에서는 왜 안 멈춰? 같은 셋째 칸인데.
이서연
(가)에서는 로그 앞에 곱한 게 ε가 아니라 A의 무게 0.2야. 0.2가 그대로 남은 채 로그만 커져. (나)에서는 무게를 쥔 Bε가 결과 3을 거의 안 보니까, 결과 3에서 두 분포가 어긋난 것이 KL 합에 거의 안 들어가고.
nan은 셋째 칸의 0 × log 0에서 나왔을 거야. numpy는 0 × (−inf)를 계산하지 못하지만, 방금 본 대로 ε × log ε는 0으로 가니까 셋째 칸 항은 0으로 두면 돼. 그러면 0.224가 나와서 (나)에서 본 값과 이어져.
선생님
그래요. 0 × log 0은 0으로 약속하고, 현실에서 일어나는 결과에 모델이 0을 주면 KL은 무한대로 둬요. inf는 망가진 값이 아니라 정직한 답이에요.
김민준
문제 1 (나)에서 무빙워크가 걷는 속도보다 빨라지니까 C → A만 영영 못 가던 거랑 같네요. 현실에서 일어나는 결과를 모델이 0이라고 우기면, KL(A‖B₀) 방향만 끝없이 커져요.
이서연
해석학 시간에 x log x가 0에서 0으로 간다는 걸 로피탈 정리로 보였는데, 그게 nan을 0으로 바꿔 주는 근거였네요.
문제 5. 크로스 엔트로피는 어느 쪽 KL을 고르나
사진 묶음의 정답 비율이 p = (고양이 0.7, 개 0.2, 여우 0.1)이다. 모델 가는 q₁ = (0.8, 0.19, 0.01)을, 모델 나는 q₂ = (0.5, 0.25, 0.25)를 낸다. (가) 두 모델의 크로스 엔트로피 −Σ pi log qi 를 구하라. 크로스 엔트로피로 학습하면 어느 모델을 더 낫다고 보는가? (나) 두 모델에 대해 KL(p‖q)와 KL(q‖p)를 구하라. 두 방향의 순위는 같은가? (다) 크로스 엔트로피의 순위는 왜 한쪽 방향 KL의 순위와 늘 같은가?
사진 묶음의 정답 비율 p와 두 모델 가(q₁), 나(q₂)가 고양이·개·여우에 준 확률
함께 풀기
김민준
(가) 가는 0.949, 나는 0.901이에요. 나 쪽 손실이 작으니까 학습은 나를 더 낫다고 봐요.
이서연
(나) KL(p‖q)는 가가 0.147, 나가 0.099야. 크로스 엔트로피랑 같은 순서네.
김민준
크로스 엔트로피에서 KL을 빼면 가도 나도 0.802로 똑같네요. 그러면 KL은 어느 방향으로 재도 크로스 엔트로피랑 순위가 같겠네요.
선생님
KL(q‖p)도 재 봐요.
김민준
…가가 0.074, 나가 0.117이요. KL(q‖p)로 재면 가가 더 가까워요. 순위가 뒤집혔어요.
선생님
두 모델에서 똑같이 나온 0.802는 무엇이었어요?
이서연
모델 q를 바꿔도 안 변했으니까 p만으로 정해지는 값이겠죠. 크로스 엔트로피 식에서 q 자리에 p를 넣으면… −Σ pi log pi, 정답 비율 p의 엔트로피예요.
선생님
그러면 크로스 엔트로피와 KL(p‖q)는 어떤 관계예요?
김민준
빼서 0.802가 남았으니까, 크로스 엔트로피 = KL(p‖q) + 0.802네요.
이서연
더하는 값이 모델과 상관없으니까, 크로스 엔트로피를 줄이는 일은 KL(p‖q)를 줄이는 일과 순위까지 똑같아요. KL(q‖p) 쪽으로는 그런 식이 없으니 그 KL의 순위는 따로 놀고요.
선생님
그러면 크로스 엔트로피로 학습할 때 크게 벌을 받는 건 어떤 모델이에요?
김민준
가는 여우에 0.01밖에 안 줬어요. 현실에서는 열 장에 한 장이 여우인데 백 장에 한 장이라고 우긴 거예요. KL(p‖q)는 현실 p의 무게로 평균하니까 그 착오를 크게 벌해요. 가의 눈으로 보면 여우는 거의 안 보이니까 KL(q‖p)에서는 그 착오가 가볍게 눌렸던 거고요.
선생님
그래요. 크로스 엔트로피 손실을 고르는 순간, 데이터 분포 p를 ‖ 왼쪽에, 모델 q를 오른쪽에 둔 KL(p‖q)라는 방향이 정해져요. 손실을 고를 때 KL의 방향도 이미 고른 거예요.
이서연
문제 3에서 A를 모델 q 자리에 두니까 가장 가까운 점이 C에서 B로 바뀌었는데, 그 뒤집힘이 모델 고르기에서도 일어난 거네요.
김민준
조교님 채점표로 매기면 모두가 푼 흔한 문제의 비중이 커서 그런 문제를 크게 틀린 사람이 손해고, 제가 만든 채점표로 매기면 제가 자신 있는 문제만 크게 쳐 주는 거랑 같네요.
풀어 본 뒤에는 이 절의 유클리드–KL 비교 위젯(세 점 A, B, C를 심플렉스에 놓은 그림)에서 「문제 5 불러오기」 단추를 눌러 확인한다. 정답 비율 p, 모델 가, 모델 나가 각각 A, B, C로 들어간다.