유클리드 거리로 부족하다면, 분포와 분포 사이의 거리를 재는 방법은 어디서 구해야 할까? 뜻밖에도 그 방법은 기계학습보다 훨씬 먼저, 오래된 두 학문이 만나는 자리에서 한 번 나온 적이 있다.
이 책의 제목에 붙은 두 단어, 기하학과 정보는 둘 다 오래된 단어다.
기하학: 변하지 않는 것을 찾는 학문
기하학은 수천 년 동안 땅과 도형의 학문이었고, 유클리드는 점, 선, 각에 대한 몇 개의 공리에서 출발해 도형의 성질을 쌓아 올렸다.
19세기에 이 오래된 학문이 스스로를 다시 정의한다. 1872년, 펠릭스 클라인은 에를랑겐 대학에 부임하며 기하학을 이렇게 정리했다. 어떤 변환들을 허락할지 정하고, 그 변환 아래에서 변하지 않는 성질을 연구하는 것이 기하학이다. 밀어 옮기기와 회전을 허락하면 길이와 각이 남고, 길이와 각을 연구하는 기하학이 유클리드 기하학이다. 더 많은 변환을 허락하면 남는 것이 줄고, 다른 기하학이 된다.
"무엇이 변하지 않는가"라는 질문은 이 책에서도 계속 돌아온다. 분포의 이름표(좌표)를 바꿔도 변하지 않는 거리는 무엇인가. 놀랍게도, 그런 거리는 사실상 하나뿐이라는 정리가 있다.
정보: 일상어에서 숫자로
"정보"는 오랫동안 일상어였는데, 1948년 벨 연구소의 클로드 섀넌이 이 단어에 정확한 숫자를 매겼다. 드문 일이 일어나면 많이 놀라고, 흔한 일이 일어나면 적게 놀란다. 그 놀라움의 평균이 엔트로피이고, 엔트로피는 메시지를 아무리 영리하게 0과 1의 코드로 줄여 적어도 넘을 수 없는 평균 길이의 한계다. 놀라움, 엔트로피, 코드의 길이가 하나로 이어졌다.
교차점
두 학문이 만나는 자리에 먼저 서 있던 사람은 통계학자였는데, 그들이 부딪힌 물음은 이렇다. 앞면이 나올 확률을 모르는 동전을 100번 던져 앞면이 30번 나왔다면 앞면 확률을 0.30으로 추정한다. 그런데 같은 동전으로 실험을 다시 하면 38번, 또 하면 25번이 나온다(앞면 확률이 0.3인 동전을 컴퓨터로 흉내 낸 값이다). 추정값이 실험마다 흔들린다. 던지는 횟수는 그대로 두고 앞면 비율보다 영리한 추정 방법을 찾으면, 추정값의 분산을 얼마든지 줄일 수 있을까?
1945년, 인도의 젊은 통계학자 라오(C. R. Rao)는 아무리 영리하게 추정해도 추정값의 분산을 그 아래로는 줄일 수 없는 하한이 있다는 것을 부등식으로 썼다.
크라메르-라오 부등식이라 불리는 식이다. 관측 하나가 파라미터에 대해 알려 주는 양인 피셔 정보 I가 크면 분산의 하한 1/(nI)이 낮아서, 더 작은 오차로 맞힐 수 있다. I가 작으면 아무리 영리한 방법을 써도 추정값의 분산은 그 하한 아래로 내려가지 않는다.
라오는 여기서 멈추지 않았다. 같은 논문에서 그는 이 피셔 정보를 분포들의 공간의 계량(곳마다 아주 작게 움직인 거리를 재는 규칙)으로 읽고, 그 계량으로 두 분포 사이의 거리를 잴 수 있다고 제안했다. 통계학과 미분기하학이 악수한 순간이다.
라오의 이 제안이 정보기하학이라는 체계로 자라기까지는 수십 년이 더 걸렸고, 기계학습에 본격적으로 쓰이기 시작한 것은 모델이 거대해진 21세기의 일이다.
직접 움직여 보기
불러오는 중…
위성 항법: 위성이 한쪽 하늘에 몰리면 위치가 흐려진다
높은 건물 사이에서 지도 앱을 켜면 내 위치를 나타내는 점 둘레의 원이 커지고, 점이 길 건너편으로 튀기도 한다. 수신기가 재는 거리의 정밀도는 그대로인데도 이런 일이 생긴다. 왜 그런지 크라메르-라오 부등식으로 숫자를 따라가 보자.
위성 항법 수신기는 위성마다 신호가 도착하는 데 걸린 시간으로 위성까지의 거리를 재고, 그 거리들에 가장 잘 맞는 위치를 푼다. 실제 수신기는 높이와 수신기 시계의 오차까지 풀어서 위성이 넷 이상 필요하지만, 여기서는 평면 위의 위치만 푸는 장난감으로 줄이자. 아주 멀리 있는 송신기 셋까지의 거리를 재고, 측정마다 표준편차 5 m의 정규 오차가 따로 붙는다. 수신기를 동쪽으로 1 m 옮기면 어느 송신기까지의 거리는 그 송신기 방향이 동쪽과 이루는 각의 코사인만큼 변한다. 정동쪽 송신기라면 1 m, 정북쪽 송신기라면 0 m다. 그래서 거리 측정 하나가 동서 위치에 대해 주는 피셔 정보는 (코사인)²/5²이고, 측정이 셋이면 셋을 더한다. 거리 측정이 동서 움직임에 민감할수록 동서 위치를 좁게 잡을 수 있다.
송신기가 120° 간격으로 흩어져 있으면(북쪽, 남서쪽, 남동쪽) 코사인 제곱의 합이 0 + 0.75 + 0.75 = 1.5라서 동서 피셔 정보는 1.5/25 = 0.06이고, 하한이 정하는 표준편차는 1/√0.06 = 4.08 m다. 남북도 같은 값이 나온다. 송신기 셋이 모두 북쪽 하늘 ±10° 안에 몰리면 코사인 제곱의 합이 0.0603밖에 되지 않아 동서 표준편차가 20.4 m로 커진다. 남북은 사인 제곱의 합이 2.94라서 2.92 m로 오히려 좁다. 측정 오차는 똑같이 5 m인데 동서 표준편차만 4.08 m에서 20.4 m로 다섯 배가 된 것은, 세 송신기가 모두 북쪽에 있어서 수신기를 동쪽으로 1 m 옮겨도 세 거리가 0.17 m(cos 80°) 이하로밖에 변하지 않아 거리 측정이 동서 움직임을 거의 느끼지 못하기 때문이다. 두 배치 모두 남북 축을 사이에 두고 좌우가 같아서, 동서와 남북을 따로 셈해도 된다. 노이즈 섞인 거리로 위치를 2만 번 풀어 보면 표준편차가 4.12 m와 4.08 m, 20.45 m와 2.93 m로 하한에 거의 닿는다.
송신기 셋이 120° 간격으로 흩어진 경우(왼쪽)와 북쪽 하늘 ±10° 안에 몰린 경우(오른쪽). 거리 측정 오차는 둘 다 5 m인데, 노이즈 섞인 거리로 푼 위치(점)가 오른쪽에서는 동서로 길게 퍼진다. 청록 타원은 크라메르-라오 하한이 정한 1-표준편차로, 동서 4.1 m·남북 4.1 m와 동서 20.4 m·남북 2.9 m(sources/01-왜정보기하학인가/fig_gps_dop.py)
항법에서는 거리 오차가 위치 오차로 불어나는 배율을 정밀도 저하율(DOP, dilution of precision)이라 부르고, 위성이 하늘에 가까이 모여 있으면 DOP가 크다고 말한다. 이 개념은 지상 송신국의 전파로 배와 비행기의 위치를 찾던 항법 체계 로란-C를 쓰던 사람들에게서 나왔다. 장난감의 두 배치에서 동서·남북을 합친 수평 DOP는 1.15와 4.11이다. 위의 셈으로 보면, 위성이 몰린 배치에서 DOP가 커지는 것은 거리 측정이 동서 위치에 대해 가진 피셔 정보가 작아서 크라메르-라오 하한이 높아지는 일이다.
송신기 셋이 정확히 같은 방향에 서면 이 셈이 극단에 이른다. 코사인이 모두 0이라 동서 피셔 정보가 0이고, 하한 1/(nI)은 끝없이 커진다. 거리 측정 셋이 동서 위치에 대해 아무것도 말해 주지 않으니, 수신기가 어떤 영리한 계산을 해도 동서 위치를 정할 수 없다. 하한을 낮추려면 계산법을 바꿀 것이 아니라 동서 위치에 대한 정보가 있는 측정을 더해야 한다. 다른 방향의 하늘이 보이는 곳으로 나가면 된다.
파이썬
import numpy as np

rng = np.random.default_rng(0)
theta, n = 0.3, 100                        # 앞면 확률, 한 번에 던지는 횟수
I = 1 / (theta * (1 - theta))              # 동전 한 번의 피셔 정보

k = rng.binomial(n, theta, size=200_000)   # 실험 20만 번, 매번 n번 던져 앞면 수를 센다
est = k / n                                # 추정량: 앞면 비율

print(f"추정량의 분산      {est.var():.6f}")
print(f"하한 1/(n·I)       {1 / (n * I):.6f}")
for n2 in [25, 100, 400]:
    print(f"n={n2:<4} 하한의 제곱근(표준편차) {np.sqrt(1 / (n2 * I)):.4f}")
# 추정량의 분산      0.002094
# 하한 1/(n·I)       0.002100
# n=25   하한의 제곱근(표준편차) 0.0917
# n=100  하한의 제곱근(표준편차) 0.0458
# n=400  하한의 제곱근(표준편차) 0.0229
앞면 비율이라는 소박한 추정량의 분산 0.002094가 하한 0.002100과 거의 같다. 그리고 표준편차를 절반으로 줄이려면 동전을 네 배 던져야 한다.
이 책이 그리려는 지도
이 책은 학습, 추론, 생성의 뒤에서 작동하는 기하학적 구조를 그린다.
앞에서 본 마법들도 이 지도 위에 자리가 있다. 두 모델의 가운데를 취하는 일은 덧셈으로 잇는 경로와 곱셈으로 잇는 경로(m-측지선과 e-측지선), 그리고 분포를 모델 집합에서 가장 가까운 점으로 내리는 사영으로. LoRA가 좁은 방향으로 움직여도 되는 이유는 넓은 공간 속에 얇게 펼쳐진 곡면으로. 같은 크기의 파라미터 스텝이 곳에 따라 출력 분포를 다르게 바꾸는 이유는 피셔 정보로. 노이즈에서 그림을 꺼내는 생성 모델은 분포와 분포를 잇는 경로로.
이 절의 결론
기하학도 정보도 너무 기본적인 학문이어서 오히려 둘이 만난 것은 늦었지만, 그 만남이 지금의 AI를 설명하는 언어가 되고 있다.
그 언어의 첫 단어는 놀라울 정도로 단순하다. “확률분포 하나를 점이라고 부르자.” 이 한 문장에서 모든 것이 시작된다고 하는데, 정말 그럴까?
인물 이야기: 라오와 “스물다섯의 논문”
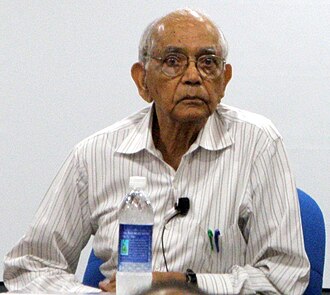
라오(C. R. Rao)
1945년, 인도 캘커타. 스물다섯 살 안팎의 칼리암푸디 라다크리슈나 라오(C. R. Rao)는 인도통계연구소(ISI)의 견습 연구원이었다. 2년 전 캘커타 대학에서 통계학 석사를 마쳤고, 연구소에서 연구를 하며 대학에서 시간강사로 가르치고 있었다. 박사학위는 아직 없었고, 몇 년 뒤 다른 대륙에서 받게 된다.
그가 그해 캘커타 수학회 회보에 실은 논문은 열 쪽 남짓이었다. 제목은 「통계 파라미터 추정에서 얻을 수 있는 정보와 정확도」. 겉보기에는 평범한 질문이었다. 추정량의 정밀도에 한계가 있는가?
피셔(Ronald Fisher)는 이미 1920년대에 그 한계(분산의 하한)가 있다는 것을 알고 있었다. 샘플이 아주 많을 때 최대우도추정(관측에 가장 높은 확률을 주는 파라미터를 고르는 방법)이 그 하한에 닿는다는 것을 보였다. 라오는 코시-슈바르츠 부등식 하나만 써서, 샘플 수와 상관없이 모든 불편추정량의 분산이 피셔 정보의 역수보다 작아질 수 없다는 것을 보였다.
같은 하한을 찾은 사람은 여럿이었다. 영국의 에이트컨(Alexander Aitken)과 실버스톤(Harold Silverstone)이 1942년에, 프레셰(Fréchet)가 1943년에, 다르무아(Darmois)가 1945년에 같은 부등식에 닿았고, 스웨덴의 크라메르(Cramér)는 1946년의 교과서에 그것을 실었다. 그래서 이 부등식은 크라메르-라오 부등식, 또는 프레셰-다르무아-크라메르-라오 부등식이라 불린다.
그러나 같은 논문의 뒷부분은 라오만의 것이었다. 그는 파라미터로 이름 붙은 분포들의 모임을 하나의 공간으로 보고, 피셔 정보 행렬을 그 공간의 리만 계량(곳마다 아주 작게 움직인 거리를 재는 규칙)으로 삼았다. 그리고 그 계량으로 잰 가장 곧은 길(측지선)의 길이를 두 분포 사이의 거리로 제안했다. 좌표를 어떻게 바꿔도 변하지 않는 이 거리를 오늘날 피셔–라오 거리라 부른다. 그 열 쪽 남짓한 논문에는 크라메르-라오 부등식과 피셔–라오 거리 말고도, 뒤에 라오-블랙웰 정리라 불릴 결과가 들어 있었다.
이듬해 여름, 라오는 영국으로 건너갔다. 케임브리지 킹스 칼리지에서 피셔의 지도를 받았고, 1948년에 박사학위를 받았다.
씨앗이 나무가 되기까지는 오래 걸렸다. 미분기하학의 방법이 통계학의 중심으로 들어온 것은 1975년 에프론의 통계적 곡률을 거쳐, 1980년대 아마리 슌이치의 작업에 와서였다.
위 줄은 분산의 하한에 닿은 사람들로, 피셔가 1920년대에 큰 샘플의 경우를 보인 뒤 1942년부터 1946년 사이에 다섯 번 같은 부등식이 나온다. 아래 줄은 리만 계량으로, 1915년 일반상대성이론에서 쓰이던 도구를 라오가 1945년 피셔 정보에 입혔고, 통계학의 중심에 들어온 것은 30년 뒤 에프론(1975)과 1980년대 아마리에 와서다. 연도는 각 논문의 서지에서 가져와 이 책에서 그렸다(sources/01-왜정보기하학인가/fig_rao_timeline.py)
2023년, 라오는 그 열 쪽짜리 논문으로 국제 통계학상을 받았고, 같은 해 여름 102세로 세상을 떠났다. 스물다섯 무렵에 심은 씨앗이 기계학습의 언어가 되는 것을 지켜본 드문 사람이다.
김민준
위 파이썬은 동전 실험 20만 번을 순식간에 돌려서, 앞면 비율의 분산이 하한에 붙는 걸 보여 줬잖아요. 라오도 그렇게 확인하면 됐을 텐데 왜 굳이 증명을 했어요?
선생님
1945년에 같은 실험을 하려면 동전을 모두 2천만 번 던지고 세야 했어요. 그런데 그걸 다 해냈더라도 라오의 물음에는 답이 안 됐을 거예요. 그 실험이 확인하는 건 무엇이죠?
이서연
앞면 비율이라는 추정량 하나가 하한에 붙는다는 거요. 라오는 하한 아래로 가는 불편추정량이 하나도 없다고 했으니까… 추정량은 끝없이 지어낼 수 있어서, 하나씩 시험해서는 끝이 안 나네요.
선생님
그래서 피셔도 1920년대에는 샘플이 아주 많을 때 최대우도추정이 하한에 닿는다는 데까지만 보였어요. 샘플이 100개뿐일 때 더 영리한 방법이 없다는 건, 라오가 코시-슈바르츠 부등식으로 모든 불편추정량을 한꺼번에 묶고 나서야 말할 수 있었어요.
이서연
같은 논문 뒷부분에서는 피셔 정보를 계량으로 읽었다고 했죠. 계량이면 미분기하학인데, 그때 통계학자들도 그 말을 썼어요?
선생님
그 무렵 리만 계량은 아인슈타인의 일반상대성이론이 휜 시공간을 적는 데 쓰던 도구였어요. 그 생각이 통계학의 중심에 들어온 건 30년이 지나 에프론의 통계적 곡률, 그리고 1980년대 아마리의 작업에 와서였고요.
이서연
피셔 정보가 곳마다 다르다면, 앞면 확률 0.5인 동전과 0.1인 동전 가운데 한 번 던질 때 앞면 확률을 더 많이 알려 주는 동전은 어느 것일까요?
문제 6. 여론조사의 ±3.1%포인트
여론조사 기사에는 “1,000명 조사, 95% 신뢰수준에서 표본오차 ±3.1%포인트” 같은 줄이 붙는다. 이 ± 값은 지지율 추정값의 표준편차에 1.96을 곱한 값이다. 지지율이 θ인 사람들 가운데 무작위로 n명에게 물어, "지지한다"고 답한 비율로 θ를 추정한다. (가) θ = 0.5, n = 1,000일 때 표준편차와 ± 값을 구하라. (나) 기사는 조사 하나에 ± 값을 하나만 적는데, 같은 조사에서 지지율이 10% 안팎인 후보의 실제 ± 값은 얼마인가? (다) 기사는 왜 한 숫자만 적을까?
응답자 1,000명을 점으로 찍고, 지지율 50% 안팎인 후보와 10% 안팎인 후보를 지지한 사람을 칠한 그림
아, θ(1−θ)… 0.1이면 0.09라서 √(0.09/1000) ≈ 0.0095, 1.96을 곱하면 ±1.9%포인트요. 기사 숫자보다 꽤 작아요.
이서연
θ(1−θ)는 θ = 0.5에서 가장 커. 그러니까 (다)는, 어느 후보에게 대도 모자라지 않게 가장 큰 경우의 값을 적는 거네.
선생님
크라메르-라오 하한과 비교하면요?
이서연
동전 한 번의 피셔 정보가 I = 1/(θ(1−θ))니까, 지지율이 한쪽으로 치우친 후보일수록 한 사람의 대답이 주는 정보가 커요. 추정값의 표준편차가 작아지는 게 그 뜻이었네요.
김민준
조교님이 채점 오차를 제일 헷갈리는 답안 기준으로 한 번만 공지하는 거랑 같네요. 뻔한 답안은 실제로 그보다 덜 틀리고요.
풀어 본 뒤 위젯에서 확인 → 위 크라메르-라오 부등식 위젯의 「문제 6 값 (θ 0.5, n 1000)」 단추
문제 7. 하한보다 분산이 작은 추정량?
앞면 확률이 θ = 0.2인 동전을 n = 100번 던진다. 동전 한 번의 피셔 정보가 I(θ) = 1/(θ(1−θ))일 때, (가) 크라메르-라오 하한을 구하라. (나) 앞면 비율 k/n의 분산과 비교하라. (다) 라플라스 추정량 (k+1)/(n+2)의 분산을 구하고, 그 분산이 하한보다 작다면 부등식이 틀린 것인지 따져 보라.
앞면 확률 0.2인 동전을 100번 던질 때 앞면 수 k가 나오는 확률과, 그 k로 만드는 두 추정량
함께 풀기
이서연
(가)는 1/I니까 θ(1−θ) = 0.16이에요.
김민준
근데 시뮬레이션에서 k/n의 분산은 0.0016이 나와. 하한이 0.16이면 하한보다 백 배 작은 거잖아.
이서연
그럼 하한을 뚫었다는 건데… 그럴 리가 없는데.
선생님
서연 학생이 쓴 I는 동전 몇 번의 정보예요?
이서연
한 번이요. 백 번 던지면 정보가 백 배라서 1/(nI) = 0.0016이에요. 시뮬레이션 값과 같네요.
선생님
그래요. 관측이 서로 독립이면 정보는 더해져요. 그래서 표준편차는 √n에 반비례해서 줄어요.
김민준
위성 항법 장난감에서 송신기 셋의 정보를 더한 것도 같은 거네요. 그럼 흩어진 세 방향에 송신기를 넷씩 두면, 정보가 네 배라서 동서 표준편차가 4.08 m의 절반인 2.04 m가 되겠어요.
선생님
북쪽 하늘에 몰린 세 방향에 넷씩 두면요?
이서연
20.4 m가 절반인 10.2 m로 줄어요.
선생님
흩어진 송신기 셋의 4.08 m와 비교하면요?
이서연
아직 4.08 m보다 두 배 넘게 커요. 같은 방향에서 듣는 측정을 늘려도 줄긴 하지만, 그 방향에 정보가 적은 건 그대로네요.
불편추정량이요. 평균적으로 참값을 맞히는 것들만요. 라플라스는 편향을 조금 받아들인 대신 분산을 줄인 거니까 애초에 대상이 아니에요.
김민준
조별 과제 점수를 조 평균 쪽으로 조금씩 당겨서 매기는 조교 같네요. 점수 편차는 줄지만, 잘한 사람 점수는 조금 깎이고.
선생님
좋은 비유예요. 그리고 공짜는 아니에요. θ = 0.02처럼 끝에 가까운 동전이면 라플라스의 제곱오차는 0.000277로, 하한 0.000196보다 커져요. 라플라스 추정량이 추정값을 끌어당기는 0.5가 참값에서 멀수록 편향이 비싸져요.
풀어 본 뒤 위젯에서 확인 → 위 크라메르-라오 부등식 위젯의 「문제 7 값 (θ 0.2, n 100)」 단추
문제 8. 드문 실수를 재려면 몇 문항이 필요한가
언어 모델 두 개를 문항으로 시험한다. 모델 A는 정답률이 70% 안팎이고, 모델 B는 해로운 답을 내는 비율이 0.1% 안팎이다. 문항마다 결과가 서로 독립이라고 보고, 맞힌(또는 해로운 답을 낸) 문항의 비율로 그 확률 θ를 추정한다. (가) A의 정답률을 표준편차 0.01(1%포인트)로 재려면 문항이 몇 개 필요한가? (나) B의 비율을 비율 자체의 10%인 표준편차 0.0001로 재려면? (다) 문항 하나의 피셔 정보는 B 쪽이 A보다 200배 넘게 크다. 그런데 왜 문항은 훨씬 더 많이 필요한가?
정답률 70% 안팎인 모델 A의 문항 100개와, 해로운 답을 0.1% 안팎으로 내는 모델 B의 문항 1,000개