앞 글자 여럿 보기: 비슷한 낱말을 비슷하게 다루는 신경망
학습한 임베딩: 비슷한 토큰은 가까이
학습을 마친 모델이 바이그램보다 잘 맞힌다는 것은 숫자로 확인했다. 그런데 정말 서연의 생각대로 「 Lily」와 「 Mia」가 비슷한 벡터가 되었을까? 임베딩 표 안의 길이 64 벡터 4,096 개는 무엇을 배웠을까?
코사인 유사도로 이웃 찾기
두 벡터가 얼마나 같은 방향을 가리키는지는 코사인 유사도(두 벡터 사이 각의 코사인, 1 이면 같은 방향, 0 이면 직각)로 잰다. 토큰 몇 개를 골라 학습한 임베딩에서 코사인 유사도가 가장 큰 이웃 다섯을 찾았다(sources/mlp-lm/probe_mlp.out).
## 2. 학습한 임베딩(길이 64)에서 코사인 유사도가 가장 큰 이웃 다섯
  ␣Luna    -> ␣Mimi 0.79, ␣Kitty 0.77, ␣Doggy 0.76, ␣Max 0.75, ␣Fluffy 0.74
  ␣Lily    -> ␣Mia 0.95, ␣Lisa 0.92, ␣Sara 0.91, ␣Anna 0.88, ␣Lila 0.88
  ␣cat     -> ␣dog 0.73, ␣mouse 0.73, ␣kitten 0.70, ␣Fluffy 0.66, ␣Whiskers 0.65
  ␣happy   -> ␣glad 0.75, ␣lucky 0.70, ␣proud 0.63, ␣grateful 0.62, ␣relieved 0.62
  ␣ran     -> ␣skipped 0.77, ␣hopped 0.76, ␣crawled 0.71, ␣swam 0.70, ␣running 0.70
  ␣red     -> ␣blue 0.83, ␣purple 0.80, ␣orange 0.80, ␣yellow 0.79, ␣pink 0.75
  ␣three   -> ␣3 0.86, ␣four 0.74, ␣five 0.69, ␣two 0.65, ␣ten 0.61
  ␣mom     -> ␣parent 0.87, ␣mommy 0.86, ␣Mom 0.85, ␣mum 0.84, ␣mother 0.84
  (학습 전) ␣Luna -> ␣pretending 0.48, ␣tag 0.40, ␣climb 0.39, ␣slipped 0.37, ␣pigeon 0.35
「 Lily」의 가장 가까운 이웃은 서연이 말한 「 Mia」이고 유사도가 0.95 다. 색은 색끼리, 움직임은 움직임끼리, 「 three」 옆에는 숫자 「 3」과 「 four」가 있다. 모델에게 낱말의 뜻을 알려 준 적은 없다. 다음 토큰을 맞히려고 고친 결과, 같은 자리에 쓰이는 토큰들이 같은 방향의 벡터를 갖게 되었다. 학습 전의 「 Luna」 이웃(「 pretending」, 「 tag」)에는 아무 규칙이 없다.
벡터 64 개 축을 다 볼 수는 없으니, 이름·동물·색·수·마음 다섯 묶음에서 토큰 36 개를 골라 그 토큰들의 주성분(흩어진 정도가 가장 큰 두 방향) 위에 내려 보았다.
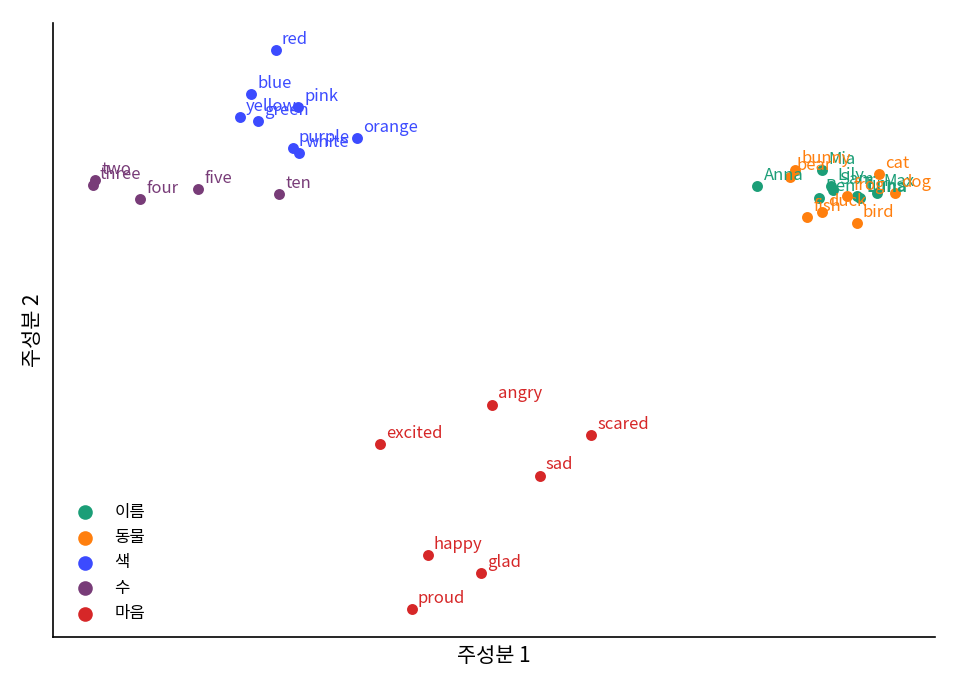
색과 수와 마음은 각각 모였는데, 이름과 동물은 한 덩어리로 섞였다. 타이니스토리즈에서는 동물도 아이 이름처럼 문장의 주어로 자주 나오고(「 the cat was happy」, 「 Lily was happy」), 「 named」 뒤에는 아이 이름도 고양이 이름도 온다. 다음 토큰을 맞히는 데에는 「이야기 속 인물」이라는 점이 사람과 동물의 차이보다 중요했다고 볼 수 있다.
잠깐, 루나 이웃이 왜 「 Kitty」, 「 Doggy」, 「 Fluffy」야? 루나가 애완동물이야?
동화에서는 루나가 고양이 이름으로 많이 나오나 보지.

루나는 관제 AI 라고.

동화 속 루나한테 그렇게 말해 봐.
학습 토큰 앞 1억 개에서 「 Luna」 바로 앞에 오는 토큰을 세 보면 「.」 1,351 번, 「 and」 1,183 번, 「 named」 1,016 번이다(sources/mlp-lm/problems.out). 고양이라고 따로 적혀 있지는 않고, 「 Mimi」와 「 Kitty」도 같은 토큰들 뒤에 온다. 모델이 본 것은 「 named 뒤에 오는 이름」이라는 자리였고, 「 named」 뒤에 함께 오는 이름 가운데 「 Luna」는 「 Mimi」, 「 Kitty」와 가장 가까웠다.
여러 토큰으로 잘린 낱말끼리 재기
내 이름도 해 줘. 「 Minjun」 이웃은 누구야?
네 이름은 표에 행이 없어. 우리 BPE 가 ␣M | in | j | un 네 토큰으로 잘랐잖아. 내 이름은 다섯 토큰이고.
임베딩 표에는 토큰마다 행이 하나씩 있을 뿐, 여러 토큰으로 잘린 낱말의 행은 없다. 「 Seoyeon」은 ␣S | e | oy | e | on 다섯 토큰, 「 Jisoo」는 세 토큰이고, 한국어 글로 학습한 BPE(어휘 4,096)에서도 「루나」는 루 | 나 두 토큰이다(sources/mlp-lm/multitoken_similarity.out 1절). 이런 낱말을 「 Tom」이나 「 Lily」와 비교하려면 먼저 낱말 하나에 벡터 하나를 만들어야 한다. 가장 먼저 떠오르는 방법은 조각들의 임베딩을 평균하는 것이다.
# sources/mlp-lm/multitoken_similarity.py 에서 발췌
E = mlp.emb.weight.float()
R = torch.stack([E[w].mean(0) for w in words])
words 에는 한 토큰짜리 온전한 낱말 2,789 개(공백 + 알파벳 두 글자 이상인 토큰)와 여러 토큰 낱말 여섯이 들어 있고, 한 토큰 낱말은 평균할 조각이 하나뿐이라 임베딩 표의 제 행이 곧 벡터다. 아래 「이름 8개」 칸은 한 토큰 이름 여덟(「 Tom」, 「 Lily」, 「 Ben」, 「 Mia」, 「 Sam」, 「 Max」, 「 Anna」, 「 Tim」)과의 코사인 유사도 평균이고, 「다른 8개」 칸은 「 tree」, 「 red」, 「 ran」, 「 happy」, 「 ball」, 「 cake」, 「 very」, 「 the」와의 평균이다.
## 2. MLP 언어 모델의 임베딩(길이 64)에서 조각 행을 평균한 벡터
  낱말            이름 8개    다른 8개  가장 가까운 한 토큰 낱말 6
  ␣Minjun        0.06    -0.14  ␣St 0.55, ␣Tr 0.48, ␣mel 0.45, ␣ind 0.45, ␣aw 0.44, ␣gor 0.44
  ␣Seoyeon      -0.04    -0.02  ␣se 0.48, ␣smo 0.46, ␣fool 0.43, ␣side 0.42, ␣pump 0.42, ␣delic 0.41
  ␣spaceship     0.14     0.07  ␣space 0.55, ␣butter 0.49, ␣lights 0.48, ␣sauce 0.47, ␣boots 0.47, ␣chocolate 0.47
  ␣pancake       0.06     0.03  ␣pan 0.79, ␣knife 0.55, ␣nail 0.52, ␣fork 0.49, ␣towel 0.48, ␣bill 0.47
  어휘 4,095 개 전체(조각 포함)에서 찾으면:
    ' Minjun'   -> ␣M 0.77, j 0.69, un 0.59, ␣R 0.57, ␣St 0.55, ␣K 0.52
    ' Seoyeon'  -> e 0.69, ␣S 0.55, on 0.55, ␣M 0.49, ␣se 0.48, ␣smo 0.46
「 Minjun」의 평균 벡터 옆에는 이름이 하나도 없고 「␣St」, 「␣Tr」 같은 낱말 앞조각이 있다. 조각까지 후보에 넣으면 1~3위가 자기 조각 「␣M」 0.77, 「j」 0.69, 「un」 0.59 다. 평균은 조각 벡터들의 한가운데라서 조각들에 가장 가깝게 남는다. 조각에 뜻이 있으면 그 뜻이 끌려와서, 「 pancake」는 프라이팬 「␣pan」(0.79) 옆으로, 「 spaceship」은 「␣space」 옆으로 간다. 「in」, 「j」처럼 뜻이 없는 조각이면 철자의 흔적만 남는다. 그리고 평균은 순서를 모른다. 「 Minjun」의 조각을 거꾸로 un | j | in | ␣M 으로 놓아도 평균은 같아서 두 벡터의 코사인 유사도는 1.00 이다(같은 출력 5절).
다른 방법은 모델에게 낱말을 끝까지 읽힌 다음 모델 안의 벡터를 꺼내는 것이다. 마지막 조각을 읽는 자리에서 모델은 앞 조각들까지 함께 보고 계산하므로, 마지막 조각 위치의 벡터에는 조각들이 합쳐진 결과가 들어 있을 것이다. MLP 언어 모델에서는 은닉층의 벡터 h(길이 512)가 그 자리다. 다만 h 는 앞 여섯 토큰으로 만들어지니 낱말 앞에 어떤 글이 있느냐에 따라 달라진다. 그래서 문장 틀 여섯 개(「One day, ___」, 「She smiled at ___」 등) 끝에 낱말을 붙여 h 를 하나씩 꺼내고 여섯 개를 평균했다. 한 토큰 낱말 2,789 개도 같은 틀에서 같은 방법으로 벡터를 만든다.
# sources/mlp-lm/multitoken_similarity.py 에서 발췌
def mlp_states(seqs):
    k = mlp.cfg.context
    win = torch.tensor([([mlp.cfg.pad_id] * k + s)[-k:] for s in seqs], device=dev)
    h = torch.tanh(mlp.hidden(mlp.emb(win).view(len(seqs), -1)))
    return h.unsqueeze(1)  # (N, 1, 512): 마지막 조각 위치만
## 3. MLP 언어 모델의 은닉 벡터 h(길이 512), 낱말 마지막 조각 위치, 문장 틀 6개 평균
  낱말            이름 8개    다른 8개  가장 가까운 한 토큰 낱말 6
  ␣Minjun        0.21     0.03  ␣knight 0.37, ␣hero 0.36, ␣neighbor 0.35, ␣cop 0.35, ␣cheer 0.35, ␣witch 0.35
  ␣Seoyeon       0.28     0.16  ␣wheels 0.47, ␣car 0.46, ␣sword 0.45, ␣hat 0.45, ␣thread 0.44, ␣truck 0.44
  ␣Kevin         0.30     0.11  ␣guard 0.44, ␣bull 0.43, ␣fairy 0.42, ␣spirit 0.42, ␣neighbor 0.41, ␣pony 0.41
  ␣pancake       0.38     0.22  ␣vase 0.57, ␣towel 0.56, ␣chair 0.55, ␣blanket 0.55, ␣mattress 0.55, ␣mask 0.54
이름 8개와의 평균이 다른 8개와의 평균보다 모두 높아졌고, 「 Minjun」의 이웃은 「␣knight」, 「␣hero」, 「␣neighbor」, 「␣cop」처럼 이야기 속 인물이 되었다. 그래도 「 Seoyeon」은 「␣wheels」, 「␣car」 옆이고, 이름과의 평균은 「 pancake」(0.38)가 「 Minjun」(0.21)보다 높다. 이 모델의 h 는 앞 여섯 토큰만 보고 다음 토큰 하나를 맞히려고 만든 벡터이고, 임베딩은 길이 64 뿐이다. 낱말 하나를 담기에는 작은 모델이다.
같은 방법을 이 책이 뒤에서 학습할, 동화를 쓰는 8층 GPT 에 써 보았다. 이 모델은 층마다 토큰 자리마다 길이 512 의 벡터를 만든다. 마지막 층(8층)이 낱말의 마지막 조각 자리에서 낸 벡터를 같은 틀 여섯 개로 평균했다.
[GPT 층 8 출력, 마지막 조각 위치]
  낱말            이름 8개    다른 8개  가장 가까운 한 토큰 낱말 6
  ␣Minjun        0.31     0.20  ␣cob 0.48, ␣compass 0.46, ␣Cat 0.46, ␣hedge 0.45, ␣Bird 0.45, ␣fox 0.45
  ␣Seoyeon       0.73     0.38  ␣John 0.80, ␣Joe 0.80, ␣Jimmy 0.80, ␣Jake 0.79, ␣Jack 0.78, ␣Peter 0.78
  ␣Jisoo         0.74     0.39  ␣Bella 0.80, ␣Benny 0.80, ␣Chirpy 0.79, ␣Ella 0.79, ␣Billy 0.79, ␣Joe 0.79
  ␣Kevin         0.80     0.40  ␣Benny 0.86, ␣Joe 0.84, ␣Jack 0.83, ␣Remy 0.83, ␣John 0.83, ␣Billy 0.83
  ␣spaceship     0.58     0.38  ␣rocket 0.83, ␣aeroplane 0.78, ␣plane 0.78, ␣helicopter 0.77, ␣machine 0.74, ␣ship 0.73
다섯 토큰을 다 읽은 GPT 는 「 Seoyeon」을 「 John」, 「 Joe」, 「 Jimmy」 옆에 둔다. 조각 평균에서 「␣space」 옆이던 「 spaceship」은 「 rocket」 옆으로 갔다. 조각 하나하나의 뜻이 아니라 조각들이 이룬 낱말의 뜻 쪽으로 옮겨 간 것이다. 순서도 구별한다. 거꾸로 놓은 「 Minjun」 조각과의 코사인 유사도가 GPT 8층에서 0.24, MLP 의 h 에서 0.36 이다(5절). 그런데 「 Minjun」만은 GPT 에서도 이웃이 「␣cob」, 「␣compass」다.

내 이웃은 왜 다 남자 이름이야.
그래도 이름이잖아. 나는 옥수수 속대야.
어느 층의 벡터를 쓰느냐도 결과를 바꾼다. 가운데 층(4층)의 마지막 조각 자리에서는 이름 8개와 다른 8개의 차이가 「 Seoyeon」 0.71 대 0.61 로, 8층의 0.73 대 0.38 보다 작다.
문맥은 얼마나 영향을 줄까? 틀 하나씩 따로 보면 「 Seoyeon」의 이웃 1위는 「␣Jimmy」, 「␣John」, 「␣Joe」 사이에서 바뀌고 유사도는 0.74 에서 0.85 사이다(6절). 이번 틀들에서는 이웃이 크게 바뀌지 않았지만, 모델 안의 벡터에는 늘 앞 글이 섞여 있으므로 틀 여러 개를 평균해 한 틀에서 생긴 우연을 줄였다.
숫자를 읽을 때 조심할 것이 둘 있다. 「이름 8개」와 「다른 8개」는 같은 틀에서 꺼낸 벡터끼리 잰 값이라 틀에서 온 공통 성분 때문에 함께 올라간다(GPT 8층에서는 「다른 8개」도 0.38 안팎이다). 그래서 숫자 하나보다 두 칸의 차이와 이웃 목록을 함께 본다. 그리고 낱말 여섯, 틀 여섯, 작은 모델 둘로 잰 결과라 낱말이나 틀을 바꾸면 순위가 바뀔 수 있다.
ML에서: 낱말 벡터
다음 낱말을 맞히다 보면 비슷한 낱말이 비슷한 벡터가 된다는 관찰은 벤지오 팀의 논문에 이미 있었고, 2013년 미콜로프(Tomas Mikolov) 팀의 word2vec 이 이를 크게 퍼뜨렸다. word2vec 은 언어 모델 전체 대신 주변 낱말 맞히기만 하는 가벼운 모델로 큰 글에서 낱말 벡터를 학습했다. 지금의 큰 언어 모델에서도 임베딩 표는 학습으로 고쳐지는 첫 층이고, 그 위의 층들이 문맥에 따라 벡터를 계속 고쳐 쓴다.
여러 토큰 낱말이나 문장 전체에 벡터 하나를 주는 문장 임베딩 모델도 같은 물음을 같은 방법으로 푼다. 2019년 라이머스(Nils Reimers)와 구레비치(Iryna Gurevych)의 Sentence-BERT 는 언어 모델 BERT(데블린 팀, 2018) 마지막 층의 출력을 모든 토큰 자리에 걸쳐 평균해(평균 풀링) 문장 임베딩을 만들고, 이것을 기본 설정으로 삼았다. 같은 논문에서, 문장 비교용으로 더 학습하지 않은 BERT 의 출력을 그대로 평균한 벡터는 문장 유사도 평가에서 낱말 벡터 GloVe 를 평균한 것보다도 낮은 점수(상관 54.81)를 받았다. 평균하는 방법만으로는 모자라고, 비교에 쓸 벡터가 그 용도로 학습되어 있어야 한다는 결과다. 모델 안에서 층마다 토큰 자리마다 만들어지는 벡터에 무엇이 적혀 있는지는 이 책의 뒤쪽에서 본격적으로 들여다본다.
문제 7. 드문 이름의 이웃
학습 토큰 앞 1억 개에서 「 Lily」는 361,493 번, 「 Luna」는 6,300 번 나온다. 「 Lily」의 가장 가까운 이웃 「 Mia」는 코사인 유사도가 0.95 인데, 「 Luna」의 가장 가까운 이웃 「 Mimi」는 0.79 다. 왜 「 Luna」는 이웃과 덜 가까울까? 그리고 학습을 더 오래 하면 0.79 는 어떻게 바뀔까?
「 Lily」가 「 Luna」보다 57 배쯤 많이 나와요. 많이 나올수록 벡터를 고칠 기회가 많고요.

고칠 기회가 적으면 「 Luna」의 벡터는 어떤 상태로 남을까요?
학습 전의 무작위 벡터가 덜 지워진 채로 남겠네요. 「 Luna」의 학습 전 이웃이 「 pretending」, 「 tag」였는데, 그 무작위 방향이 조금 남아서 이름들의 방향과 덜 맞는 거고요.
그럼 학습을 더 오래 하면 0.79 가 올라가겠네요. 6,553만 토큰 본 거니까, 1억 개에서 6,300 번이면… 「 Luna」를 4,000 번쯤밖에 못 본 거예요.
그래요. 임베딩은 그 토큰이 나올 때만 고쳐지니까 드문 토큰일수록 덜 배워요. 어휘를 키울 때 드문 토큰이 늘어나는 게 손해인 이유가 여기서도 보여요.
루나가 4,096 안에 겨우 들어온 이름이라 벡터도 아직 덜 자랐구나.
문제 8. 루나는 고양이인가
「 Luna」의 이웃은 「 Mimi」, 「 Kitty」, 「 Doggy」, 「 Max」, 「 Fluffy」다. 「 Luna」 바로 앞 토큰은 「.」, 「 and」, 「 named」 순으로 많고, 「 Mimi」와 「 Kitty」 바로 앞도 같은 순서다. 「모델은 루나를 애완동물이라고 생각한다」고 말해도 되는가?
안 돼요. 이웃 다섯이 다 애완동물 이름처럼 들리긴 하는데.
왜 안 될까요? 이웃만 보면 그렇게 보이는데요.
바로 앞 토큰이 「 named」, 「 and」로 같다는 건, 그냥 이름 자리에 온다는 거예요. 고양이인지는 모르고요.
그래도 이름이 비슷한 건 바로 앞 토큰만이 아니라 앞 여섯 토큰 전체로 배웠잖아. 「 the cat named」 같은 문맥이 많았으면 고양이 이름들과 가까워질 수 있지.
둘 다 일리가 있어요. 그럼 어떻게 확인할 수 있을까요?
「 Luna」 앞 여섯 토큰에 「 cat」, 「 dog」, 「 girl」이 몇 번씩 나오는지 세 보면 되겠어요. 이웃 목록만 보고 「생각한다」고 하는 건 이름 붙이기가 너무 빠르고요.
세 보기 전까지 루나는 관제 AI 야.
문제 9. 민준은 아직 끝나지 않았다
동화를 쓰는 8층 GPT 의 8층 출력(마지막 조각 자리, 문장 틀 여섯 개 평균)에서 「 Seoyeon」, 「 Jisoo」, 「 Kevin」의 이웃은 이름인데 「 Minjun」의 이웃은 「␣cob」, 「␣compass」, 「␣Cat」이다. 「One day, Minjun」 다음에 올 토큰으로 GPT 가 꼽은 셋은 「e」 0.559, 「␣was」 0.145, 「h」 0.052 이고, 「One day, Seoyeon」 다음은 「␣was」 0.368, 「␣and」 0.170, 「␣wanted」 0.090 이다. 왜 「 Minjun」만 이름 옆에 오지 않을까? 조각 자리들의 벡터를 평균하면 나아질까?
한국 이름이라 모르는 거 아닐까요? 동화에 Minjun 이 나올 일은 없을 테니까요.
아니, Seoyeon 도 한국 이름인데 John 옆에 갔잖아. 그건 이유가 못 돼.
다음 토큰 확률을 보세요. GPT 는 「Minjun」 다음에 무엇이 올 거라고 보나요?
「e」가 0.559… 공백 없는 「e」면 낱말이 이어진다는 거네요. 「Minjune」처럼요.
그럼 「un」 자리의 벡터는 어떤 상태일까요?
낱말을 다 읽은 상태가 아니라 아직 읽는 중인 상태요. Seoyeon 다음에는 「␣was」를 꼽으니까, 거기서는 낱말이 끝났다고 본 거고요.
그럼 마지막 자리 하나만 보지 말고 조각 자리 넷을 평균하면 되겠다. 다 읽었든 아니든 네 조각이 다 들어가니까.
multitoken_similarity.out 4절에서 「조각 위치 평균」 표를 열어 볼까요?
이웃이 「␣Al」, 「␣Don」, 「␣Fo」, 「␣Ch」… 이름 앞조각 같은 것들이네요. 이름과의 평균은 0.17 이고, Seoyeon 도 0.73 에서 0.51 로 내려갔어요. 평균이 앞 조각 쪽으로 끌려가서 오히려 덜 이름 같아졌네.
그래요. 마지막 조각 자리의 벡터가 낱말을 대표하려면 모델이 낱말이 거기서 끝났다고 알아야 해요. 조각 자리를 평균하면 그 문제는 피하지만 덜 읽은 자리들의 벡터가 섞여요.
내 이름은 아직 쓰는 중인 걸로 보였구나. 조교가 보고서 제목 「Minjun」을 보고 「제목이 덜 끝났네」 하며 채점을 미룬 거예요. 제목이 마지막 조각 자리 벡터, 조교가 GPT 고요.