바이그램: 바로 앞 글자 하나만 보고 세기
언어 모델은 앞 글 전부를 보고 다음 글자의 분포를 내놓아야 하는데, 그 분포를 세어서 얻으려면 같은 앞 글이 학습 글에 여러 번 나와야 한다. 동화 앞부분 「Once upon a time」 뒤라면 몰라도, 이야기 한가운데의 앞 글 수백 글자가 글자 하나 다르지 않게 다시 나오는 일은 거의 없다. 앞 글 전부를 세는 일이 불가능하다면, 얼마만큼만 보고 세면 될까? 가장 적게 보는 경우부터 해 보자. 바로 앞 글자 하나만 보는 것이다.
바로 앞 글자만 본다는 것은 위치 t의 분포 p(xt ∣ x<t)를 p(xt ∣ xt−1)로 줄여 쓴다는 뜻이다. 앞 글자가 정해지면 세는 대상도 정해지므로, 학습 글에서 그 글자가 나온 자리를 모두 찾아 바로 뒤에 무엇이 왔는지 세면 된다.
문장 하나로 손으로 세기
표가 어떻게 생기는지 보려고, 손으로 셀 수 있을 만큼 짧은 문장 하나로 먼저 세어 본다. 루나가 처음 말할 법한 문장 「luna saw a star. luna said hi to the star.」를 골랐다. 글자가 42개이고 서로 다른 글자는 15개라, 행과 열이 15개씩인 표에 이웃한 두 글자 41쌍을 모두 적을 수 있다.
## 1. 장난감 문장: 'luna saw a star. luna said hi to the star.'
글자 42 개, 서로 다른 글자 15 개, 이웃 짝 41 개
가장 많은 짝: '␣s'x4, 'a␣'x3, 'lu'x2, 'un'x2, 'na'x2, 'sa'x2, 'st'x2, 'ta'x2

표: 행 = 지금 글자, 열 = 다음 글자, 칸 = 센 수 (0 은 .)
      ␣  .  a  d  e  h  i  l  n  o  r  s  t  u  w
  ␣   .  .  1  .  .  1  .  1  .  .  .  4  2  .  .
  .   1  .  .  .  .  .  .  .  .  .  .  .  .  .  .
  a   3  .  .  .  .  .  1  .  .  .  2  .  .  .  1
  d   1  .  .  .  .  .  .  .  .  .  .  .  .  .  .
  e   1  .  .  .  .  .  .  .  .  .  .  .  .  .  .
  h   .  .  .  .  1  .  1  .  .  .  .  .  .  .  .
  i   1  .  .  1  .  .  .  .  .  .  .  .  .  .  .
  l   .  .  .  .  .  .  .  .  .  .  .  .  .  2  .
  n   .  .  2  .  .  .  .  .  .  .  .  .  .  .  .
  o   1  .  .  .  .  .  .  .  .  .  .  .  .  .  .
  r   .  2  .  .  .  .  .  .  .  .  .  .  .  .  .
  s   .  .  2  .  .  .  .  .  .  .  .  .  2  .  .
  t   .  .  2  .  .  1  .  .  .  1  .  .  .  .  .
  u   .  .  .  .  .  .  .  .  2  .  .  .  .  .  .
  w   1  .  .  .  .  .  .  .  .  .  .  .  .  .  .
's' 다음: 'a' 2/4 = 0.50, 't' 2/4 = 0.50
공백은 ␣로 적었다. 「s」의 행을 보면 「sa」(saw, said)가 두 번, 「st」(star 두 번)가 두 번이라, 「s」 다음에 「a」가 올 확률은 2/4 = 0.50이다. 행마다 센 수를 그 행의 합으로 나누면 행마다 합이 1인 분포가 되고, 이 나눗셈은 회상한 사진첩 표에서 고양이 줄을 줄의 합으로 나눈 것과 같다. 줄을 고르는 일이 「앞 글자를 안다」에 해당한다.
이렇게 이웃한 두 글자를 세어 만든 표, 또는 그 표로 다음 글자를 정하는 모델을 바이그램 (두 글자 표 / bigram)이라 한다. 식으로 적으면 다음과 같다.
타이니스토리즈 100MB 로 세기
이번에는 타이니스토리즈 학습 파일 앞 1억 바이트로 글자 쌍을 센다. 이야기 사이의 구분 줄을 빈 줄로 바꿔 이으면 98,363,266 바이트이고, 이웃한 두 바이트를 정수 하나(앞 바이트 × 256 + 뒷 바이트)로 바꿔 세면 256 × 256 표가 한 번에 나온다.
# sources/next-token/bigram.py (2절과 3절에서)
corpus = np.frombuffer(data.byte_corpus("train", N_BYTES), dtype=np.uint8)
idx = corpus[:-1].astype(np.int64) * 256 + corpus[1:]
counts = np.bincount(idx, minlength=256 * 256).reshape(256, 256)
P = (counts + 0.0) / np.maximum(counts.sum(1, keepdims=True), 1)
## 2. 타이니스토리즈 학습 글 앞 100,000,000 바이트 -> 이야기를 빈 줄로 이은 98,363,266 바이트
나온 바이트 종류 149 개, 0 이 아닌 칸 2,195 / 65,536

## 3. 다음 글자 확률(위 5개)
'q' 다음 (27,342 번 나옴): 'u' 1.000
't' 다음 (6,237,071 번 나옴): 'h' 0.312, '␣' 0.238, 'o' 0.164, 'e' 0.064, 'i' 0.036
'h' 다음 (4,737,462 번 나옴): 'e' 0.600, 'a' 0.135, 'i' 0.094, '␣' 0.070, 'o' 0.051
'␣' 다음 (19,091,003 번 나옴): 't' 0.149, 'a' 0.112, 's' 0.076, 'w' 0.074, 'h' 0.065
'.' 다음 (1,979,779 번 나옴): '␣' 0.749, '\n' 0.201, '"' 0.049, '\xe2' 0.001, '.' 0.000
'L' 다음 (182,842 번 나옴): 'i' 0.667, 'u' 0.149, 'e' 0.122, 'o' 0.048, 'a' 0.013
'y' 다음 (2,287,685 번 나옴): '␣' 0.592, '.' 0.103, ',' 0.089, 'o' 0.077, 'e' 0.040
256가지 바이트 가운데 실제로 나온 것은 149가지이고, 칸 65,536개 가운데 한 번이라도 센 칸은 2,195개뿐이다. 행마다 확률을 보면 영어를 아는 사람이 짐작하는 일이 숫자로 나온다. 「q」는 27,342번 나왔는데 뒤에는 한 번도 빠짐없이 「u」가 왔고, 「t」 다음에는 「h」가 0.312로 가장 흔하다. 「L」 다음에 「i」가 0.667이나 되는 것은 동화마다 나오는 이름 Lily 때문으로 보이는데, 이름을 따로 세어 확인하지는 않았다. 「L」 다음 둘째인 「u」 0.149에는 Lucy 와 함께 Luna 도 들어 있을 것이다.
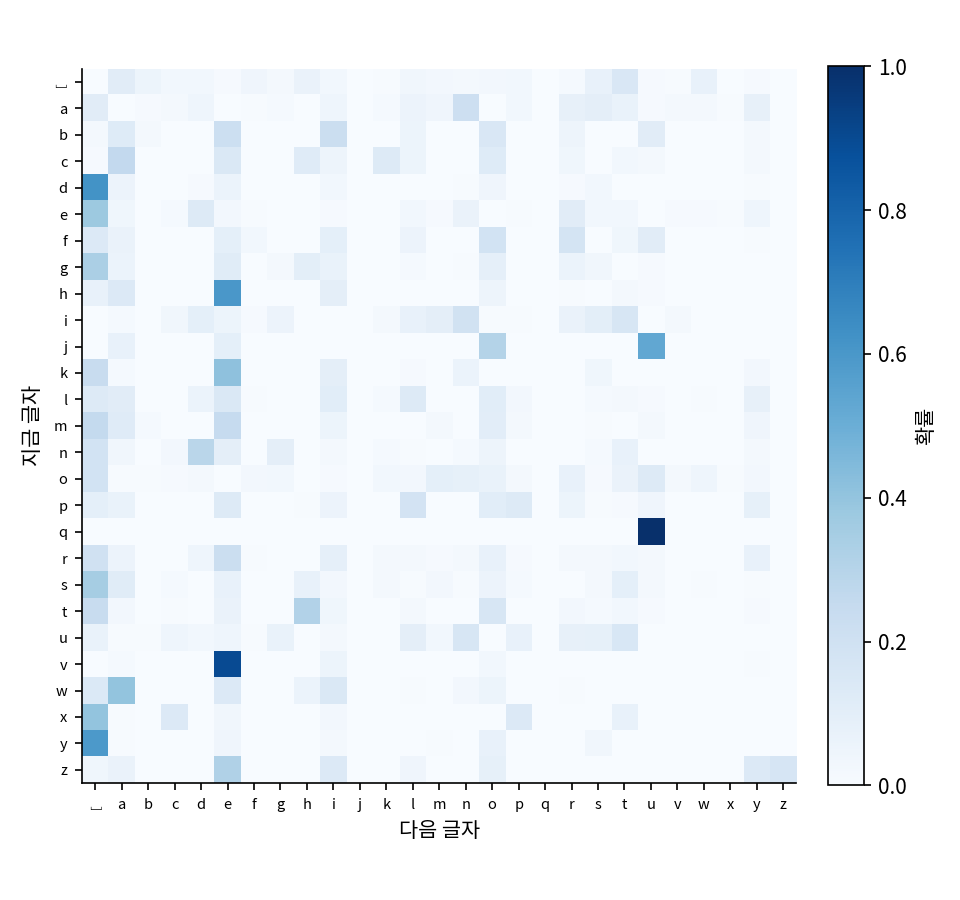
그림에서 가장 진한 칸은 q 행의 u 칸이고, v 다음의 e, h 다음의 e, j 다음의 u 가 그다음이다. 공백 열(맨 왼쪽)은 d, y, e, s 행에서 진한데, 영어 낱말이 자주 이 글자들로 끝나기 때문이다. 표 하나에 q 뒤의 u 같은 철자 규칙과 낱말이 끝나는 자리가 함께 담겨 있다.
ML에서: 센 수 65,536개짜리 모델
이 표는 학습으로 정한 수가 65,536개인 언어 모델이다. 경사 하강도 손실도 없이 세기만 했는데도, 위치마다 다음 글자의 분포를 내놓는다는 언어 모델의 약속을 그대로 지킨다. 다만 표가 보는 것은 바로 앞 글자 하나뿐이라, 「Once upon a ti」를 줘도 마지막 「i」만 보고 다음을 정한다. 앞을 더 길게 보는 모델과 이 표를 비교하려면 두 모델이 얼마나 잘 맞히는지를 숫자 하나로 잴 수 있어야 하고, 그 잣대는 루나가 실제 글에 얼마나 놀라는지를 재는 데서 나온다.
문제 3. 두 번 센 1과 2만 번 센 1
장난감 문장의 표에서 (가) 「a」 다음 글자의 확률을 모두 구하고, 그 합이 1인지 확인하라. (나) 장난감 표에서 「l」 다음에 「u」가 올 확률은 얼마인가? 타이니스토리즈 표에서 「q」 다음에 「u」가 올 확률 1.000과 비교하면, 두 값은 같은 만큼 믿을 만한가?

(가)는 「a」 행의 합이 3 + 1 + 2 + 1 = 7이니까, 공백이 3/7 = 0.43, 「r」이 2/7 = 0.29, 「i」와 「w」가 1/7 = 0.14씩이에요. 더하면 7/7 = 1이고요.

(나)는 「l」 행에 「u」 칸만 2라서 2/2 = 1이에요. 「q」 다음 「u」랑 똑같이 1이네요.
장난감 표로 글을 쓰면 「l」 뒤에는 늘 「u」가 오겠네요. 「little」이나 「lily」는 쓸 수 있을까요?
못 써요. 「li」가 한 번도 안 나왔으니까. 장난감 문장에 「l」이 「luna」에서 두 번 나온 게 전부라서요.
같은 1인데, 장난감 표의 1은 두 번 보고 낸 값이고 타이니스토리즈의 1은 27,342번 보고 낸 값이야. 장난감 표의 1은 「아직 다른 걸 못 봤다」는 뜻에 가깝고.

센 칸이 0인 것도 같은 문제예요. 0은 「일어날 수 없다」가 아니라 「이 글에서는 아직 못 봤다」일 수 있어요. 그 0이 실제로 어떤 말썽을 부리는지는 표로 처음 보는 글을 맞혀 볼 때 드러나요.
문제 4. 공백 뒤의 「the 」
타이니스토리즈 바이그램 표에서 P(‘t’ ∣ ‘␣’) = 0.1492, P(‘h’ ∣ ‘t’) = 0.3119, P(‘e’ ∣ ‘h’) = 0.5999, P(‘␣’ ∣ ‘e’) = 0.3785 이다. (가) 공백 바로 뒤에 「the」 세 글자가 이어질 확률을 이 표로 구하라. (나) 거기에 공백까지 이어져 「the 」가 될 확률은? (다) (나)의 확률이 실제 동화에서 공백 뒤 낱말이 「the」일 비율과 같다고 볼 수 있는가?
회상한 곱셈대로 하면 돼요. (가)는 0.1492 × 0.3119 × 0.5999 = 0.0279, (나)는 거기에 0.3785를 곱해서 0.0106이에요.
공백 뒤 낱말 100개 가운데 「the」가 하나 형태라는 건데, 동화에서 「the」가 그 정도로 드물까요?
생각보다 적은데요. 「the」는 제일 흔한 낱말일 텐데.
셋째 곱셈에서 「h」 다음 「e」를 0.5999로 썼는데, 그 「h」가 「the」의 「h」인지 「she」의 「h」인지 표는 모르잖아. 「h」 행은 「he」, 「she」, 「her」, 「have」의 「h」를 다 섞어서 센 거고.
그래요. 식은 회상한 곱셈 그대로인데, 곱하는 확률이 앞 글 전부가 아니라 바로 앞 글자 하나만 보고 낸 값이에요. 「th」까지 왔다는 사실을 표가 잊어버리니, 곱도 실제 비율과 어긋날 수 있어요.
그럼 앞 글자를 둘 보면 「th」 다음 「e」를 따로 셀 수 있겠네.
셋, 넷으로 늘리면 더 좋아지고? 표가 엄청 커지겠는데.