앞 글자를 더 보면: n-그램과 비어 가는 표
바이그램은 「th」까지 온 것을 잊고 「h」 행의 확률을 썼다. 앞 글자를 둘 보면 「th」 다음 「e」를 따로 셀 수 있고, 셋을 보면 「the」 다음을 셀 수 있다. 앞 글자를 늘릴수록 놀람이 계속 줄어드는지 묻자, 서연은 같은 물음에 사람으로 답을 구한 실험을 떠올렸다.

섀넌 맞히기 게임, 그거 재밌었는데. 그때 맞히는 역할 누가 했더라?
…몰라. 기억 안 나.
섀넌의 표는 띄어쓰기를 넣은 27글자로 셌고, 우리 표는 대문자와 문장 부호까지 든 바이트 149가지로 센다. 그래서 숫자를 그대로 겹칠 수는 없지만, 흐름은 같다. 섀넌의 띄어쓰기를 넣은 F₁(글자 비율만) 4.03비트와 F₂(앞 1글자) 3.32비트 자리에, 우리 유니그램 4.4150비트와 바이그램 3.2940비트가 놓인다. 섀넌은 표가 막힌 곳에서 사람에게 물었고, 우리는 1억 바이트의 글과 컴퓨터가 있으니 표를 더 늘려 볼 수 있다.
앞 글자를 여섯 개까지
앞 글자 n−1개를 보고 다음 글자를 맞히는 표를 n-그램 (앞 n−1글자를 보는 표 / n-gram)이라 한다. 유니그램이 n = 1, 바이그램이 n = 2다. 같은 학습 글 100MB 로 n = 7(앞 여섯 글자)까지 세고, α를 1과 0.01 두 가지로 두어 같은 검증 글로 쟀다.
## 2. 앞 글자를 더 많이 보면 (n-그램, 학습 글 100MB)
 n   앞 글자   α=1 bpb  α=0.01 bpb 문맥이 학습 글에 있던 비율
 1      0    4.4150      4.4150         1.0000
 2      1    3.2940      3.2938         1.0000
 3      2    2.3897      2.3866         1.0000
 4      3    1.8293      1.8085         0.9999
 5      4    1.5937      1.5187         0.9998
 6      5    1.5624      1.3628         0.9991
 7      6    1.6736      1.2817         0.9971
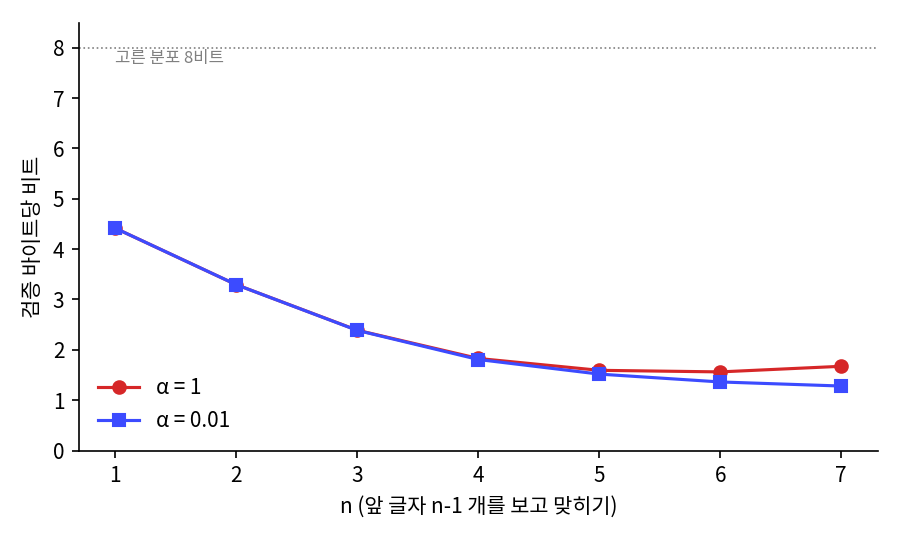
앞 글자를 둘 보면 2.39비트, 셋이면 1.81비트로 놀람이 크게 준다. 그런데 α = 1로 둔 표는 앞 다섯 글자(1.5624)에서 가장 좋고, 앞 여섯 글자에서는 1.6736으로 오히려 나빠진다. α = 0.01로 둔 표는 앞 여섯 글자까지 1.2817로 계속 좋아지니, 차이는 α에서 나온다. 앞을 더 볼수록 쓸 수 있는 정보는 늘기만 하는데, α = 1의 표는 왜 나빠질까? 오른쪽 칸을 보면 앞 여섯 글자 문맥도 99.71%가 학습 글에 있었으니, 처음 보는 문맥 탓만은 아니다.
세지 못한 문맥이 늘어난다
문맥을 「학습 글에 있었나」로만 보지 말고 「몇 번 있었나」로 세어 보면 나빠지는 이유가 보인다.
 n   앞 글자        나온 문맥 수           나올 수 있는 문맥 수 검증 자리의 문맥 횟수 중앙값 256번 미만 비율
 2      1            149                    149      4,737,462     0.0000
 3      2          2,195                 22,201        492,709     0.0003
 4      3         15,227              3,307,949        105,811     0.0028
 5      4         70,602            492,884,401         29,436     0.0146
 6      5        262,500         73,439,775,749         10,693     0.0569
 7      6        789,770     10,942,526,586,601          4,587     0.1320
앞 여섯 글자 문맥은 149가지 바이트로 10조 개 넘게 나올 수 있는데, 학습 글 1억 바이트에 나온 것은 789,770가지뿐이다. 검증 글의 맞힐 자리에서 문맥이 학습 글에 나온 횟수는 중앙값이 4,587번으로 아직 넉넉하지만, 256번보다 적게 나온 자리가 13.20%다. α = 1이면 행마다 칸 256개에 1씩, 모두 256을 더하므로, 256번보다 적게 센 행에서는 지어 넣은 수가 실제로 센 수보다 많아진다. 그런 행에서 표는 실제로 본 이어짐보다 보지 못한 이어짐 255가지에 확률을 더 많이 나눠 준다. 앞 글자를 늘리면 정보는 늘지만 행마다 센 수가 줄어서, 늘어난 정보보다 고르게 퍼진 확률이 더 크게 손해를 끼치는 지점이 온다.
표를 키우려면 학습 글도 함께 키워야 한다는 것은 학습 글의 크기를 바꿔 보면 더 뚜렷하다.
## 3. 학습 글 크기에 따라 (α=0.01, bpb)
 n       1MB      10MB     100MB
 2    3.2966    3.2942    3.2938
 4    1.8951    1.8195    1.8085
 6    1.9068    1.4652    1.3628
바이그램은 1MB 만으로 이미 3.2966이라, 학습 글을 백 배로 늘려도 거의 나아지지 않는다. 앞 다섯 글자를 보는 6-그램은 1MB 에서 1.9068로 4-그램(1.8951)보다 나쁘다가, 100MB 에서는 1.3628로 4-그램을 크게 앞선다. 긴 문맥은 학습 글이 그만큼 많을 때만 쓸모가 있다.
표가 하지 못하는 일
n-그램 표가 막히는 이유를 정리하면 둘이다. 첫째, 문맥의 가짓수가 앞 글자 수에 대해 거듭제곱으로 늘어서, 글을 아무리 모아도 긴 문맥의 행은 대부분 비거나 몇 번밖에 세지 못한다. 둘째, 표는 행끼리 아무것도 나눠 쓰지 않는다. 「Lily saw a 」 행을 수천 번 세었어도 「Lucy saw a 」 행은 따로 세어야 하고, 두 문맥 다음에 비슷한 글자가 온다는 사실을 표는 알 길이 없다.
두 어려움을 거꾸로 읽으면 다음에 할 일이 보이는데, 맞히는 단위를 글자보다 크게 잡으면 같은 앞 여섯 바이트를 더 적은 단위로 볼 수 있다. 그리고 문맥을 칸 번호 대신 숫자 벡터로 바꿔 비슷한 문맥이 비슷한 벡터가 되게 하면, 한 문맥에서 배운 것이 비슷한 문맥으로 번진다. 맞히는 단위를 키우는 일은 글을 토큰으로 자르는 일이고, 문맥을 벡터로 바꾸는 일은 신경망 언어 모델이 맡는다.
문제 6. 앞 여섯 글자를 다 보려면
문맥 표에서 앞 여섯 글자 문맥은 149⁶ = 10,942,526,586,601가지 나올 수 있다. (가) 모든 문맥을 학습 글에서 적어도 한 번씩 보려면 학습 글이 적어도 몇 바이트여야 하는가? (나) 문맥마다 256번씩 보아 α = 1이 손해를 끼치지 않게 하려면? (다) 실제로 필요한 학습 글이 (가)보다 훨씬 적을 수 있는 이유는 무엇인가?
일단 자리 하나에 문맥 하나씩이니까 (가)는 적어도 10조 9천억 바이트, 11TB 쯤이에요. (나)는 거기에 256을 곱해서 2,800조 바이트쯤.

타이니스토리즈 학습 파일 전체가 2.2GB 예요. (다)는요?
나올 수 있는 문맥이 다 실제로 나오지는 않잖아요. 「qqqqqq」나 「zxzxzx」 같은 건 동화에 안 나올 거고.
표에서도 1억 바이트에 나온 건 789,770가지뿐이었어. 나올 수 있는 것의 10조 분의 79만.
그럼 필요한 건 「나올 수 있는 문맥」이 아니라 「실제로 나오는 문맥」을 충분히 세는 거네. 그런데 문맥을 늘리면 실제로 나오는 것도 계속 늘어나니까, 언젠가는 또 모자라겠다.
그래요. 실제로 나온 문맥만 따져도 앞 글자를 다섯에서 여섯으로 늘리자 262,500가지에서 789,770가지로 세 배가 됐어요. 표가 커지는 속도를 글을 모으는 속도가 따라가지 못해요.
문제 7. 늘 더 긴 문맥이 낫나
학습 글이 1MB 뿐일 때 α = 0.01의 4-그램은 1.8951비트, 6-그램은 1.9068비트였다. 100MB 에서는 4-그램 1.8085, 6-그램 1.3628이었다. (가) 「앞을 더 보면 정보가 늘 늘어나니 n 이 클수록 좋다」는 말은 어디가 틀렸는가? (나) 큰 신경망 언어 모델을 학습시킬 때 같은 일이 일어날 만한 자리를 하나 들어라.

(가)는 정보가 늘어난다는 데까지는 맞아요. 앞 글을 더 알면 조건부 엔트로피는 줄면 줄었지 늘지 않으니까요.
그런데 1MB 에서는 6-그램이 4-그램보다 나빴어요. 조건부 엔트로피가 늘지 않는다는 건 무엇에 대한 말이었죠?
음… 진짜 확률을 알 때요. 우리 표는 진짜 확률이 아니라 1MB 에서 센 비율이고요. 6-그램 행은 1MB 에서 몇 번 못 세었을 테니, 그 비율이 진짜 확률과 많이 어긋나요.
100MB 가 되니까 6-그램 행도 충분히 세어져서 앞선 거고. 긴 문맥에서 얻는 정보랑, 행마다 센 수가 줄어서 생기는 차이가 서로 경쟁하는 거네요.
(나)는요?
모델은 큰데 데이터가 적을 때요. 파라미터가 많으면 긴 문맥을 다 쓸 수 있는데, 데이터가 모자라면 학습 글에만 맞는 모델이 될 테니까 검증 손실이 오히려 나빠질 것 같아요.
그래서 모델을 키울 때 데이터를 얼마나 함께 늘려야 하는지가 큰 물음이 돼요. 우리 루나도 언젠가 그 물음을 숫자로 마주하게 될 거예요.