휨을 흉내 내기: 곡률을 계산하지 않고 그 효과만
헤시안–벡터 곱으로 표는 피했지만, 뉴턴 스텝 하나를 얻으려면 그 곱을 스텝마다 수십 번에서 수백 번 써야 했다. 큰 언어 모델은 그래디언트 한 번을 구하는 데도 값이 많이 들어서, 학습 스텝 하나에 그 수십 배를 치르기 어렵다. 그런데 뉴턴 스텝이 길쭉한 골짜기에서 실제로 한 일을 돌아보면, 가파르게 휜 방향으로는 짧게, 완만한 방향으로는 길게, 방향마다 학습률을 따로 준 것이었다. 필요한 것이 지형의 지도 전체가 아니라 그 효과라면, 지도의 한 조각만 들고 다녀도 효과의 얼마쯤은 얻을 수 있지 않을까?
협곡 하나, 방법 넷
길쭉한 골짜기 가운데 가장 간단한 것, 조건수 100인 그릇 f(θ) = ½(θ₁² + 100θ₂²)으로 해 보자. 방향마다 휨이 1과 100으로 다르고, 헤시안은 대각선에 1과 100이 놓인 2 × 2 표다. 같은 그릇을 45° 돌려 놓으면 협곡이 대각선으로 눕고, 헤시안은 대각 칸이 둘 다 50.5, 엇갈린 칸이 −49.5인 표가 된다. 그릇의 모양은 같고 놓인 방향만 다르다. 두 그릇에서 (1, 1)(돌린 그릇에서는 이 점을 같이 돌린 자리)에서 출발해 바닥까지 거리 0.001 안에 들기까지의 스텝 수를 네 방법으로 셌다. 방법마다 지도 대신 무엇을 들고 다니는지를 함께 적었다.
| 방법 | 헤시안 대신 들고 다니는 것 | 나란한 그릇 | 45° 돌린 그릇 |
|---|---|---|---|
| 경사하강(가장 좋은 고정 학습률 2/(L + μ)) | 없음 | 363 | 363 |
| 지난 스텝 하나를 기억하기(무거운 공, 폴랴크의 학습률과 기억 세기) | 칸마다 지난 스텝 하나, n개 | 58 | 58 |
| 헤시안의 대각 칸만 쓰기(칸마다 그 칸의 휨으로 나눔) | 칸마다 휨 하나, n개 | 1 | 363 |
| 헤시안 전체(뉴턴 스텝) | 표 n²칸 | 1 | 1 |
뉴턴 스텝은 어느 쪽에서나 한 스텝이고, 경사하강은 어느 쪽에서나 363스텝이다. 눈여겨볼 것은 가운데 두 줄이다. 대각 칸만 쓰는 방법은 나란한 그릇에서 뉴턴 스텝과 똑같이 한 스텝에 끝나는데, 그 그릇에서는 대각 칸이 지도 전체이기 때문이다. 그런데 돌린 그릇에서는 대각 칸이 둘 다 50.5라 두 칸을 같은 수로 나누게 되고, 그러면 학습률 하나로 걷는 경사하강과 다를 것이 없어 363스텝으로 돌아간다. 지난 스텝 하나를 기억하는 방법은 두 그릇에서 똑같이 58스텝이다. 방향마다의 휨은 한 칸도 측정하지 않았는데 경사하강보다 여섯 배 넘게 빠르고, 그릇을 돌려도 흔들리지 않는다. 학습률과 기억의 세기는 경사하강의 학습률처럼 가장 큰 휨 L과 가장 작은 휨 μ 두 숫자로만 정했다(보리스 폴랴크가 1964년에 구한 값).
네 방법은 모두 「그래디언트에 무언가를 곱하거나 더해 방향마다 스텝을 늘이고 줄인다」는 점에서 같다. 그 가운데 행렬을 곱하는 형태를 식으로 적으면 다음과 같다.
이렇게 그래디언트에 행렬을 곱해 방향마다 스텝을 늘이고 줄인 뒤 걷는 일을 전조건 (방향마다 스텝을 따로 조정하기 / preconditioning)이라 하고, 곱하는 행렬 P를 전조건 행렬이라 한다. 뉴턴 스텝은 P로 헤시안의 역을 그대로 쓴 것이고, 이 책이 「휨을 흉내 낸다」고 부르는 방법들은 헤시안의 역 대신 값싸게 들고 다닐 수 있는 것을 P 위치에 넣는다. 지난 스텝을 기억하는 무거운 공은 행렬을 곱하는 대신 지난 스텝을 더하는 형태라 전조건 행렬을 곱하는 형태에 꼭 일치하지는 않지만, 노리는 효과는 같다.
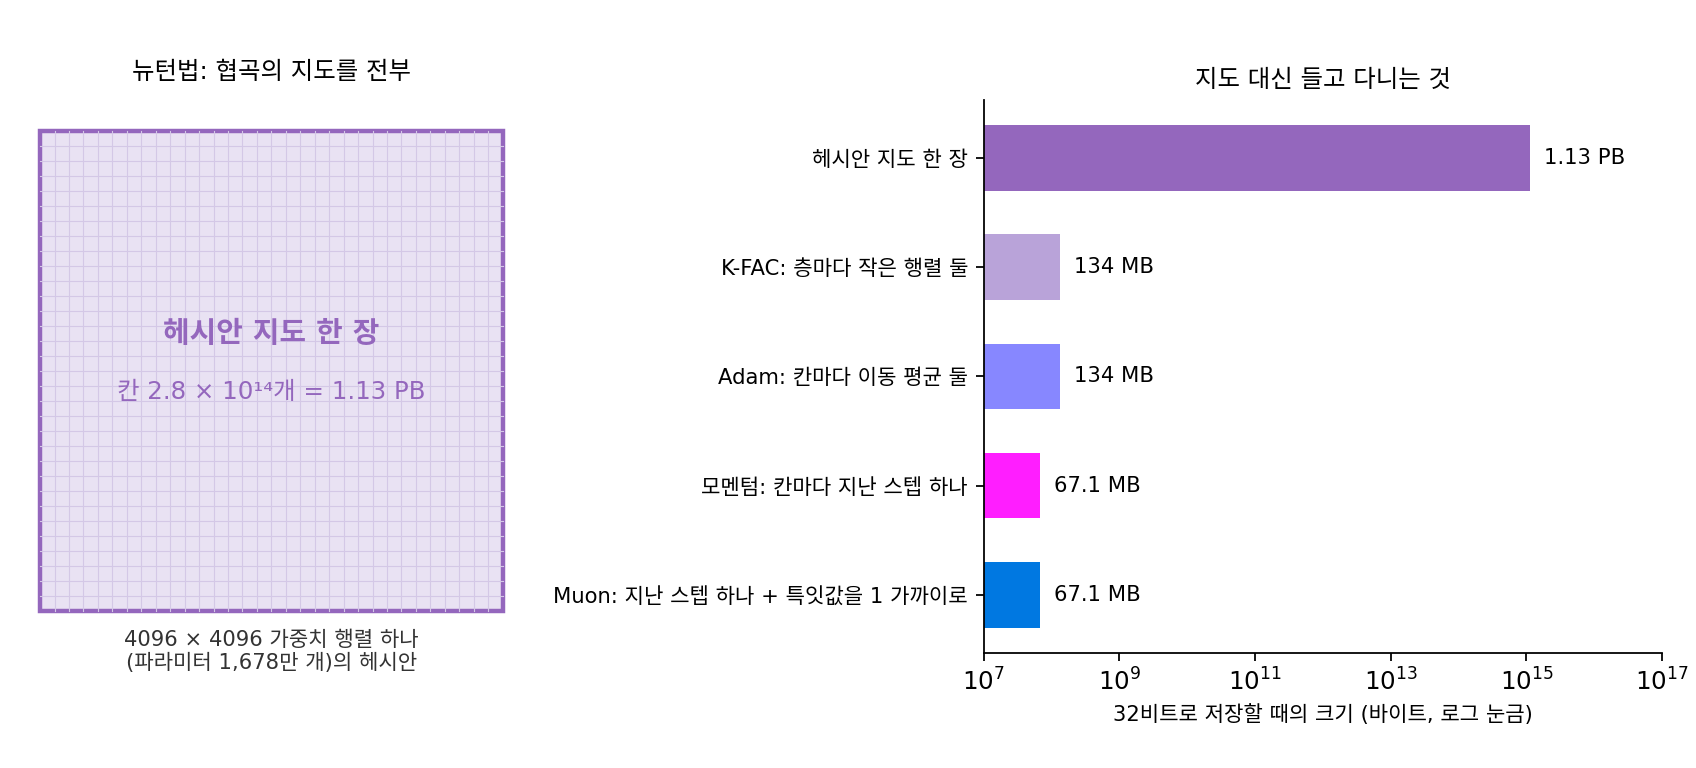
흉내마다 지도의 어느 조각을 들었는지가 다르다. 큰 신경망의 가중치 행렬 하나를 놓고 지도와 들고 다니는 것의 크기를 비교하면 다음 그림과 같다.
ML에서: 옵티마이저의 상태는 지도의 조각이다
파이토치의 옵티마이저는 파라미터와 따로 「상태(state)」를 들고 다닌다. torch.optim.SGD 에 momentum=0.9 를 주면 파라미터마다 지난 스텝을 기억하는 버퍼가 하나 생기고, torch.optim.Adam 은 파라미터마다 이동 평균을 두 개(exp_avg, exp_avg_sq) 들고 다닌다. 그래서 Adam 으로 학습하면 옵티마이저 상태만으로 파라미터의 두 배 메모리가 더 든다. 이 상태가 바로 흉내에 쓰는 지도의 조각이다. 모멘텀은 지난 스텝을, Adam 은 칸마다의 그래디언트 크기를, K-FAC 과 Shampoo 는 층마다 작은 행렬 몇 개를 들고 다니고, Muon 은 지난 스텝을 들고 다니다가 쓸 때마다 그 행렬의 특잇값을 모두 1 가까이로 모은다. 어떤 조각을 선택하느냐에 따라 메모리와 계산이 달라지고, 어떤 지형에서 잘 걷고 어떤 지형에서 헤매는지도 달라진다.
개념 다지기: 지도의 어느 조각을 버렸고, 그래서 언제 틀리나
뉴턴 스텝은 어느 그릇에서나 한 스텝이었잖아요. 58스텝이나 363스텝 걸리는 방법을 왜 굳이 써요?
4096 × 4096 행렬 하나의 헤시안이 얼마였죠?
1.13 PB요. 아, 층 하나에 그거면 모델 전체는 저장할 수가 없네요. 들고 다닐 수 있는 건 67 MB, 134 MB 쪽뿐이고요.
그러면 들고 다닐 수 있는 것 가운데 선택하는 거네. 대각 칸만 쓰는 게 제일 좋아 보이는데? 나란한 그릇에서는 뉴턴 스텝처럼 한 스텝이었잖아.
돌린 그릇에서는요?
363스텝이요. 경사하강이랑 똑같아요. 대각 칸이 50.5, 50.5로 같아져서 두 방향을 구별하지 못하니까요. 그럼 대각 칸만 쓰는 방법은 협곡이 축과 나란할 때만 통하는 거예요.
신경망의 협곡은 축과 나란할까요?
음, 가중치 하나하나가 따로 협곡을 이루지는 않을 것 같아요. 문제 2에서 대각 칸이 둘 다 3인데 가장 크게 휜 방향은 대각선이었고요. 파라미터들이 서로 결합되어 있으면 협곡은 비스듬히 누워 있겠네요.
그러면 지난 스텝 하나를 기억하는 쪽은 돌려도 58스텝이니까 이게 더 안전하지 않아요? 버린 게 없는 것 같은데요.
이 그릇은 어디서나 휨이 같은 2차 함수였어요. 무거운 공의 학습률과 기억의 세기는 무엇으로 정했죠?
가장 큰 휨과 가장 작은 휨, 두 숫자로요. 아, 그 두 숫자가 자리마다 바뀌는 지형이면 한 번 정한 기억의 세기가 맞지 않아서, 지난 스텝이 오히려 엉뚱한 쪽으로 밀 수도 있겠네요.
그러니까 흉내마다 버린 조각이 있고, 그 조각이 필요한 지형에서 틀리는 거구나. 대각 칸은 협곡의 방향을, 지난 스텝은 자리마다 바뀌는 휨을 버렸고요.
식이 ½(θ₁² + 100θ₂²)로 다 드러난 그릇을 떠올려 봐요. 최솟점도 방향마다의 휨도 식에 다 보이는데, 경사하강은 왜 수백 스텝을 돌았죠?
음… 학습률이 하나뿐이어서요. 가파른 방향에 맞춰 작게 잡은 학습률로 완만한 방향을 기어갔어요.
뉴턴 스텝은 그 하나 대신 방향마다 휨의 역수를 학습률로 줬고. 그래서 한 스텝에 원점에 닿았지.
아, / 255.0 으로 입력 크기를 맞추던 것도 결국 그릇을 둥글게 만들어 학습률 하나로 버티려던 거였네요. 뉴턴 스텝은 방향마다 휨의 역수를 학습률로 줘서 그게 필요 없었는데, 큰 신경망에서는 안장점에 끌리고 표가 너무 커서 그 지도를 다 들고 다닐 수가 없어요. 그래서 Adam 이 exp_avg_sq 같은 조각만 들고 다니면서 효과를 흉내 내는 거고요.
그래요. 앞으로 만날 방법마다 「지도의 어느 조각을 들었나, 무엇을 버렸나, 그래서 어떤 지형에서 틀리나」 세 가지를 물어보면 이름이 많아도 길을 잃지 않아요.