Dimuon: LoRA 에 맞춰 다시 짠 Muon
이 장의 물음
큰 언어 모델을 내 데이터에 맞게 고치는 파인튜닝은 요즘 대개 가중치 전체를 고치지 않는다. 층의 가중치 W 는 얼려 두고, 고칠 양 ΔW(델타 W)를 가는 행렬 두 개의 곱으로 묶어 학습하는 LoRA(저랭크 적응, low-rank adaptation)를 쓴다. 폭이 4096 인 층이라면 고칠 양이 4096×r 행렬과 r×4096 행렬의 곱이고, 랭크 r 은 8, 32, 128 처럼 작게 잡는다. 이렇게 학습하는 숫자가 크게 줄어도, 그 숫자를 움직이는 옵티마이저는 여전히 AdamW 가 기본값이었다.
2025년 가을 파인튜닝 서비스 「팅커(Tinker)」를 낸 미국의 연구 회사 싱킹 머신스 랩(Thinking Machines Lab)은 그 뒤 이 서비스에 「LoRA 파인튜닝을 위해 회사 안에서 만든 옵티마이저」 하나를 더했고, 이름을 Dimuon 이라 붙였다. 사용 문서가 밝힌 것은 많지 않다. 학습률을 AdamW 의 10~100배로 잡으라는 것, 지도 학습 파인튜닝에서는 몇몇 시험에서 AdamW 보다 같은 스텝에 손실이 더 낮았고 강화학습에서는 비슷했다는 것, LoRA 랭크를 바꿔도 좋은 학습률이 AdamW 보다 조금 덜 움직였다는 것이다. 업데이트 식은 공개하지 않았다.
이름에 Muon 이 들어 있으니 그래디언트 행렬을 직교화하는 옵티마이저일 것이다. 그런데 Muon 은 큰 은닉층 행렬에 쓰던 방법이고, LoRA 의 행렬은 한 변이 32 처럼 짧은 가는 행렬이다. 그리고 바깥에서 재어 보니, Dimuon 은 AdamW 가 파라미터마다 들고 다니는 이동 평균 두 개 가운데 하나만, 그것도 16비트로 들고 다녀서 옵티마이저 상태가 AdamW 의 4분의 1이었다. 2026년 10월 커뮤니티의 한 저장소(anpaure/dimuon)가 이 옵티마이저의 스텝을 바깥에서 재어 식을 거꾸로 알아낸 결과를 공개했다. 이 부록은 그 재현 결과를 따라가며 다음 물음에 답한다.
- 가는 LoRA 행렬에 Muon 을 쓰면 무엇이 달라지고, 무엇을 고쳐야 할까?
- Adam 이 칸마다 들고 다니던 그래디언트 제곱의 이동 평균을 버리면, 그 일은 누가 대신할까?
- 직교화에 쓰는 다항식을 반복마다 바꾸면 무엇을 얻을까?
- 입력 칸마다 크기가 크게 다른 활성값 앞에서, 직교화한 스텝이 큰 몇 칸에 몰리는 것을 어떻게 막을까?
- 학습률이 왜 AdamW 의 10~100배여야 하고, 랭크를 바꿔도 왜 덜 흔들릴까?
- 식을 공개하지 않은 옵티마이저의 식은 어떻게 알아낼 수 있을까?
LoRA 의 가는 두 행렬에 Muon 을 쓰면
Muon 은 은닉층의 2차원 가중치 행렬마다 모멘텀을 직교화해, 특잇값을 모두 1 근처로 바꾼 스텝을 썼다. 그래디언트가 몇 방향에만 크고 나머지 방향에서는 작을 때, 작은 방향도 같은 크기로 움직이게 하는 방법이었다. 그렇다면 LoRA 로 학습할 때 고칠 양 ΔW 를 하나의 행렬로 보고 직교화하면 될까? LoRA 는 ΔW 를 직접 들고 있지 않고, 들고 있는 것은 두 인자뿐이다.
고칠 양을 두 인자로 나누기
LoRA 는 얼린 가중치 W₀ 에 다음 양을 더한다. α(알파)는 배율 상수다.
배율 α 는 랭크를 바꿔도 고칠 양의 크기가 크게 변하지 않게 하는 상수다. 옵티마이저가 받는 것은 B 와 A 의 그래디언트이고, 두 그래디언트도 가는 행렬이다. 재현 결과에 따르면 Dimuon 은 두 인자를 따로따로 직교화한다. 원래 Muon 은 입력층과 출력층에는 AdamW 를 쓰고 은닉층에만 직교화를 썼는데, Dimuon 은 출력층을 포함해 LoRA 인자 모두에 같은 방법을 쓴다.
두 인자를 따로 직교화하면 계산은 아주 싸진다. 4096×4096 행렬에 뉴턴–슐츠 반복을 한 번 돌리는 곱셈은 2×10¹¹ 번쯤인데, 32×4096 인자는 8×10⁶ 번쯤이다. Muon 의 덤 계산은 한 스텝에 토큰을 적게 쓰는 파인튜닝에서 원래 계산보다 커질 수 있었지만, 가는 인자에서는 그 걱정이 거의 사라진다(sources/dimuon/s6_problems.out).
원래 Muon 과 무엇이 다른가
재현 저장소가 정리한 차이는 다음과 같은데, 여섯 줄 가운데 셋째부터 여섯째 줄을 이 부록이 차례로 다룬다.
| Muon | Dimuon (재현) | |
|---|---|---|
| 쓰는 곳 | 은닉층의 2차원 가중치, 나머지는 AdamW | LoRA 인자 모두(출력층 포함), A·B 따로 |
| 모멘텀 | 네스테로프, β = 0.95 | 보통 이동 평균, β = 0.9 |
| 들고 다니는 상태 | 모멘텀 하나 (32비트) | 모멘텀 하나 (bfloat16 으로 저장) |
| 직교화 | 같은 5차 다항식 다섯 번 | 반복마다 다른 Polar Express 다항식 다섯 개 |
| 행·열 조건화 | 없음 | 지난 모멘텀의 행·열 에너지로 −1/4 제곱 |
| 스텝 크기 | 행렬 모양으로 보정 | 프로베니우스 노름을 η·√r·(r/32)0.175 로 고정 |
표의 β(베타)는 이동 평균 계수이고 η(에타)는 학습률이며, 「재현」이라는 말을 붙인 것은 이 표가 회사의 발표가 아니기 때문이다. 재현한 사람이 서버의 실제 스텝과 자기 식의 스텝을 비교했더니 한 행렬의 스텝마다 상대 오차의 중앙값이 모델에 따라 0.35~0.9% 였고, 몇몇 전문가 혼합 모델에서는 큰 오차가 남았다. 비트 단위까지 같지는 않으며, 랭크 128 넘게나 20스텝 넘게는 시험하지 않았다고 스스로 적었다. 이 부록의 식은 모두 이 한계 안에서 읽어야 한다.
flowchart LR
  G["그래디언트 G"] --> MO["모멘텀 M ← βM + (1−β)G"]
  OLD["지난 모멘텀"] --> RC["행·열 조건화 R, C"]
  MO --> IN["R·M·C"]
  RC --> IN
  IN --> PE["Polar Express 다섯 번"]
  PE --> OUT["R·(…)·C"]
  RC --> OUT
  OUT --> NR["노름을 η·√r·(r/32)의 0.175 제곱으로"]
  NR --> W["W ← W − 스텝"]
ML에서: 장난감 LoRA 하나로 네 옵티마이저 비교
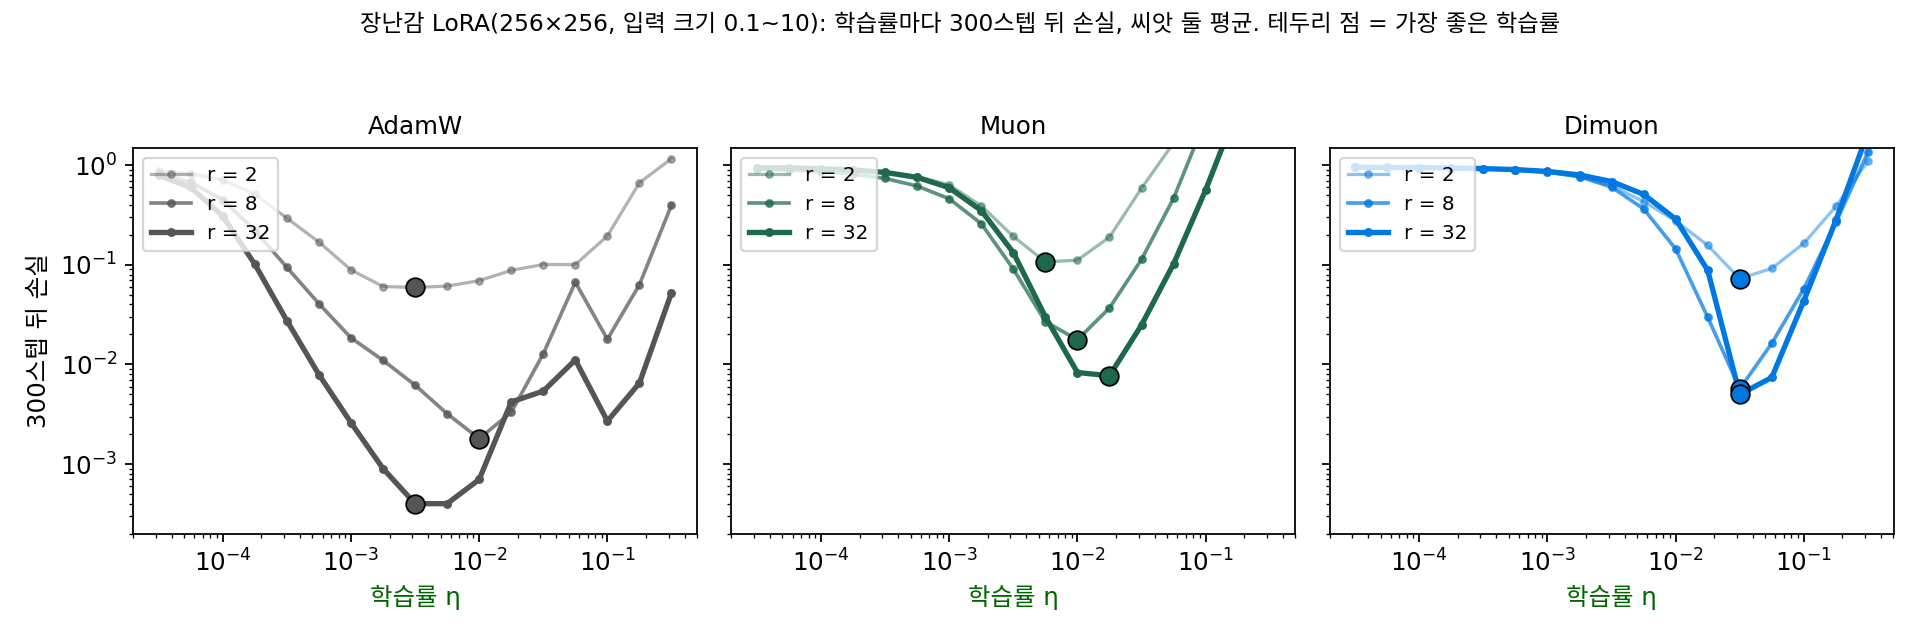
이 부록의 장난감은 폭 256 인 얼린 층 하나에 LoRA 를 단 회귀다. 맞출 정답은 랭크 8 인 행렬(특잇값 4, 2, 1, …, 0.03)이고, 입력의 칸마다 크기가 0.1 에서 10 까지 로그로 고르게 다르다. 큰 언어 모델의 활성값에서 몇몇 칸이 유난히 큰 것을 흉내 낸 것이다. 미니배치 32개로 300스텝을 학습시키면서 학습률을 17단계로 훑고, 씨앗 둘의 손실을 평균했다(sources/dimuon/s2_lora_toy.py). Dimuon 은 재현 결과의 식을 이 책이 numpy 로 다시 짠 것이다.
| 옵티마이저 | 랭크 2 | 랭크 8 | 랭크 32 |
|---|---|---|---|
| AdamW | 0.0032 → 0.059 | 0.010 → 0.0018 | 0.0056 → 0.0004 |
| Muon | 0.0056 → 0.107 | 0.010 → 0.018 | 0.018 → 0.0077 |
| Dimuon | 0.032 → 0.073 | 0.032 → 0.0057 | 0.032 → 0.0050 |
| Dimuon (조건화 끔) | 0.018 → 0.075 | 0.010 → 0.011 | 0.010 → 0.0065 |
칸마다 「가장 좋은 학습률 → 그때의 손실」이고, 시작 손실은 0.944다. 표에서 먼저 보이는 것은 Dimuon 이 세 랭크 모두에서 원래 Muon 보다 손실이 낮고, 가장 좋은 학습률이 랭크와 상관없이 0.032 한 칸에 머문다는 점이다. 그런데 이 장난감에서 가장 낮은 손실은 AdamW 의 것이다. 정답이 랭크 8 인 선형 문제 하나는 큰 언어 모델의 파인튜닝과 거리가 멀고, 팅커 문서도 강화학습에서는 AdamW 와 비슷했다고 적었다. 이 장난감으로 볼 수 있는 것은 「어느 옵티마이저가 이기나」보다 「각 단계가 무엇을 바꾸나」이고, 이 부록의 나머지에서 단계를 하나씩 떼어 본다. 손실만으로는 보이지 않는 차이도 있는데, 스텝 사이에 무엇을 얼마나 들고 다니느냐다.
문제 1. 랭크 32 의 LoRA 는 얼마나 가벼운가
폭 4096 인 정사각 층에 랭크 32 인 LoRA 를 단다. (가) 학습하는 칸은 층 전체의 몇 분의 1 인가? (나) 뉴턴–슐츠 반복 한 번은 짧은 변이 m, 긴 변이 n 인 행렬에서 곱셈을 대략 2m²n + m³ 번 한다. 4096×4096 행렬 하나와 32×4096 인자 하나를 비교하면? (다) Muon 이 한 스텝에 토큰을 적게 쓰는 파인튜닝에서 덤 계산이 커질 수 있었던 사정은 LoRA 에서 어떻게 바뀌는가?
(가)는 바로 나와요. 전체가 4096² = 16,777,216칸이고, LoRA 는 A 와 B 가 32×4096 씩이니까 2 × 131,072 = 262,144칸이에요. 64분의 1이요.
(나)는 4096×4096 이면 m = n 이라 3 × 4096³ ≈ 2.1 × 10¹¹ 이고, 32×4096 이면 2 × 32² × 4096 + 32³ ≈ 8.4 × 10⁶ 이야. 2만 4천 배쯤 차이 나네.
원래 덤이 커졌던 이유를 다시 떠올려 볼까요? 덤 계산과 원래 계산이 각각 무엇에 따라 늘었죠?
원래 계산은 토큰 수에 비례하고, 직교화는 토큰 수와 상관없이 행렬 크기로만 정해졌어요. 그래서 토큰이 적으면 비율이 커졌고요.
그런데 LoRA 에서는 원래 계산이 그대로 큰 층을 지나잖아. 앞으로 갈 때도 뒤로 올 때도 얼린 4096×4096 을 지나니까 원래 계산은 거의 안 줄어. 덤만 2만 배 넘게 줄어든 거야.
그래요. LoRA 는 학습하는 숫자만 줄이고, 층을 지나는 계산은 그대로예요. 그래서 직교화의 덤은 LoRA 에서 거의 공짜가 돼요.
동아리 단체 티셔츠를 맞출 때 배송비가 주문 한 번에 붙는데, 백 장을 시키면 한 장당 배송비가 거의 안 보이잖아요. 여기선 배송비 자체가 2만 분의 1이 된 거네요.