스텝 크기를 랭크로만 정하기
특잇값이 모두 1인 행렬의 프로베니우스 노름은 √(특잇값 개수) 이므로, 랭크 r 인 LoRA 인자를 직교화하면 노름이 √r 이다. 그런데 Polar Express 를 거친 스텝의 특잇값은 0.87~1.12 사이에서 조금씩 다르고, 조건화까지 거치면 더 크게 달라진다. 그러면 스텝의 크기도 그래디언트에 따라 매번 달라질 텐데, 크기를 그래디언트와 떼어 놓을 수는 없을까?
노름을 아예 정해 두기
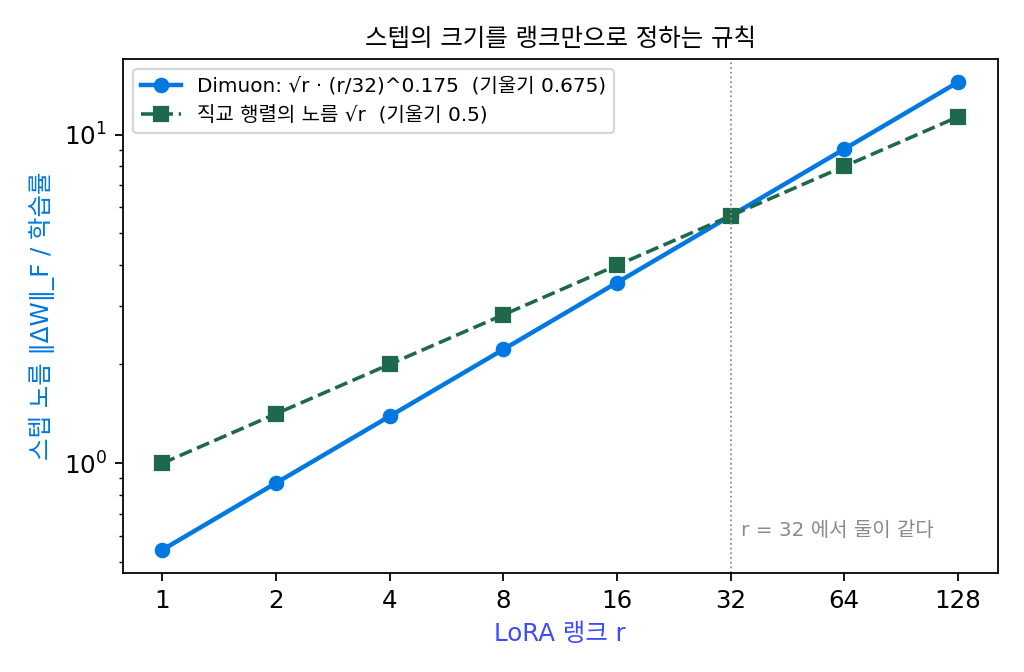
재현한 사람은 서버의 스텝 노름을 학습률로 나눈 값을 랭크, 그래디언트 크기, 모델, 행렬 모양을 바꿔 가며 쟀다. 그 값은 랭크에만 기대었고, 다음 규칙과 백만분의 1.2 안에서 맞았다.
방향 D 는 그래디언트가 정하고 크기는 학습률과 랭크가 정하므로, 그래디언트가 크든 작든 스텝 노름은 늘 같다. 스텝 노름을 그래디언트와 떼어 놓는 점은 Muon 을 다룰 때 본 부호 하강과 닮았다. 부호 하강도 그래디언트의 크기를 버리고 방향만 썼고, 그래서 학습률을 줄여 가야 손실의 바닥 둘레에서 멈출 수 있었다.
| r | √r | (r/32)0.175 | 노름 / η |
|---|---|---|---|
| 1 | 1.000 | 0.545 | 0.545 |
| 8 | 2.828 | 0.785 | 2.219 |
| 32 | 5.657 | 1.000 | 5.657 |
| 128 | 11.314 | 1.275 | 14.420 |
√r 만이었다면 로그–로그 기울기가 0.5 인데, 덧붙은 (r/32)0.175 때문에 기울기가 0.675 다. 랭크가 32 보다 크면 √r 보다 조금 더 큰 스텝을, 작으면 조금 더 작은 스텝을 낸다(sources/dimuon/s3_step_size.py). 왜 0.175 인지는 재현 결과에도 회사 문서에도 없다.
학습률이 AdamW 의 10~100배인 이유
AdamW 는 그래디언트의 이동 평균 m̂ 을 그래디언트 제곱의 이동 평균 v̂ 의 제곱근으로 나눈 m̂/√v̂ 만큼 칸마다 움직인다. 칸마다 m̂/√v̂ 의 제곱평균제곱근을 ρ(로)라 하면, n 개 칸을 가진 행렬의 스텝 노름은 대략 η·ρ·√(칸 수) 다. 첫 스텝은 m̂/√v̂ = ±1 이라 ρ = 1 이고, 그 뒤로는 그래디언트의 부호가 스텝마다 얼마나 일관되는지에 따라 줄어든다. 칸마다 그래디언트를 「신호 + 표준정규 노이즈」로 두고 300스텝 돌리면, 신호 대 노이즈가 0 일 때 ρ = 0.23, 0.3 일 때 0.36, 1 일 때 0.72 다.
폭 4096, 랭크 32 인 인자 A 는 칸이 32 × 4096 = 131,072 개라 AdamW 의 스텝 노름은 η·ρ·362 이고, Dimuon 은 η·5.657 이다. 같은 크기의 스텝을 내려면 Dimuon 의 학습률이 AdamW 의 64ρ 배여야 한다. ρ 가 1 이면 64 배, 0.3 이면 19 배, 0.2 면 13 배다. 팅커 문서가 말한 10~100 배, 지도 학습에서 약 15 배와 강화학습에서 약 60 배가 이 범위에 들어온다. 문서는 강화학습 쪽 배수가 왜 더 큰지 설명하지 않았으므로, 이 계산은 「범위가 맞는다」까지만 말해 준다.
장난감에서도 같은 계산을 해 볼 수 있다. 폭이 256 이면 √(칸 수)/√r = 16 이라 배수는 16ρ/(r/32)0.175 이고, 실제로 가장 좋은 학습률의 비는 랭크 2, 8, 32 에서 10, 3, 6 배였다.
ML에서: 랭크를 바꿔도 학습률을 다시 찾지 않으려면
LoRA 의 표준 형태는 ΔW 에 α/r 을 곱해, 랭크를 바꿔도 고칠 양의 크기가 비슷하게 하려는 장치를 이미 갖고 있다. 그래도 장난감에서 AdamW 의 가장 좋은 학습률은 랭크 2, 8, 32 에서 0.0032, 0.010, 0.0056 으로 움직였다. Dimuon 은 스텝의 노름을 랭크의 함수로 아예 못 박아, 그 함수만 잘 고르면 학습률이 랭크와 떨어지게 했다. 폭이 바뀔 때 학습률과 초기화를 폭의 함수로 맞추는 μP(뮤피)와 같은 생각을, 폭 대신 랭크에 적용한 것이다. 장난감에서 Dimuon 의 가장 좋은 학습률이 세 랭크 모두 0.032 였던 것이 이 규칙의 효과다. 팅커 문서도 Dimuon 이 랭크를 바꿀 때 학습률의 불변성이 AdamW 보다 「조금」 낫다고만 적었다는 점은 같이 기억해 두자.
문제 5. 그래디언트를 열 배 키우면
한 스텝에서 LoRA 인자 A(랭크 32)의 그래디언트가 모두 10 배가 되었다(손실의 크기를 10 배로 키운 것과 같다). 조건화는 끈다고 하자. (가) 경사하강의 스텝은? AdamW 의 첫 스텝은? Dimuon 의 스텝은? (나) 학습 도중 손실이 갑자기 튀어 그래디언트 노름이 100 배가 된 스텝에서 세 옵티마이저는 각각 어떻게 움직이는가? (다) Dimuon 은 그래디언트 클리핑이 기본으로 꺼져 있다. 왜 꺼 둬도 괜찮을 것 같은가? 꺼 두면 막지 못하는 것은 무엇인가?
(가) 경사하강은 스텝이 그래디언트에 비례하니까 10 배. AdamW 첫 스텝은 m̂/√v̂ = ±1 이라 그래디언트 크기와 상관없이 그대로야.
Dimuon 은 방향 D 가 그래디언트를 정규화해서 직교화하니까 안 바뀌고, 노름은 η·√32 로 고정이니까 그대로예요.
(나)는요? 이번엔 한 스텝만 그래디언트가 100 배예요.
경사하강은 그 스텝 하나가 100 배로 튀어요. AdamW 는… 그 스텝에 v̂ 도 같이 커지니까 그 스텝은 크게 안 튀어요. 대신 v̂ 의 이동 평균이 천천히 빠지니까 그 뒤 한동안 스텝이 작아지겠네요.
Dimuon 은 노름은 고정이니까 크기는 안 튀는데, 모멘텀이 그 100 배짜리 그래디언트를 품고 있잖아. β = 0.9 면 0.1 × 100 = 10 배짜리가 모멘텀에 들어가서 몇 스텝 동안 방향을 그 튄 그래디언트 방향으로 끌고 가겠다. 게다가 다음 스텝 조건화도 그 지난 모멘텀으로 계산하고.
그래요. 노름을 고정하면 크기는 지켜도 방향은 지키지 못해요. (다)는 어떻게 생각해요?
크기가 터지는 문제는 노름 고정이 이미 막으니까 클리핑이 할 일이 많이 줄었고… 아, 남는 건 민준이 말한 모멘텀이에요. 클리핑을 켜면 모멘텀에 들어가기 전에 자르니까 튄 그래디언트가 모멘텀을 덜 끌고 가요. 재현 결과에서도 클리핑은 모멘텀 앞, 모든 인자를 합친 노름 하나로 잘랐대요.
그러면 기본값으로 끈 건 「크기는 이미 지켰다」는 뜻이고, 손실이 튀는 데이터가 섞여 있으면 켜 볼 만하겠네.