지난 모멘텀으로 행과 열 고르기
직교화는 특잇값을 모두 1 근처로 맞추지만, 특이 방향 자체는 그대로 둔다. 그런데 LoRA 인자 A 의 그래디언트는 입력 활성값과 오차의 곱이라, 입력의 칸마다 크기가 다르면 그래디언트의 열 크기도 그만큼 다르다. 큰 언어 모델의 활성값에는 다른 칸보다 훨씬 큰 칸이 몇 개씩 있다는 것이 8비트 행렬 곱 연구(데트머스 팀 2022)에서 알려졌다. 그러면 큰 칸들이 특이 방향을 차지하고, 직교화한 스텝도 그 몇 칸에 몰리지 않을까?
입력 크기가 0.1 에서 10 까지인 열 16개
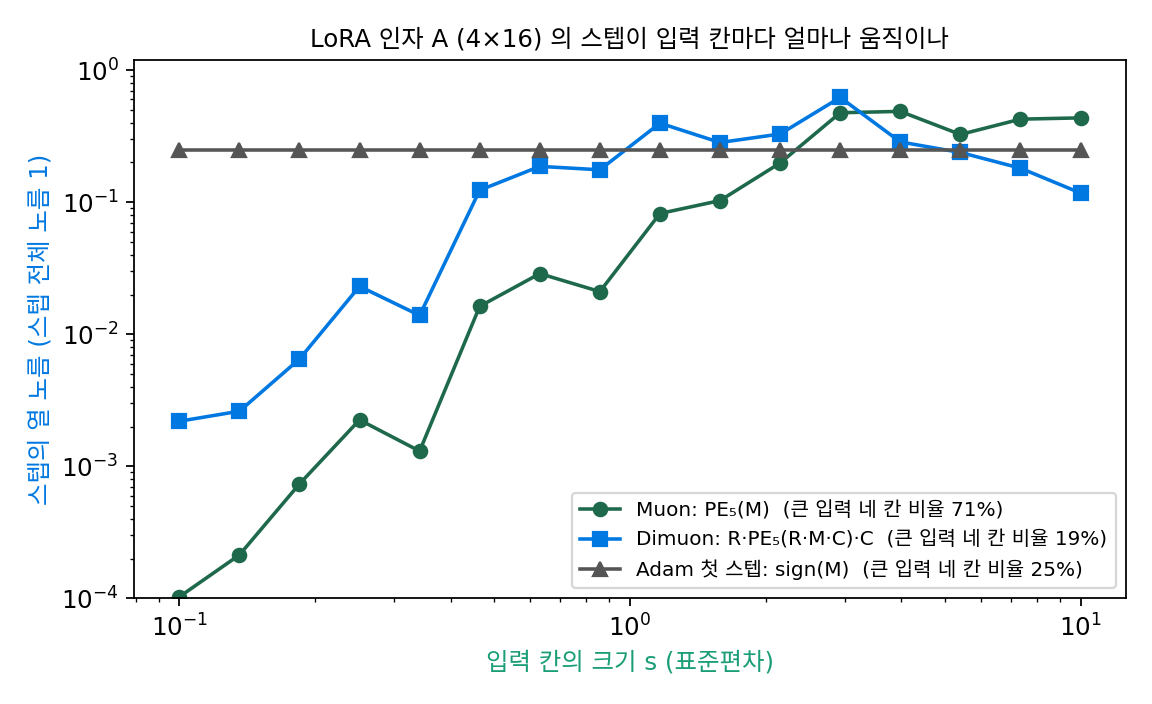
랭크 4 인 인자 A(4×16)를 생각하자. 입력 칸의 크기 sj 가 0.1 에서 10 까지 로그로 고르게 16칸이면, 그래디언트의 열 j 는 대략 sj² 에 비례한다. 표준정규 행렬의 열에 sj² 를 곱한 모멘텀 M 을 만들면 가장 작은 열의 노름은 0.019, 가장 큰 열은 216 이다(sources/dimuon/s4_conditioner.py). 이 모멘텀을 Polar Express 로 직교화하면, 스텝 전체의 제곱합 가운데 가장 큰 입력 네 칸이 71% 를 차지한다. 열이 16개인데 4개가 스텝의 대부분을 가져간다.
Adam 의 첫 스텝은 부호만 남기므로 모든 칸이 같은 크기로 움직이고, 네 칸의 비율은 4/16 = 25% 다. Adam 은 칸마다 따로 나누므로 열의 크기 차이를 지우지만, 행렬의 특이 방향은 보지 못한다. Muon 은 특이 방향을 보지만 열의 크기 차이는 그대로 두는데, 둘의 장점을 함께 얻을 수는 없을까?
양쪽에서 −1/4 제곱
재현 결과의 Dimuon 은 모멘텀을 직교화하기 전과 뒤에 같은 대각 행렬을 곱한다.
에너지가 큰 행과 열은 R 과 C 가 작으니, 직교화하기 전에 미리 눌러 두고 직교화한 뒤에 한 번 더 누른다. 에너지는 칸 크기의 제곱이므로, 양쪽 −1/4 제곱을 합하면 칸 크기로는 대략 −1/2 제곱씩 두 번이다. Adam 이 칸마다 그래디언트 제곱 평균의 제곱근으로 나누는 것을 행과 열의 평균으로 줄여, 직교화 앞뒤에 나눠 넣은 형태다.
| 스텝 | 큰 입력 네 칸의 비율 | 특잇값 최대/최소 |
|---|---|---|
| Muon: PE₅(M) | 71% | 1.29 |
| Dimuon: R·PE₅(RMC)·C | 19% | 5.41 |
| Adam 첫 스텝: sign(M) | 25% | 1.69 |
조건화를 넣으면 큰 입력 네 칸의 비율이 71% 에서 19% 로 내려간다. 대신 스텝의 특잇값이 더는 고르지 않다(최대/최소 5.41). Dimuon 은 특잇값을 모두 1로 맞추는 Muon 의 성질을 일부 내주고 열과 행의 균형을 산 것이다.
왜 「지난」 모멘텀인가
R 과 C 는 이번 스텝의 모멘텀이 아니라 지난 스텝의 모멘텀으로 계산한다. 재현한 사람은 두 스텝 사이에 β 를 0 으로 바꿔 지난 모멘텀이 새 모멘텀에 섞이지 않게 해도 스텝이 지난 모멘텀의 영향을 받는 것을 보고 이 사실을 알아냈다. 첫 스텝에서는 지난 모멘텀이 0 이라 조건화가 꺼진다. 회사가 왜 이렇게 했는지는 밝히지 않았지만, 생각해 볼 수 있는 이유가 셋 있다. 첫째로 조건화에 쓸 통계를 따로 쌓지 않고 이미 저장해 둔 모멘텀에서 얻으므로 옵티마이저 상태가 늘지 않는다. 둘째로 이번 그래디언트가 도착하기 전에 R 과 C 를 미리 계산해 둘 수 있고, 셋째로 이번 그래디언트에 튀는 값이 하나 섞여도 그 값이 자기 자신을 누르는 데 쓰이지 않는다. 셋 모두 이 책의 짐작이다.
조건화를 끄고 같은 장난감을 학습시킨 결과는 「LoRA 의 가는 두 행렬에 Muon 을 쓰면」 절의 표 마지막 줄이다. 랭크 8 에서 손실이 0.0057 에서 0.011 로, 랭크 32 에서 0.0050 에서 0.0065 로 나빠졌고, 랭크 2 에서는 거의 같았다. 가장 좋은 학습률도 0.018, 0.010, 0.010 으로 랭크마다 움직였다.
문제 4. 감쇠 10⁻⁴ 는 무엇을 막는가
조건화는 (상대 에너지 + 10⁻⁴)−1/4 다. (가) 상대 에너지가 1, 0.01, 10⁻⁴, 0 인 행의 조건화 값은? 10⁻⁴ 를 빼면? (나) 행과 열 양쪽에서 곱해지면 한 칸이 받을 수 있는 가장 큰 배율은? (다) 지난 스텝에 그래디언트가 0 이었던 행(예를 들어 그 스텝의 미니배치에 한 번도 나오지 않은 토큰과 이어진 행)이 있다면, 10⁻⁴ 가 없을 때 무슨 일이 생기는가?
(가)는 계산기로 하면 1, 3.154, 8.409, 10.000 이에요. 10⁻⁴ 를 빼면 1, 3.162, 10, 그리고 0 은 0의 −1/4 제곱이라 무한대고요.
(나)는 행에서 10, 열에서 10 이니까 100 배. 에너지가 아무리 작아도 한쪽에서 10 배를 넘지 못하게 막은 거네.
(다)로 가 볼까요. 지난 스텝에 0 이었던 행이 이번 스텝에 작은 그래디언트를 받았다고 해 봐요. 감쇠가 없으면요?
그 행의 조건화가 무한대라… 직교화에 들어가기 전에 그 행이 무한히 커지고, 다른 행은 상대적으로 0 이 돼요. 그러면 직교화한 스텝 전체가 그 한 행에만 쓰이겠네요. 노름을 나중에 고정하니까 크기는 안 터져도, 방향이 거의 모두 그 행 하나로 가요.
잠깐, 그러면 감쇠가 있어도 비슷한 일이 조금은 생기는 거 아니야? 100 배면 꽤 크잖아.
좋은 지적이에요. 에너지 비가 10⁻⁴ 보다 작은 행들은 모두 10 배 근처로 묶여요. 그 아래로는 「얼마나 작은지」를 더 구별하지 않는 거죠. Adam 의 ε(엡실론)가 아주 작은 그래디언트를 나눌 때 분모의 하한이 되던 것과 닮았어요.
상한을 걸어 두고 그 안에서만 고르게 하는 거네요. 택시 할증이 밤에 아무리 늦어도 정해진 배율 넘게는 안 붙는 것처럼요.