블랙박스 옵티마이저를 거꾸로 읽기
지금까지의 식은 모두 재현 결과를 믿고 쓴 것이다. 그런데 서버 안의 코드를 볼 수 없는데, 어떻게 「Polar Express 다섯 번」이나 「지난 모멘텀의 −1/4 제곱」 같은 세부까지 알아냈을까? 팅커 서비스에서 사용자가 할 수 있는 일은 가중치를 정하고, 데이터를 보내 그래디언트를 계산하게 하고, 옵티마이저를 한 스텝 돌리게 하고, 가중치를 내려받는 것뿐이다. 그래디언트 자체도 내려받을 수 없다.
역사: 옵티마이저 한 스텝을 찔러 보기
재현 저장소(github.com/anpaure/dimuon)는 2026년 10월 말에 올라왔다. 저장소의 README 는 옵티마이저 한 스텝을 탐침으로 찔러 식을 알아내는 수법을 마틴 마렉(Martin Marek)이 다른 옵티마이저(StableReinforce)를 거꾸로 알아낼 때 쓴 방법에서 가져왔다고 적었다. 식을 공개하지 않은 기계를 입력과 출력만으로 알아내는 일은 회로나 통신 규약에서 오래 해 온 일이지만, 옵티마이저는 출력이 「한 스텝 뒤의 가중치」 하나뿐이라 무엇을 넣어 볼지를 잘 골라야 한다. 저장소는 일곱 단계를 밟았다. 그래디언트를 엿보는 관측기를 만들고, 스텝 크기의 규칙을 떼어 내고, 직교화 다항식을 가려내고, 모멘텀과 조건화를 알아내고, 클리핑의 자리를 찾고, 16비트·bfloat16 반올림을 맞추고, 전문가 혼합 모델의 경계를 확인했다. 아래는 그 가운데 앞의 셋이다.
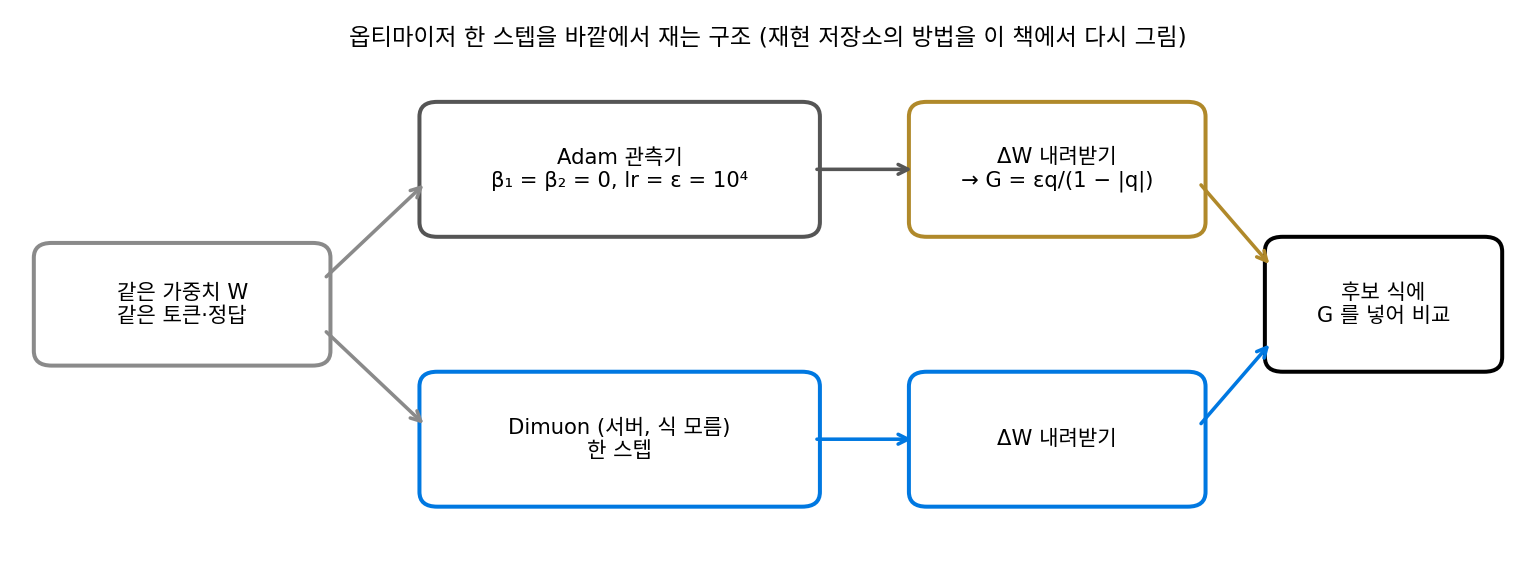
그래디언트를 엿보는 Adam
그래디언트를 내려받을 수 없다면, 그래디언트를 그대로 옮겨 적는 옵티마이저를 한 스텝 돌리면 된다. 이동 평균 계수를 모두 0 으로 둔 Adam 은 m̂ = G, √v̂ = |G| 라 칸마다 이렇게 움직인다.
ε 는 원래 0 으로 나누지 않으려고 넣는 작은 수인데, 여기서는 일부러 10000 처럼 크게 둔다. 그래디언트가 ε 보다 훨씬 작으면 ΔW ≈ −(η/ε)G = −G 라, 스텝이 그래디언트를 거의 그대로 옮겨 적는다. 그래디언트 한 칸이 0.003 이면 ΔW = −0.0029999991 이고, 거꾸로 풀면 0.003 이 그대로 나온다. 장난감 16×64 그래디언트로 해 보면 64비트에서 상대 오차가 10⁻¹⁶, 32비트에서 4.5 × 10⁻⁸ 이다(sources/dimuon/s5_probe.py).
같은 가중치, 같은 토큰, 같은 손실 가중치로 Adam 관측기와 Dimuon 을 나란히 한 스텝씩 돌리면, 관측기에서 그래디언트를, Dimuon 에서 그 그래디언트로 만든 스텝을 얻는다. 남은 일은 그래디언트를 어떻게 바꾸면 그 스텝이 나오는지 맞히는 것이다.
특이 방향에 비춰 다항식 가려내기
첫 스텝은 모멘텀이 0 에서 시작하므로 조건화가 꺼지고, 스텝은 그래디언트를 직교화한 것에 노름만 맞춘 것이다. 직교화는 특이 방향 uᵢ, vᵢ 를 바꾸지 않으니, 스텝을 그래디언트의 특이 방향에 비춘 uᵢᵀ·ΔW·vᵢ 는 다항식이 특잇값 σᵢ 를 어디로 보냈는지를 그대로 보여 준다. 다항식마다 이 응답의 출렁임 모양이 다르다.
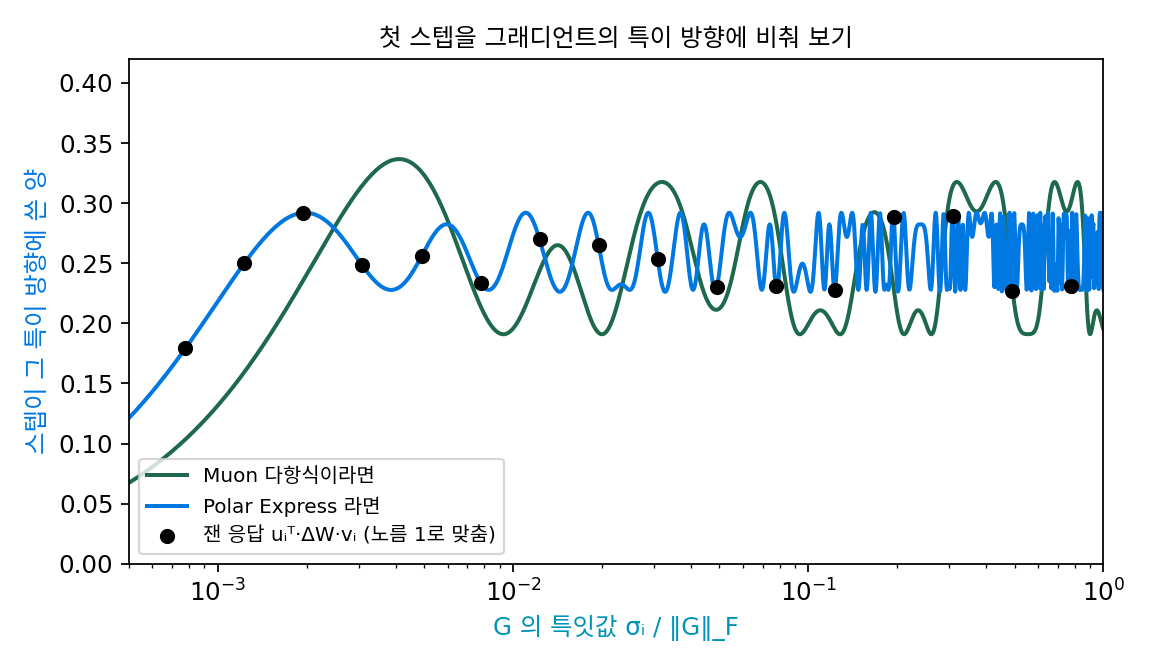
장난감에서 「서버」 자리에 이 책의 Dimuon 을 두고 해 보면, Polar Express 예측과 잰 응답의 차이는 3 × 10⁻¹⁵ 이고 Muon 다항식과의 차이는 0.22 다. 안전 여유를 1.01 대신 0.99 로 바꾼 Polar Express 도 5 × 10⁻⁴ 차이가 나서 가려진다. 재현한 사람도 실제 서버의 스텝으로 이 비교를 했고, 다섯 번의 Polar Express 가 잰 출렁임과 맞고 Muon 의 다항식은 맞지 않는다는 것, 입력을 나누는 수로는 0.99 보다 1/1.01 이 낫다는 것을 얻었다. 스텝 노름을 학습률로 나눈 값을 랭크마다 그려 기울기 0.675 를 찾은 것도, 모멘텀을 이어 쓴 경우와 지운 경우를 비교해 「지난 모멘텀」을 찾은 것도 같은 수법이다. 입력 하나를 바꾸고 출력이 어떻게 바뀌는지 보는 실험을, 바꿀 것을 하나씩 늘려 가며 되풀이한 것이다.
문제 6. ε 를 10000 으로 두는 Adam
관측기 Adam 의 학습률과 ε 를 모두 10⁴ 로 두었다. (가) 그래디언트 한 칸이 −0.25 일 때 ΔW 와 q 는? 되찾은 그래디언트는? (나) 그래디언트가 7 이면 ΔW 는 −6.995 다. ε 를 1 로 두었다면 ΔW 는? 그래도 되찾을 수 있는가? (다) 실제 서버는 가중치를 bfloat16 이나 32비트로 저장할 수 있다. ε 를 아주 크게 두면서 학습률을 같이 키우는 이유는 무엇인가?
(가)는 계산만 하면 돼요. ΔW = −10⁴ × (−0.25)/(0.25 + 10⁴) = 0.24999375 이고, q = −2.4999 × 10⁻⁵ 예요. 식에 넣으면 −0.25 가 그대로 나와요.
(나)에서 ε = 1 이면 ΔW = −10⁴ × 7/8 = −8750 이야. q = 0.875 니까 G = 0.875/0.125 = 7. 식으로는 되찾을 수 있네.
식으로는 되죠. 그럼 그래디언트가 700 이면요? ε = 1 일 때와 ε = 10⁴ 일 때의 q 를 비교해 봐요.
ε = 1 이면 q = 700/701 이니까… 0.99857 이에요. 식에 넣으려면 1 − q 가 필요한데, 0.00143 이네요.
그 0.00143 은 몇 자리까지 믿을 수 있을까요? ΔW 는 가중치로 저장됐다가 내려받은 값이에요.
아, q 가 1 에 붙어 있으니까 1 − |q| 를 계산할 때 앞자리가 다 지워져요. 32비트 가중치는 유효 숫자가 일곱 자리쯤인데, 그 가운데 세 자리를 뺄셈에서 잃어요. 그래디언트가 더 크면 더 잃고요.
아, ε 를 크게 두면 q 가 늘 0 근처라서 1 − |q| 가 1 에 가깝고, 뺄셈으로 숫자를 잃지 않는 거구나. 대신 q 자체가 작아지니까 학습률을 키워서 ΔW 가 가중치의 반올림보다 크게 만들고요.
그래요. 두 수를 함께 키우면 비 η/ε = 1 은 그대로라 스텝이 그래디언트와 같은 크기이면서, 분모의 |G| 는 ε 앞에서 거의 안 보여요. 저울로 작은 물건을 잴 때 큰 추를 같이 올려 눈금이 잘 읽히는 범위에 맞추는 것과 비슷해요.
결국 관측기는 「그래디언트를 옮겨 적는 옵티마이저」가 되도록 Adam 의 숫자를 고른 거네요. 옵티마이저로는 쓸모없는 설정이 측정 장비로는 잘 맞고요.