법선 성분: 디노이저는 자료에서 벗어난 방향만 지운다
어두운 곳에서 찍은 휴대폰 사진은 화소 수백만 개가 각각 조금씩 틀린 밝기를 받아서 자글자글하다. 카메라 앱의 노이즈 제거는 그 사진 한 장만 받을 뿐, 어느 화소에 얼마의 노이즈가 섞였는지 적힌 쪽지는 없다. 노이즈는 모든 화소에 균등하게 섞였는데, 디노이저는 그 가운데 무엇을 알아보고 지울 수 있을까? 노이즈가 섞인 방향 가운데 지울 수 있는 방향과 지울 수 없는 방향이 따로 있을까?
역사: 오토인코더가 배운 화살표
노이즈 섞인 입력을 깨끗하게 되살리도록 신경망을 가르치는 방법은 2008년 빈센트(Pascal Vincent)·라로셸(Hugo Larochelle)·벤지오(Yoshua Bengio)·만자골(Pierre-Antoine Manzagol)의 디노이징 오토인코더로 널리 퍼졌다. 그 이야기는 디퓨전 책에 있으므로 여기서는 그 뒤의 물음 하나만 꺼내는데, 되살리기를 잘 배운 오토인코더는 자료에 대해 무엇을 알게 된 것일까?
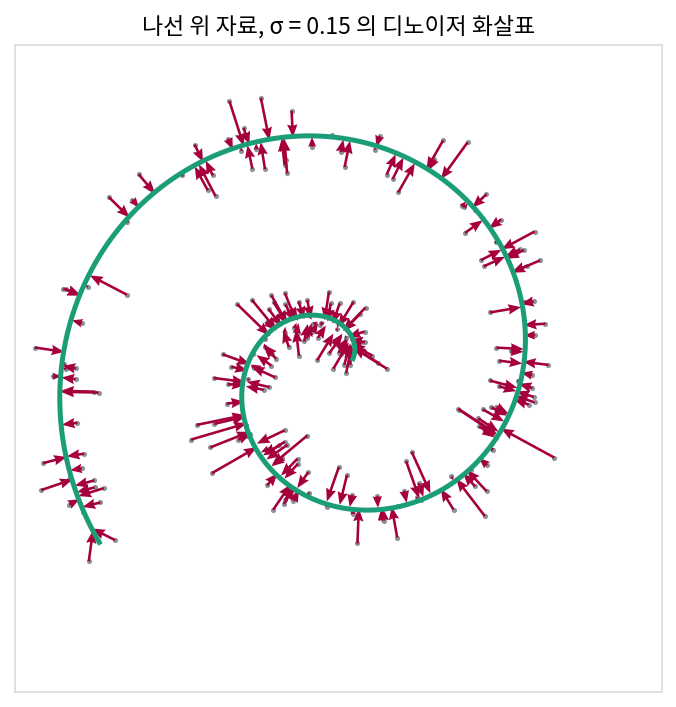
몬트리올 대학의 알랭(Guillaume Alain)과 벤지오는 「규제한 오토인코더는 자료를 낸 분포에서 무엇을 배우는가(What Regularized Auto-Encoders Learn from the Data-Generating Distribution)」라는 논문을 2012년에 원고로 공개했다. 이 논문은 2014년 『Journal of Machine Learning Research』에 실렸다. 그때까지는 되살리기 오차를 「이 입력이 얼마나 자료답지 않은가」를 측정하는 에너지처럼 읽는 해석이 있었다. 두 사람은 이 해석이 맞지 않는다고 보고, 되살린 값에서 입력을 뺀 화살표 r(x) − x 에 눈을 돌렸다. 노이즈가 작은 디노이징 오토인코더와 가까운 학습 기준에서, 이 화살표는 자료 밀도의 로그를 미분한 방향(스코어)을 가리킨다는 것이 그들의 결과다. 논문의 그림 5는 나선 위에 놓인 2차원 자료에서 배운 화살표를 그렸다. 화살표는 나선 밖에서는 가장 가까운 나선 쪽을 가리키고, 나선 위에서는 거의 0이다.
되살린 값에서 입력을 빼서 화살표로 본다는 건 뺄셈 한 번이잖아요. 그게 2012년에야 나온 게 좀 신기해요.
손글씨 숫자 그림으로 오토인코더를 배웠다면, 그 화살표는 몇 칸짜리일까요?
28 × 28 이니까 784칸이요. 아, 784칸짜리 화살표는 그려 볼 수가 없네요.
그려 본다 해도 맞는지 비교할 기준이 있어야 해요. 화살표가 스코어를 가리키는지 확인하려면 무엇을 알아야 하죠?
스코어는 자료 밀도의 로그를 미분한 거니까… 밀도를 알아야 하는데요. 손글씨 그림의 밀도는 아무도 모르잖아요.
그래서 밀도를 손에 쥔 2차원 장난감이 유용해요. 논문의 그림 5도 나선이었죠. 이 화살표를 받아 그림을 만들어 내는 디퓨전 모델은 그로부터 몇 해 뒤에야 나왔고요.
나선 위에서는 화살표가 거의 0이었다고 했죠. 그럼 노이즈 낀 점이 나선을 따라 밀린 만큼은, 화살표가 되돌려 주지 못하는 건가요?
원 위의 점에 노이즈를 섞으면
나선은 모양이 복잡해 화살표의 크기를 계산하기 어렵다. 계산이 끝까지 되는 가장 간단한 굽은 자료로 바꾸자. 반지름 1인 원 위에 균등하게 놓인 점이다. 점 하나는 칸 두 개(가로, 세로)로 적히지만, 원 위에서 움직일 수 있는 방향은 원을 따라 도는 한 방향뿐이다. 겉보기 차원 2, 내재 차원 1이다. 곧은 선 위의 자료는 아래에서 따로 보겠지만, 원은 굽어 있어서 「직선 하나에 사영하면 끝」으로는 풀리지 않는다.
원 위의 점 x₀ 에 세기 σ 의 가우스 노이즈를 섞어 x = x₀ + σε 를 만드는데, 노이즈 ε 는 가로와 세로에 똑같은 크기로 서로 상관없이 섞인다. 노이즈 낀 점 x 만 받아 원래 점 x₀ 를 추정할 때, 제곱 오차의 평균이 가장 작은 답은 「x 를 낳았을 법한 원래 점들의 평균」인 조건부 평균 E[x₀ ∣ x]였다. 내비의 4시간이 막히는 길과 뚫린 길의 한가운데였듯, 이 답도 후보들의 한가운데다. 이 조건부 평균을 가장 좋은 디노이저 f(x) 라 부른다. 이 평균은 노이즈 낀 점들의 분포에서 계산한 스코어와 한 줄로 이어진다.
조건부 평균을 스코어로 적은 등식 f(x) = x + σ²∇ln pσ(x) 를 트위디 공식 (노이즈 낀 관측에서 원래 값의 평균을 스코어로 구하는 식 / Tweedie’s formula)이라 한다. 스코어 ∇ln pσ(x) 는 노이즈 낀 점들의 분포에서 로그 밀도를 x 로 미분한 화살표이고, 공식은 x 에서 그 화살표의 σ² 배만큼 옮긴 자리가 가장 좋은 디노이저의 답이라고 말한다. 알랭과 벤지오가 본 「되살린 값에서 입력을 뺀 화살표가 스코어를 가리킨다」는 결과를, 노이즈가 가우스 노이즈이기만 하면 노이즈 세기와 상관없이 성립하는 등식으로 적은 것이다.
첫 절의 후보 둘 장난감으로 확인해 보자. +1 과 −1 이 반반인 자료에 σ = 0.5 의 노이즈를 섞으면 노이즈 낀 분포는 ±1 둘레의 종 두 개를 반씩 더한 것이고, 그 로그 밀도를 미분한 스코어는 (tanh(x/σ²) − x)/σ² 로 손으로 적힌다. x = 0.2 에서 tanh(0.8) = 0.664 이므로 스코어는 (0.664 − 0.2) ÷ 0.25 = 1.856 이고, 공식의 오른쪽은 0.2 + 0.25 × 1.856 = 0.664 다. 두 후보를 그럴듯함 0.832 와 0.168 로 무게 매겨 낸 평균 0.664 와 같은 값이다.
공식이 왜 성립하는지는 세 줄로 보인다. 노이즈 낀 분포 pσ 는 자료 분포 p 의 점마다 정규분포 종을 씌워 더한 것이다(첫 줄). 이 분포를 x 로 미분하면 종을 미분할 때 나오는 인수 (x₀ − x)/σ² 가 적분 안에 곱해진다(둘째 줄). 양변을 pσ(x) 로 나누면 적분 안의 p(x₀)·N(x; x₀, σ²)/pσ(x) 는 x 를 본 뒤 x₀ 의 그럴듯함, 첫 절에서 0.832 와 0.168 로 맞춘 무게가 되고, 오른쪽은 그 무게로 낸 x₀ − x 의 평균이 된다(셋째 줄).
유도 전체가 「정규분포 종을 x 로 미분하면 (x₀ − x)/σ² 가 곱해진다」는 사실 하나에 기댄다. 그래서 자료가 원 위에 있든 그림이든 노이즈만 가우스 노이즈면 성립하고, 가장 좋은 디노이저를 아는 것과 노이즈 낀 분포의 스코어를 아는 것은 같은 정보를 다른 모양으로 쥐고 있는 것이다.
σ = 0.3 에서 노이즈 낀 점 (1.3, 0.4) 의 조건부 평균은 원 위 점 20,000개로 낸 무게 평균과 식(베셀 함수의 비)이 똑같이 (0.924, 0.284)였다. (1.3, 0.4)에서 (0.924, 0.284)로 가는 화살표는 원점 쪽을 곧게 가리키고, 길이는 0.394다. 디노이저는 점을 원의 지름 방향으로만 옮겼고, 원을 따라 돌리지는 않았다. 도착한 곳이 원보다 조금 안쪽(반지름 0.966)인 것은 원호 위 후보들의 평균이기 때문이다.
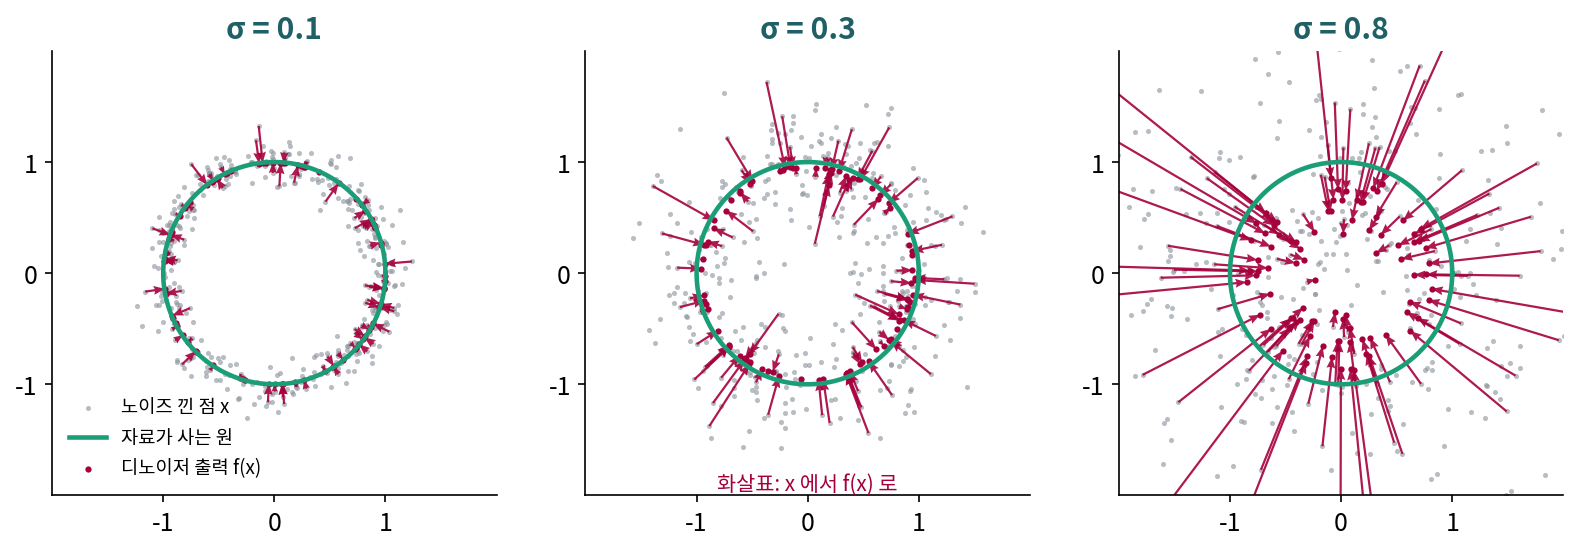
이번에는 점 200,000개에서 오차를 두 방향으로 나눠 측정해 보자. 원래 점 x₀ 에서 원에 수직인 방향(지름 방향)의 단위 벡터를 n̂, 원을 따라가는 방향의 단위 벡터를 t̂ 라 하자. 노이즈 σε 를 n̂ 방향 조각과 t̂ 방향 조각으로 나누면, 원에서 벗어나게 하는 조각이 법선 성분 (자료가 사는 곳에 수직인 방향의 조각, normal component)이고 원을 따라 미끄러지게 하는 조각이 접선 성분이다. 표의 값은 그 방향의 제곱 오차 평균을 σ² 으로 나눈 것이다(s1_arrows.out).
| 노이즈 세기 σ | 디노이저 전: 법선 | 전: 접선 | 디노이저 뒤: 법선 | 뒤: 접선 | 뒤 ÷ 전 |
|---|---|---|---|---|---|
| 0.05 | 0.999 | 0.995 | 0.004 | 0.992 | 0.499 |
| 0.1 | 1.002 | 1.002 | 0.015 | 0.992 | 0.503 |
| 0.3 | 0.994 | 0.999 | 0.172 | 0.883 | 0.529 |
노이즈가 작을 때 디노이저는 법선 성분을 거의 다 지웠고(0.999 → 0.004), 접선 성분은 거의 그대로 남겼다(0.995 → 0.992). 노이즈 낀 점이 원 밖으로 0.05만큼 나가 있으면, 그만큼은 원 위의 어떤 점에서 왔든 노이즈였다고 확신할 수 있다. 하지만 원 위의 모든 점이 똑같이 그럴듯한 출발점이어서, 원을 따라 0.05만큼 밀린 것은 알아볼 길이 없다. 디노이저가 지울 수 있는 것은 자료가 사는 곳에서 벗어나게 한 법선 성분뿐이다. 곧은 도로 위를 달리는 자동차의 GPS 로 옮기면, 도로를 가로질러 찍힌 오차는 「자동차는 도로 위에 있다」는 것만으로 지울 수 있지만 도로를 따라 밀린 오차는 남는다.
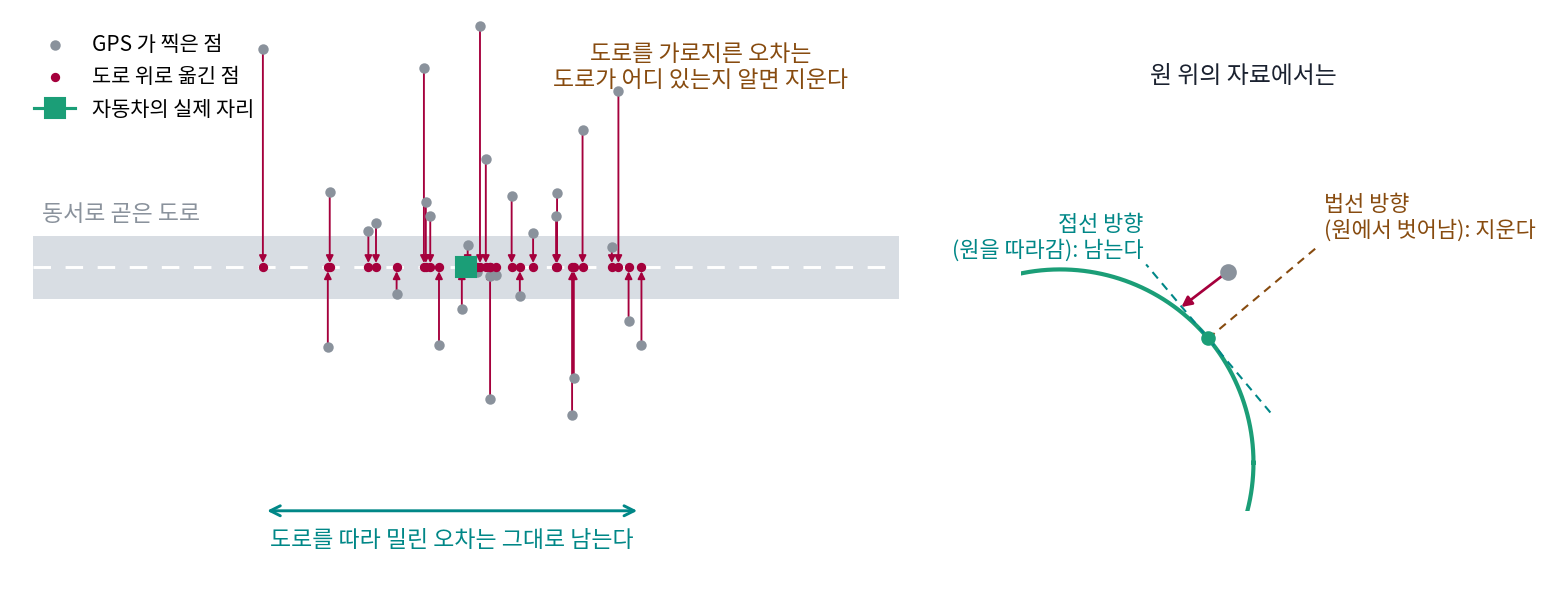
같은 원을 더 많은 칸이 있는 공간에 넣어 보면 이 말의 무게가 드러난다. 앞의 두 칸에만 원을 두고 나머지 칸은 늘 0인 자료를 만들면, 노이즈는 칸마다 섞이므로 제곱 오차의 합은 칸 수 d 에 σ² 을 곱한 값이 된다. 디노이저를 거친 뒤에는 칸 수와 상관없이 σ² 쯤만 남는데, 남은 σ² 은 원을 따라 도는 한 방향의 노이즈다.
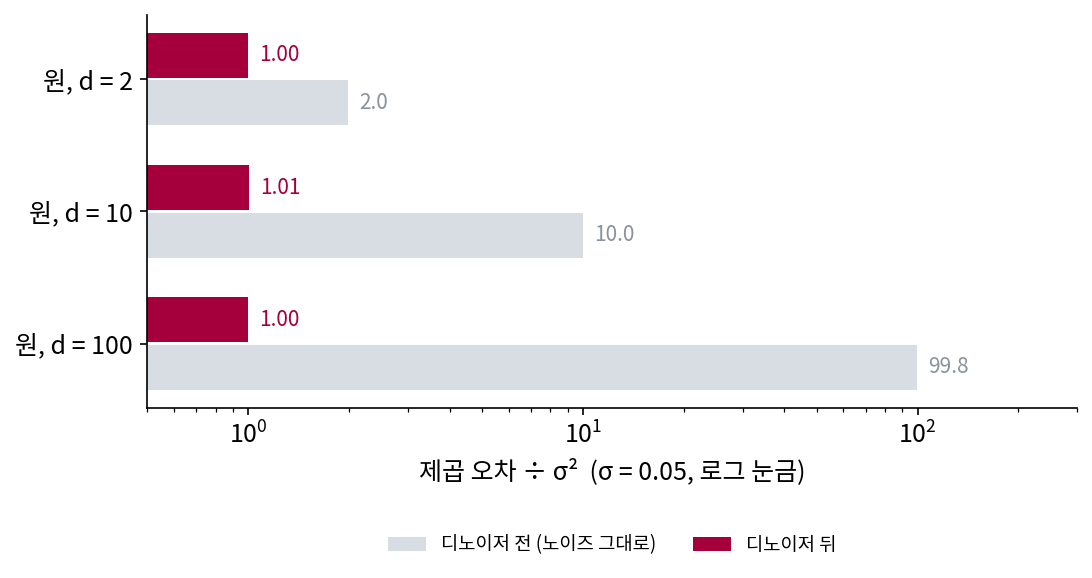
압축의 말로 옮기면 이렇다. 노이즈 낀 점은 d 개의 칸이 모두 제멋대로 흔들린 점이라, 적으려면 d 개의 수가 다 필요하다. 디노이저의 출력은 자료가 사는 k 차원 곳 가까이에 내려앉으므로, 그곳 위의 자리를 적는 k 개의 수면 거의 다 적힌다. 원이라면 각도 하나다. 디노이저는 법선 성분 d − k 개를 「노이즈였다」고 버리고, 접선 성분 k 개만 남기는 손실 압축기처럼 움직인다. 버리는 방향을 알려면 자료가 사는 곳의 모양을 알아야 하므로, 노이즈를 잘 지우는 디노이저는 그 모양을 어딘가에 담고 있다.
ML에서: 디노이징 스코어 매칭이 배우는 화살표
디퓨전 모델의 신경망 fθ 는 깨끗한 그림 x₀ 와 노이즈 낀 그림 x 의 쌍으로 ‖fθ(x) − x₀‖² 의 평균을 줄이도록 배운다. 이 손실을 끝까지 줄인 신경망이 내놓는 것은 위의 조건부 평균 f(x) 이고, 화살표 fθ(x) − x 를 σ² 으로 나누면 스코어가 된다. 그러니 학습이 실제로 하는 일은 그림들이 사는 곳으로 끌어당기는 화살표장을 배우는 것이다. 그림은 수십만 칸으로 적히지만 그 가운데 그림다운 방향은 훨씬 적다는 생각(매니폴드 가설)이 맞다면, 이 화살표는 대부분의 방향을 지우고 몇 안 되는 방향만 남겨야 한다. 몇 방향이 남는지를 실제 신경망에서 측정한 연구는 다음 개념과 함께 본다.
문제 3. 곧은 도로 위 자동차의 GPS
동서로 곧게 뻗은 도로 위를 자동차가 달린다. 휴대폰 GPS 는 동서와 남북으로 각각 표준편차 10 m 의 오차를 서로 상관없이 낸다. 지도 앱은 자동차가 도로 위에 있다는 것을 알고, 찍힌 점을 가장 가까운 도로 위 점으로 옮겨 고친다. (가) 이렇게 고치면 남북 오차가 사라지니 실제 자리까지의 거리가 절반쯤으로 준다는 말은 맞는가? (나) 고치기 전과 뒤에, 찍힌 점과 실제 자리 사이 거리의 제곱 평균은 각각 몇 m² 인가?
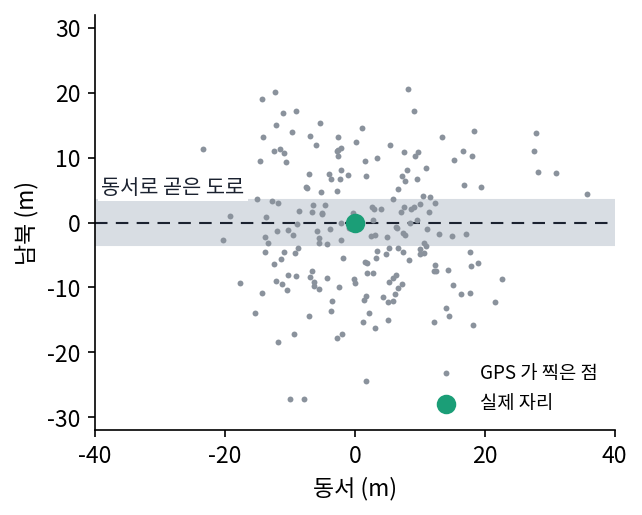
오차가 동서와 남북 두 방향인데 남북이 사라지니까, 반이 남겠네요. 거리로 14 m 쯤이던 게 7 m 쯤으로요.
동쪽으로 8 m, 북쪽으로 6 m 밀려 찍힌 점이 있어요. 고치기 전과 뒤의 거리는요?
전에는 √(64 + 36) = 10 m, 고친 뒤에는 동쪽 8 m 만 남으니까 8 m 요. 반이 아니라 10 m 에서 8 m 네요. 거리는 두 방향 오차를 제곱해 더한 것의 제곱근이라, 한 방향이 사라진다고 반이 되지는 않아요.
그러면 (나)는 칸마다 분산이 100 m² 씩이니까 고치기 전에는 200 m², 고친 뒤에는 동서 100 m² 만 남아. 제곱 평균은 반이 되지만 거리로 치면 14.1 m 가 10.0 m 로, √2 분의 1이야. 모의로 20만 번 뽑아도 199.5 와 100.0 이 나와.
맞춤법 검사기도 그래. 사전에 없는 낱말은 다 잡아내는데, 「반드시」를 「반듯이」로 잘못 쓴 건 둘 다 있는 낱말이라 못 잡잖아. 사전에서 벗어난 오류가 남북 오차고, 사전 안에서 틀린 오류가 동서 오차야.
문제 4. 노이즈가 크면 접선 성분도 줄어든다
원 위의 자료에 노이즈 세기 σ = 0.8 을 섞고 가장 좋은 디노이저로 고쳤다. 오차를 σ² 으로 나눈 값은 디노이저 전에 법선 0.998, 접선 1.000 이었고, 뒤에는 법선 0.615, 접선 0.225 였다. 한 번 고친 점들의 반지름은 평균 0.656 이었다. (가) 작은 σ 에서는 접선 성분이 그대로 남았는데, 여기서는 0.225로 줄었다. 디노이저가 원을 따라 밀린 노이즈까지 알아보게 된 것인가? (나) 법선 성분은 왜 0.615 나 남았는가?
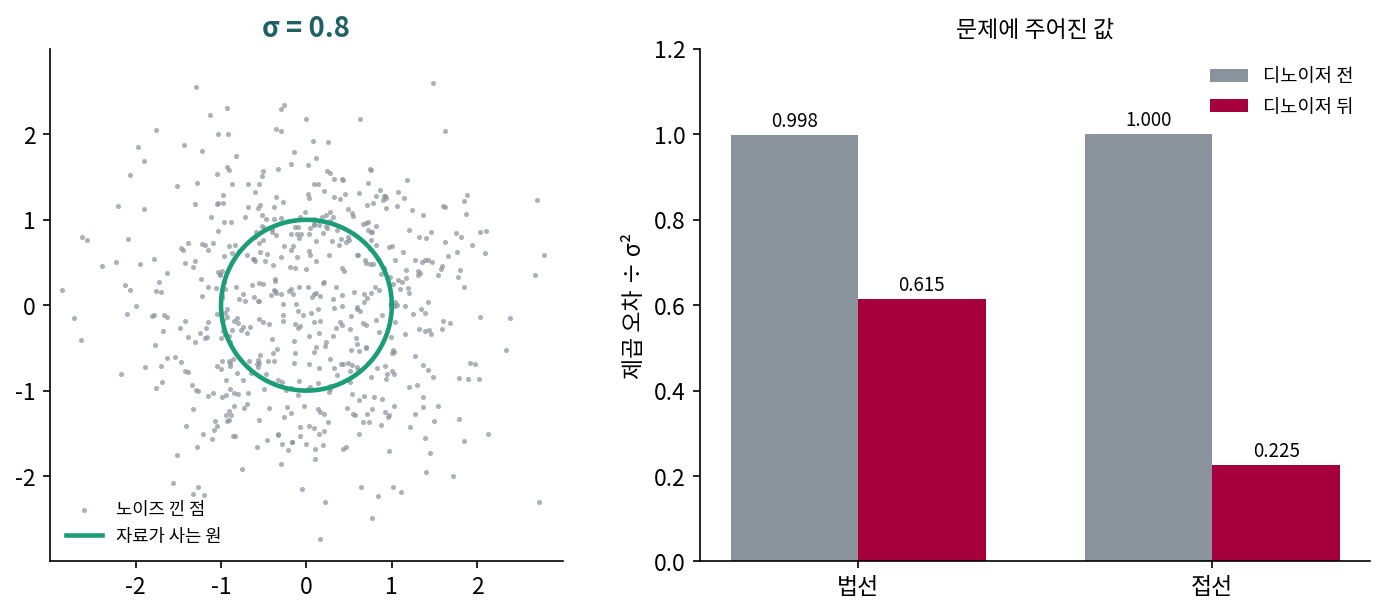
노이즈가 크면 원 둘레의 아무 데서나 왔을 수 있으니까 접선 성분은 더 못 지워야 하는데, 줄었어. 이상해.
디노이저가 더 똑똑해진 거 아니야? 노이즈가 크면 학습할 게 많아서.
이 디노이저는 학습한 게 아니라 식으로 계산한 가장 좋은 디노이저예요. 고친 점은 어디에 있었죠?
반지름 0.656 이요. 원보다 한참 안쪽이네요.
노이즈 낀 점 하나를 받았을 때, 그 점을 낳았을 법한 원래 점들은 원의 어디쯤에 분포해 있을까요?
σ = 0.8 이면… 원 둘레의 꽤 넓은 호에 분포해 있겠네요. 한 점으로 좁혀지지 않아요.
가장 좋은 디노이저는 그 후보들을 받아서 무엇을 내놓죠?
후보들의 평균이요. 호 위의 점들을 평균하면… 원 안쪽 깊숙이 와요. 아, 반지름 0.656 이 그거구나.
그럼 접선 오차가 줄어든 건 각도를 더 잘 맞혀서가 아니야?
응, 「어느 각도인지 잘 모르겠으니 그 후보들 한가운데로 가자」고 한 거야. 출력이 원점 쪽으로 짧아져서 원을 따라 벗어나는 거리 자체가 줄어든 거고.
(나)도 그거구나. 출력이 원 안쪽에 있으니까 원래 점과 지름 방향으로 떨어지게 돼요. 법선 오차가 남은 건 못 지워서가 아니라, 일부러 안쪽으로 들어가서 생긴 거네요.
그래요. 노이즈가 작을 때 디노이저는 원 위로 올려놓는 일만 했어요. 노이즈가 크면 후보들 사이에서 몸을 사리는 일, 그러니까 평균 쪽으로 움츠러드는 일이 더 커져요. 법선을 지우고 접선을 남긴다는 말은 노이즈가 작을 때의 이야기예요.
디노이저가 사영처럼 움직인다는 말에는 「σ 가 충분히 작으면」이라는 조건이 붙어 있었네요. 그 조건을 빼면 같은 디노이저가 전혀 다른 일을 해요.
문제 5. 디노이저의 오차로 내재 차원 측정하기
모양을 모르는 자료가 50칸 공간에 있다. 가장 좋은 디노이저의 오차 합을 σ² 으로 나눈 값이 σ = 0.02, 0.05, 0.1, 0.2 에서 1.988, 2.000, 1.994, 1.957 이었다. (가) 이 자료의 내재 차원은 얼마로 보이는가? (나) 원 위 자료(2칸)에서 같은 값은 σ = 1.0 일 때 0.655 였다. 원에서 측정한 0.655 를 그대로 내재 차원으로 읽으면 무엇이 틀리는가? (다) 학습한 그림 디노이저에 이 방법을 쓸 때 조심할 점은 무엇인가?
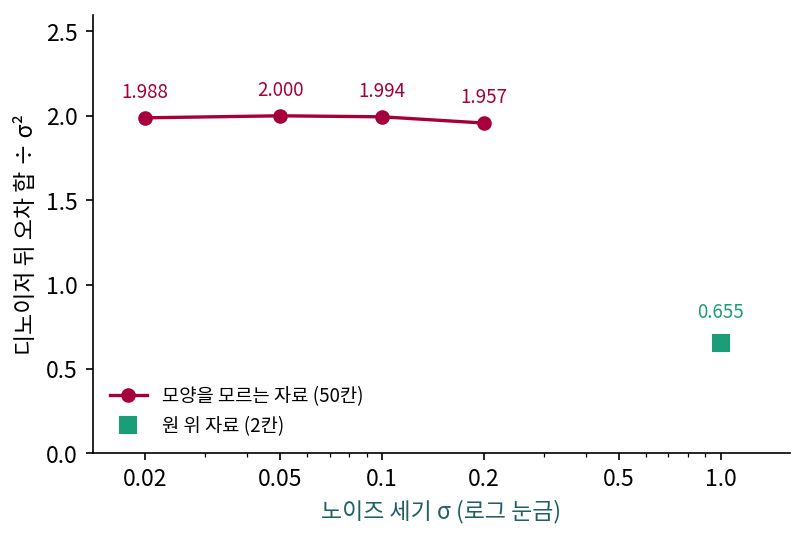
디노이저를 거치기 전에는 노이즈가 칸마다 σ² 씩 섞이니까 오차 합 ÷ σ² 이 50 이겠죠. 디노이저 뒤에는 2쯤만 남았으니까, 자료가 움직일 수 있는 방향이 둘이라는 거예요.
그렇게 읽어도 되는 근거는요?
문제 3 의 도로가 1차원이라 100 m² 하나만 남은 것과 짝이에요. 문제 3 은 방향 하나, 이건 방향 둘이 남았고요. 실제로는 뭐였어요?
반지름 1인 구면을 앞의 세 칸에 넣은 자료예요. 구면 위에서는 위도와 경도 두 방향으로 움직일 수 있죠. 그럼 디노이저를 거친 점은 수를 몇 개 적으면 될까요?
구면 위의 자리니까 위도와 경도 두 개면 돼요. 50칸 가운데 48방향은 지워졌으니까요. 그런데 이 디노이저는 노이즈를 지우는 일만 했지, 줄이려고 한 적은 없잖아요?
그 48방향만 골라 지우려면 디노이저는 무엇을 알고 있어야 하죠?
구면이 어디 있는지요. 아, 축이나 비트라는 말은 한 번도 안 들었는데, 노이즈를 지우다 보니 48방향을 「노이즈였다」고 버리고 50칸짜리 점을 수 두 개로 줄이고 있었네요.
그래요. 버린 48방향은 되돌릴 수 없으니 손실 압축이에요. (나)는요?
0.655 면 원의 내재 차원이 1보다 작다는 말이 되는데… σ = 1.0 이면 노이즈가 반지름만큼 크네요. 문제 4 에서처럼 디노이저가 안쪽으로 움츠러든 경우예요.
그럼 어느 σ 에서 읽어야 할까요?
σ 를 바꿔도 값이 잘 안 변하는 작은 σ 쪽이요. 구면도 σ = 0.2 에서는 1.957 로 조금 내려가기 시작했어요.
(다)는요? 우리는 식으로 계산한 가장 좋은 디노이저를 썼어요.
학습한 디노이저는 가장 좋은 디노이저가 아니니까 오차가 더 커요. 덜 배운 만큼 오차 ÷ σ² 이 부풀어서 내재 차원을 크게 읽게 돼요.
그럼 앞에서 말한 대로 σ 를 아주 작게 해서 측정하면 괜찮을까요?
음… 그림은 원처럼 매끈하지 않잖아요. σ 를 아주 작게 하면 그림 자체의 작은 무늬까지 「자료가 움직일 수 있는 방향」으로 셀 것 같아요. 그럼 어느 σ 에서 재느냐에 따라 답이 달라지겠네요.
축구에서 선수 기여도를 「그 선수를 빼면 팀이 얼마나 지나」로 측정하는데, 대신 들어갈 선수를 잘 못 선택하면 다들 기여도가 커 보이잖아요. 덜 배운 디노이저가 그 서툰 교체 선수네요.