어닐드 랑주뱅: 노이즈를 줄여 가며 걷기
봉우리가 −1.5와 +1.5에 있어 골짜기가 얕을 때는, 점들이 두 봉우리를 오가며 봉우리 비중을 맞췄다. 그림의 분포는 그렇게 너그럽지 않다. 고양이 그림과 자동차 그림 사이에는 어느 쪽으로도 그럴듯하지 않은 그림들이 넓게 깔려 있다. 봉우리가 멀리 떨어지면 랑주뱅 샘플링은 어떻게 될까?
역사: 스코어만으로 그림을 뽑으려다 만난 두 벽
송(Yang Song)과 에르몬(Stefano Ermon)은 2019년 논문 「데이터 분포의 그래디언트를 추정해 만드는 생성 모델」에서 스코어만 배워 랑주뱅 샘플링으로 그림을 뽑는 방법을 시도했다. 그들은 두 벽을 적었는데, 첫째는 데이터가 높은 차원 공간의 얇은 면 근처에만 모여 있다는 점이었다. 데이터가 없는 넓은 곳에서는 스코어를 배울 근거가 거의 없어서, 2차원 장난감에서도 배운 스코어는 봉우리 바로 둘레에서만 믿을 만했다. 둘째는 랑주뱅 샘플링이 「섞이는 데 느리다」는 것이었다. 비중이 1/5과 4/5인 두 정규분포를 멀리 떨어뜨린 혼합에서 정확한 스코어로 랑주뱅 샘플링을 돌려도 두 봉우리의 비율이 맞지 않았다.
두 사람이 찾은 길은 데이터에 여러 크기의 노이즈를 섞어 노이즈 크기마다 스코어를 배워서, 두 벽을 한꺼번에 푸는 것이었다. 노이즈를 크게 섞으면 데이터가 넓게 퍼져 빈 곳이 줄고, 봉우리 사이 골짜기도 메워진다. 그림을 뽑을 때는 가장 짙은 노이즈의 분포에서 랑주뱅 스텝을 몇 번 걷고, 노이즈를 한 단계 줄인 분포에서 다시 몇 번 걷는 일을 반복한다. 그림 실험에서는 노이즈의 표준편차를 1에서 0.01까지 등비로 줄어드는 열 단계로 두고 단계마다 100스텝을 걸었으며, 스텝 크기는 그 단계 노이즈 분산에 비례하게 잡았다. 논문은 이 방법이 금속을 천천히 식히는 시뮬레이티드 어닐링과 어닐드 중요도 샘플링에서 착안했다고 적었다.
노이즈를 섞어서 빈 곳을 메운다는 거, 지금 보면 당연해 보여요. 디퓨전 모델은 다 그렇게 하잖아요.
지금은 그렇죠. 그런데 노이즈를 섞으면 배우는 것은 그림의 분포가 아니라 일부러 망가뜨린 그림의 분포예요. 그게 왜 문제일까요?
음, 노이즈를 섞은 분포의 스코어는 데이터의 스코어가 아니니까요. 노이즈를 작게 섞으면 데이터에 가깝지만 빈 곳이 그대로 남고, 크게 섞으면 빈 곳은 메워지는데 다른 분포가 돼요.
노이즈 크기 하나로는 그 맞바꿈을 피할 수 없어요. 그래서 두 사람은 크기를 하나로 선택하지 않고 열 단계를 다 썼어요. 신경망 하나가 노이즈 크기를 함께 받아서 단계마다의 스코어를 내놓게 했고요.
그런데 배운 스코어가 봉우리 둘레에서만 맞는다는 건 어떻게 알았어요? 그림에서는 참 스코어를 모르잖아요.
그래서 2차원 장난감을 썼어요. 참 스코어를 식으로 아는 분포라야 배운 스코어와 비교해 볼 수 있으니까요. 차원이 3,072인 32 × 32 컬러 그림에서는 배운 스코어가 어디서 틀리는지 직접 측정할 방법이 없었어요.
그런데 둘째 벽은 스코어가 정확해도 생겼잖아요. 스코어를 정확히 아는데도 비율이 틀린다면, 걷는 점들은 어디서 길을 잃는 거예요?
멀리 떨어진 두 봉우리
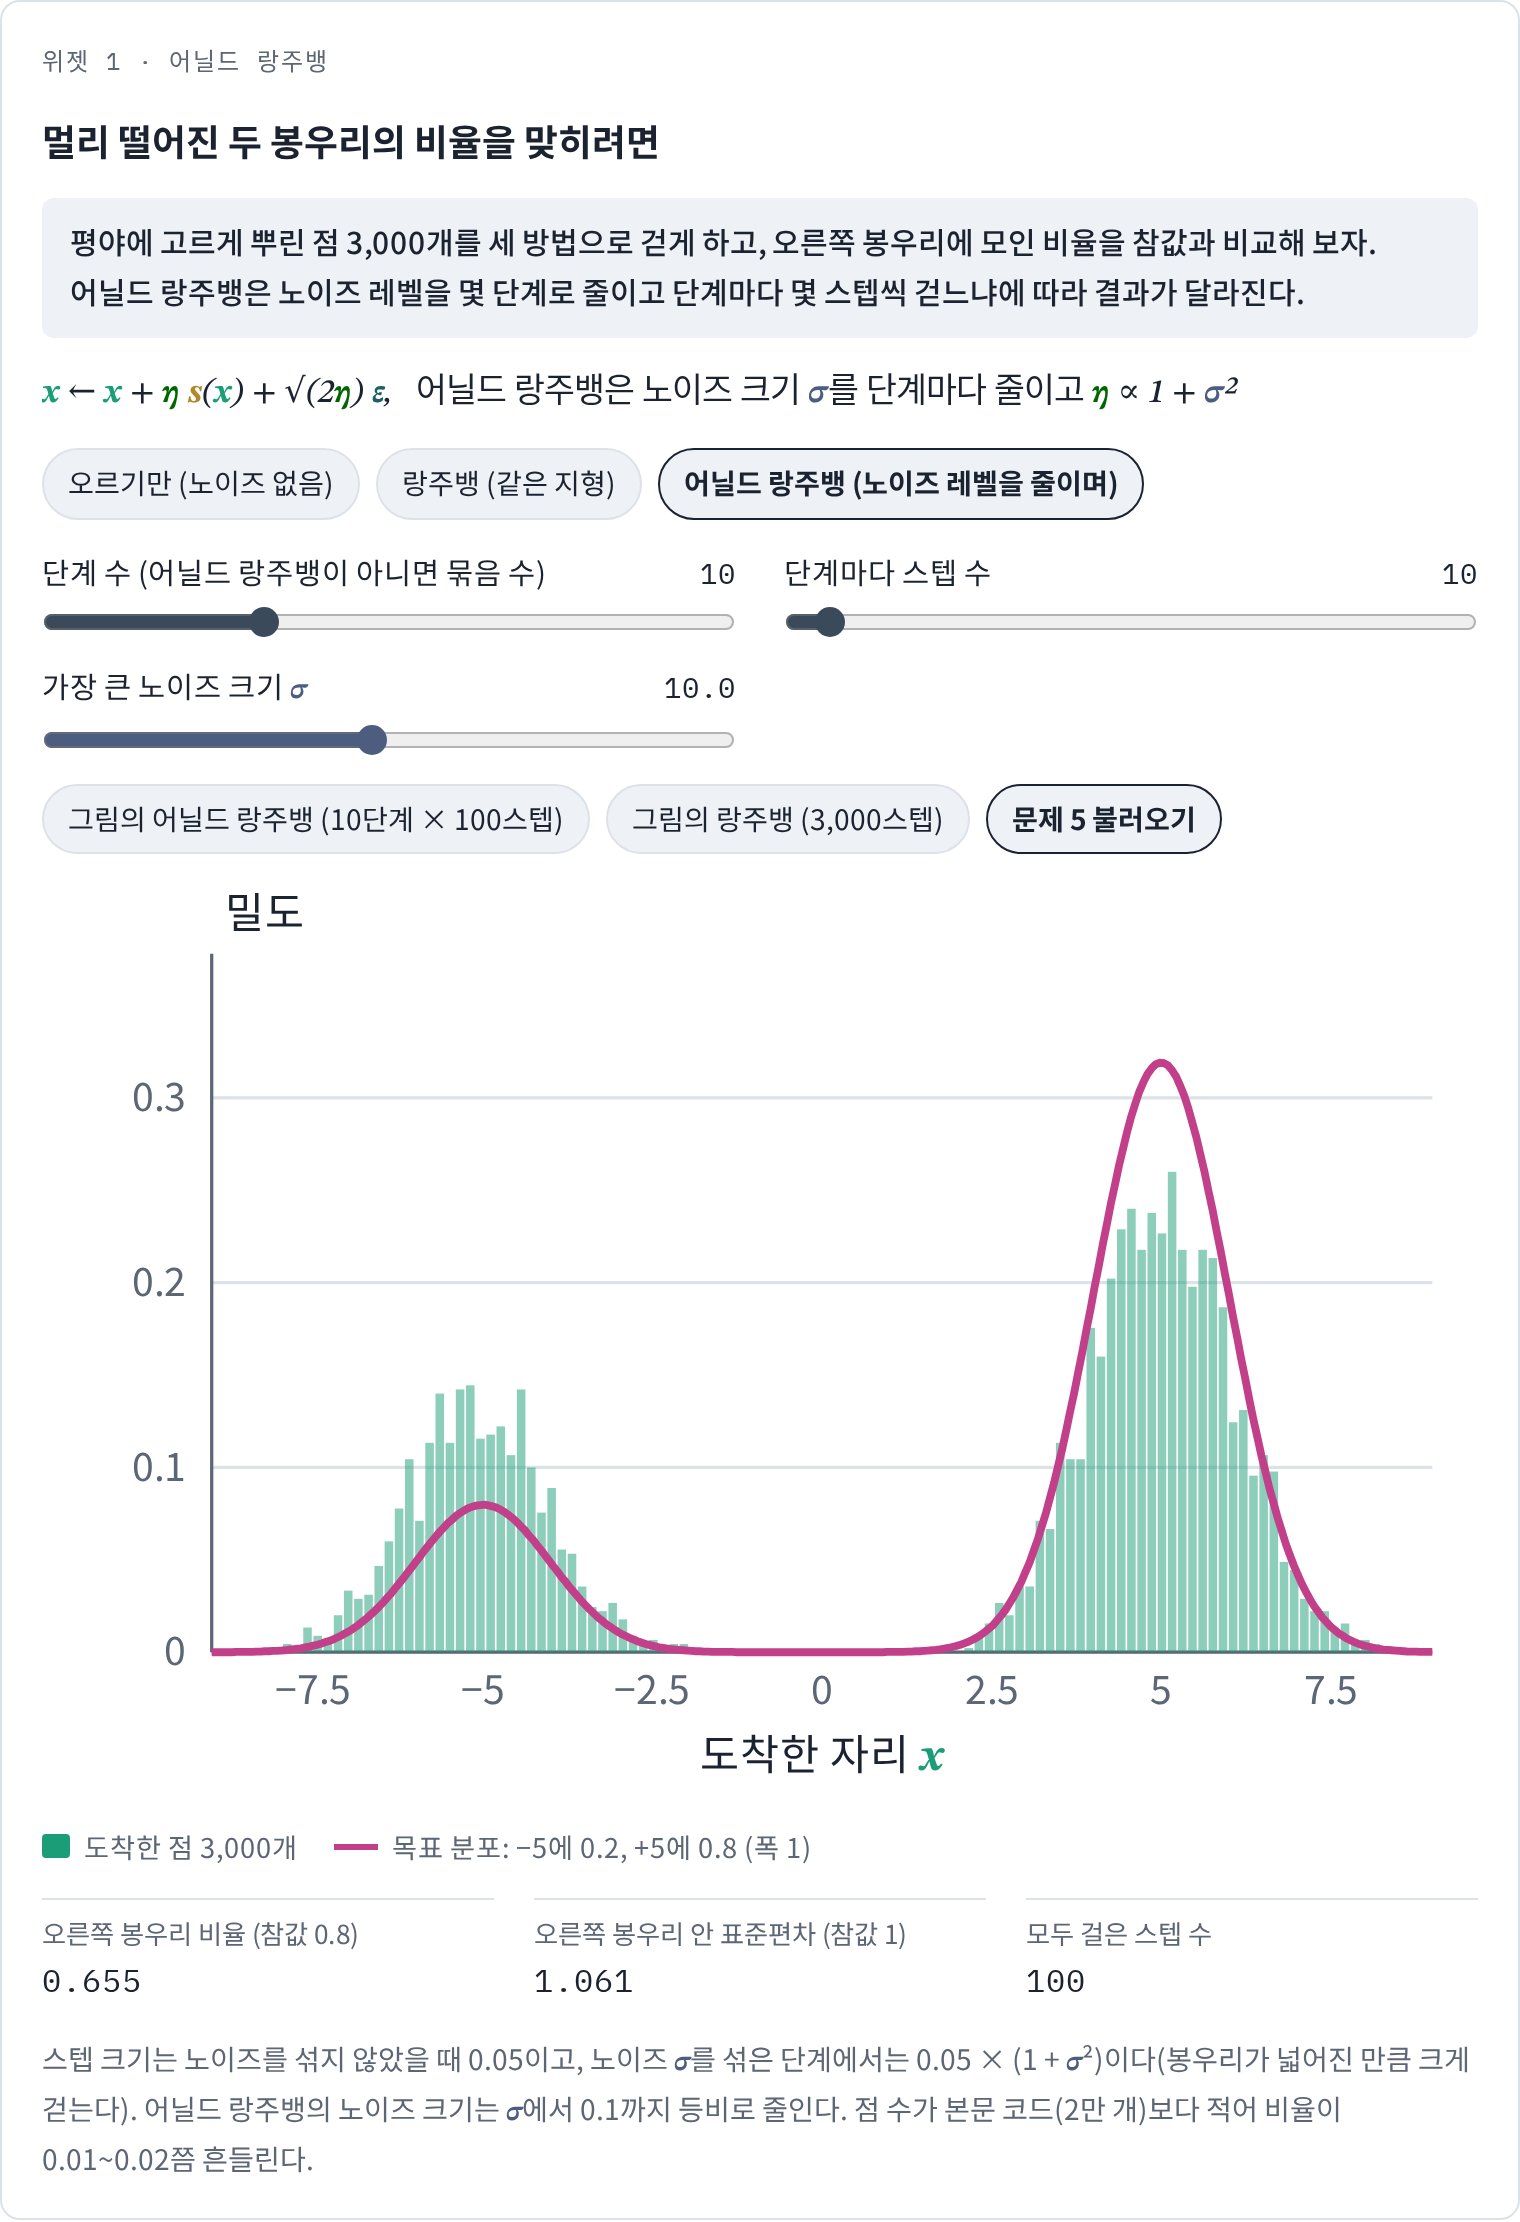
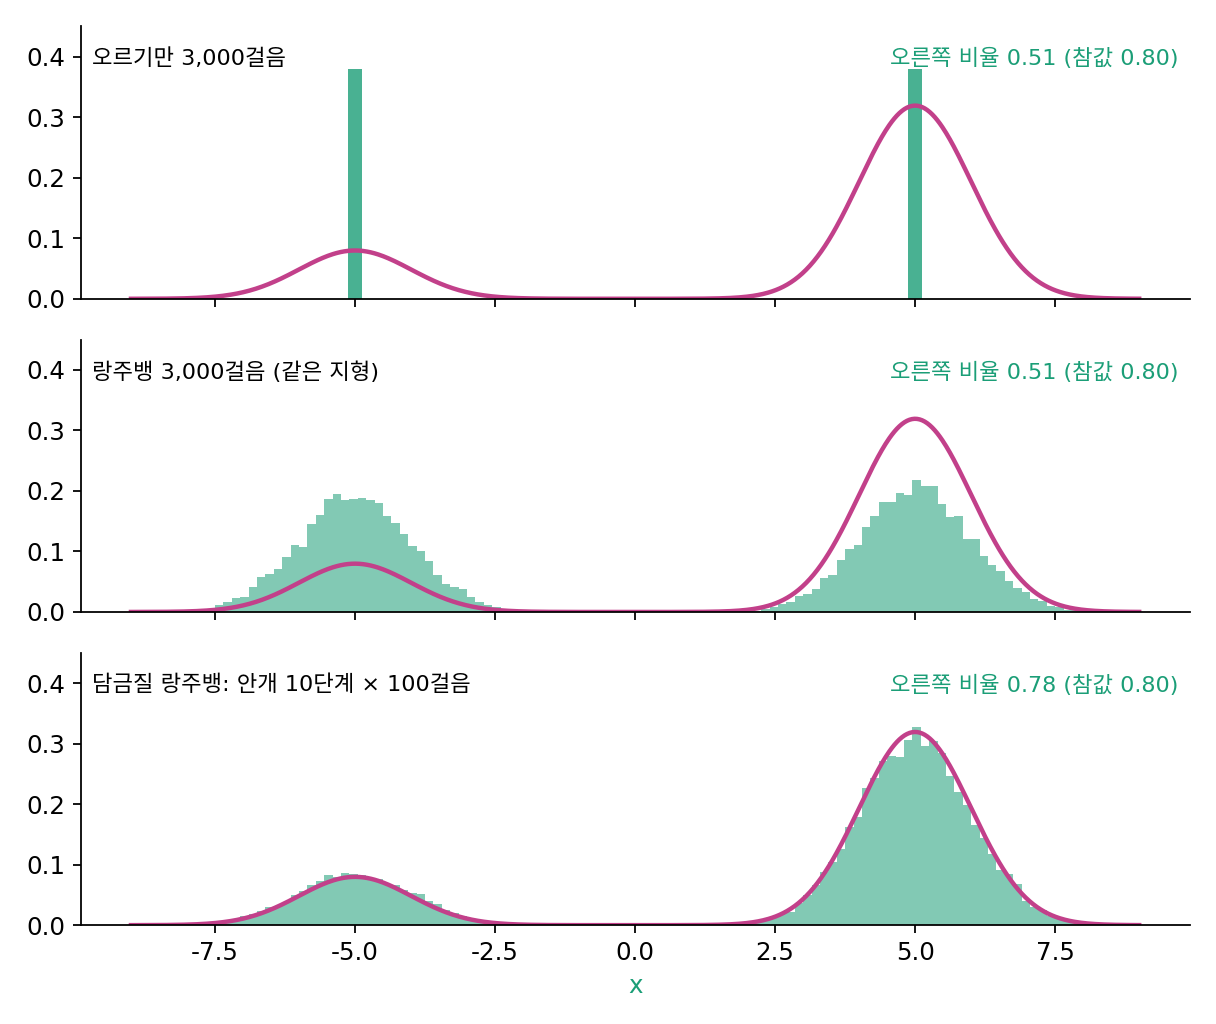
봉우리를 −5(비중 0.2)와 +5(비중 0.8)로 떼어 놓자(폭 1). 앞과 같이 −8과 8 사이에 균일하게 뿌린 점 2만 개를 스텝 크기 0.05로 걷게 하면, 오르기만 하면 오른쪽 비율이 0.511이고, 랑주뱅 샘플링으로 3,000스텝을 걸어도 0.514다. 스텝을 열 배인 3만 스텝으로 늘려도 0.518이다. 봉우리 안의 모양(표준편차 1.005)은 맞는데 비율은 처음 뿌린 비율(0.51)에서 거의 움직이지 않는다. 두 봉우리 한가운데(x = 0)의 −log p는 왼쪽 꼭대기보다 10.89, 오른쪽 꼭대기보다 12.28 높다. 골짜기에 설 확률이 꼭대기의 수만분의 일이라, 걷는 점이 그 사이를 건너는 일은 거의 일어나지 않는다. 처음에 어느 쪽에 떨어졌는지가 끝까지 남는다.
이제 지형에 노이즈 크기 σ(시그마)를 섞으면 봉우리마다 분산이 1 + σ²로 넓어진다. σ를 10에서 0.1까지 등비로 줄이는 열 단계를 두고, 단계마다 그 지형의 스코어로 랑주뱅 스텝을 100번 걷는다. 스텝 크기는 0.05 × (1 + σ²)로, 봉우리가 넓어진 만큼 크게 걷는다.
모두 1,000스텝 걸은 뒤 오른쪽 비율은 0.779로 참값 0.8에 다가가고, 봉우리 안 표준편차도 1.008로 맞는다. σ가 클 때는 두 봉우리가 큰 언덕 하나로 합쳐져 있어서 점들이 그 언덕의 모양대로, 다시 말해 비중대로 먼저 나뉘고, 그다음에 σ가 줄며 각 봉우리로 내려앉는다. 이렇게 노이즈를 섞은 지형에서 시작해 노이즈를 단계마다 줄여 가며 그 단계의 스코어로 랑주뱅 스텝을 걷는 방법을 어닐드 랑주뱅 (노이즈 레벨을 단계마다 줄여 가며 걷는 랑주뱅 / annealed Langevin dynamics)이라 한다. 「어닐링」은 영어 annealing(달군 금속을 천천히 식혀 결함을 줄이는 공정)을 소리 나는 대로 적은 말이다.
ML에서: 노이즈 레벨마다의 스코어를 쓰는 첫 샘플러
어닐드 랑주뱅에는 노이즈 레벨마다의 스코어가 필요하다. (그림, 노이즈) 쌍으로 스코어를 배우는 디노이징 스코어 매칭이 노이즈 레벨마다의 스코어를 준다. 송과 에르몬의 신경망은 그림과 노이즈 크기 σ를 함께 받아 그 수준의 스코어를 내놓았고, 그림 한 장을 뽑을 때 열 단계 × 100스텝으로 신경망을 1,000번 불렀다. 같은 노이즈 크기에서 100스텝씩 머무는 것은 그 단계의 분포에 점들이 자리 잡을 때까지 기다리는 일이다. 노이즈 레벨이 계속 줄어드는데도 매번 한자리에서 기다려야 하느냐는 물음에, 다음 절의 역방향 SDE는 기다리지 않아도 된다고 답한다.
문제 4. 비중을 모르는 스코어
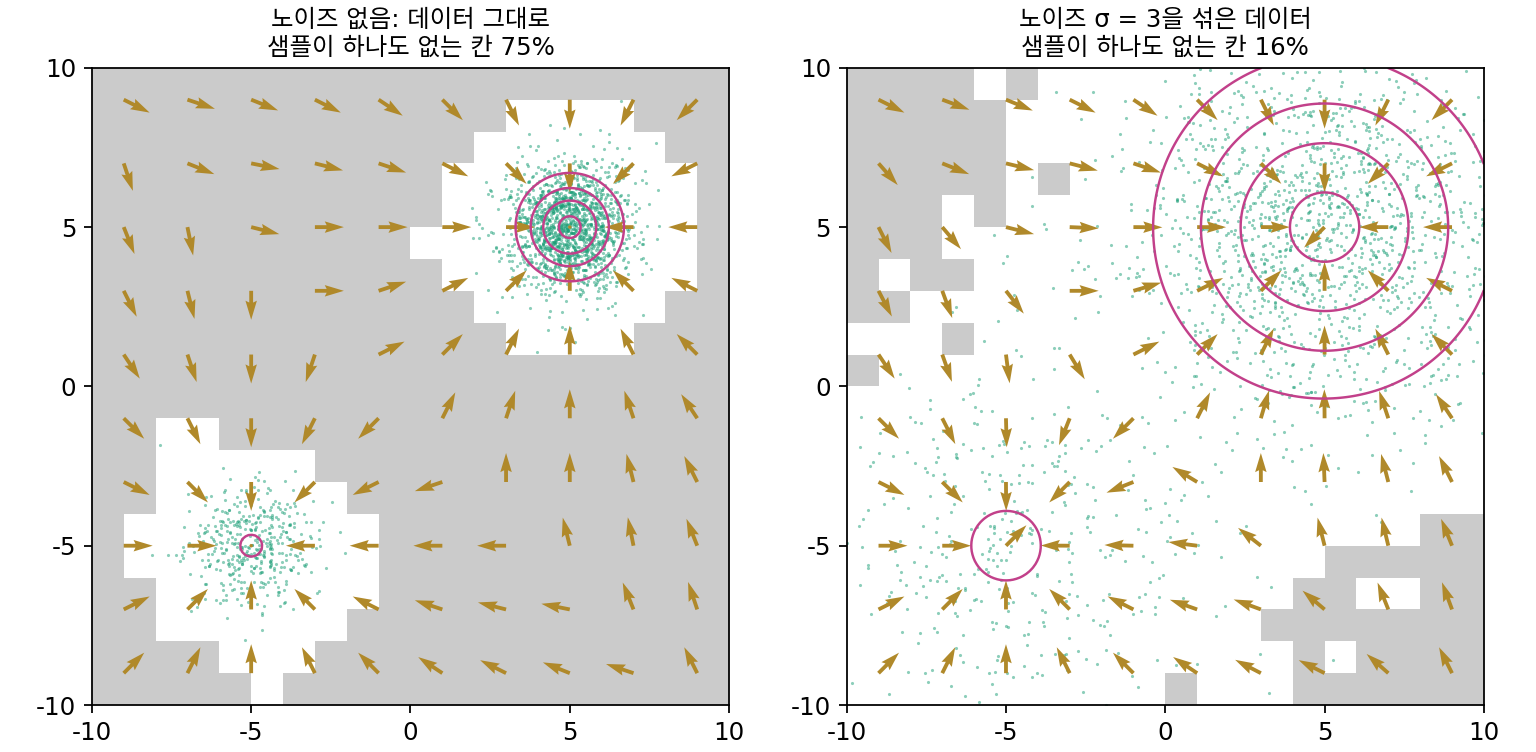
−5와 +5에 봉우리를 둔 두 정규분포의 혼합(폭 1)인 데이터에서, 비중이 0.2와 0.8일 때와 반반일 때 두 분포의 스코어를 비교한다. (가) x = 4와 x = −4에서 두 스코어는 각각 얼마인가? (나) x = 0에서는? (다) 노이즈 σ = 3을 섞은 두 분포(봉우리 분산 10)의 스코어를 x = 0과 4에서 비교하면?
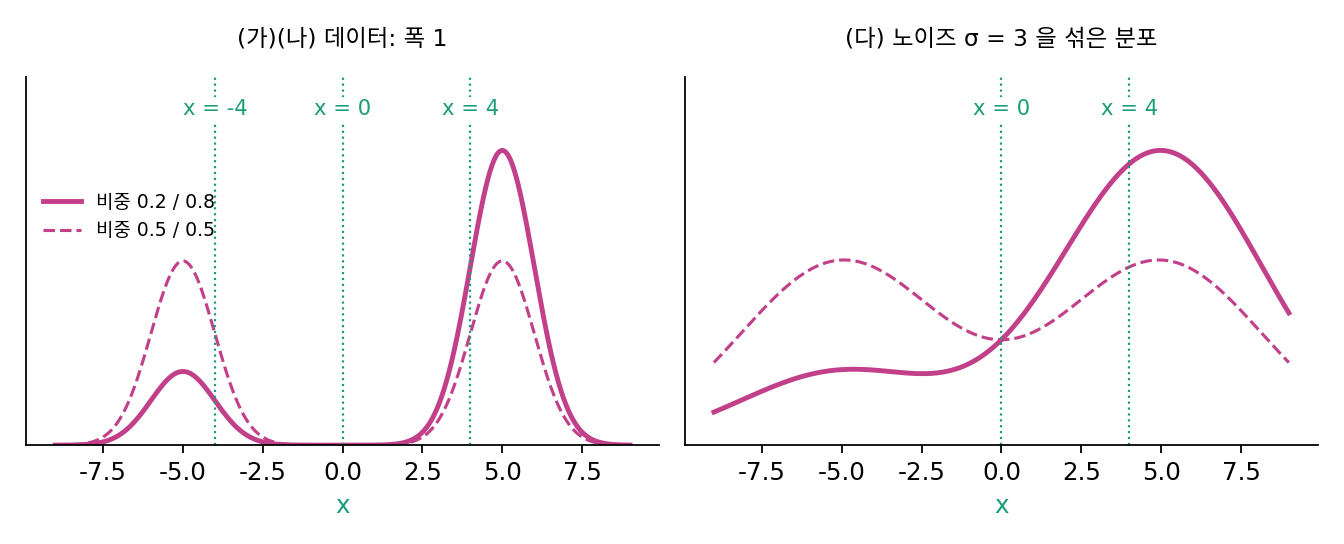
x = 4에서 계산해 볼게요. 0.2/0.8일 때 1.000000, 반반일 때도 1.000000이에요. 소수 여섯째 자리까지 같아요. x = −4에서도 둘 다 −1.000000이고요.
비중이 네 배나 다른데 스코어가 똑같아? 0.8짜리 봉우리 쪽이 더 세게 끌 줄 알았는데.
+5 봉우리 바로 옆에서는 −5 봉우리의 확률 밀도가 e^(−40)쯤이라 사실상 0이야. 그러면 log(π₂p₂) = log π₂ + log p₂인데, log π₂는 상수라 미분하면 사라져. 스코어에는 +5 봉우리 하나의 스코어만 남아.
그럼 비중은 스코어 어디에 들어 있어요?
(나)를 보면 x = 0에서 0.2/0.8은 3.0, 반반은 0이에요. 여기서는 달라요.
그럼 비중은 가운데에만 들어 있는 거야?
두 봉우리의 확률 밀도가 비슷한 골짜기에서만 비중이 스코어를 바꾸는 거지. 그런데 걷는 점은 거의 그 골짜기에 가지 않으니, 비중을 알려 주는 스코어를 읽을 일이 없어.
(다)는 노이즈 σ = 3을 섞으면 x = 0에서 0.3과 0이고, x = 4에서도 0.0954와 0.0820으로 달라요. 노이즈를 섞으면 봉우리가 넓어져서 점들이 서는 곳 어디서나 스코어에 비중이 드러나는구나.
σ가 클 때 비중대로 먼저 나뉘고, 그다음에 σ를 줄이니까 비율이 맞는 거야. 노이즈가 정보를 가리기만 하는 게 아니라 먼 봉우리의 비중을 가까이 실어 오네.
지도 앱에서 확대한 채로는 옆 동네가 얼마나 큰지 모르다가, 축소해 보면 어느 동네가 큰지 보이는 거랑 같네요. 축소 배율이 노이즈 크기 σ고요.
문제 5. 단계마다 몇 스텝
문제 4의 0.2/0.8 지형에서, σ를 10에서 0.1까지 열 단계로 줄이되 단계마다 걷는 스텝 수를 줄여 본다(점 2만 개, 스텝 크기 0.05 × (1 + σ²)). 본문의 100스텝일 때 오른쪽 비율은 0.779였다. (가) 단계마다 10스텝, 3스텝, 1스텝이면 오른쪽 비율과 오른쪽 봉우리 안 표준편차는 어떻게 되는가? (나) 모두 걷는 스텝 수를 100이나 300으로 정해 둔다면, 단계 수와 단계마다 스텝 수를 어떻게 나누는 편이 나은가? (풀어 본 뒤 위젯 1의 「문제 5 불러오기」로 확인해 보자.)
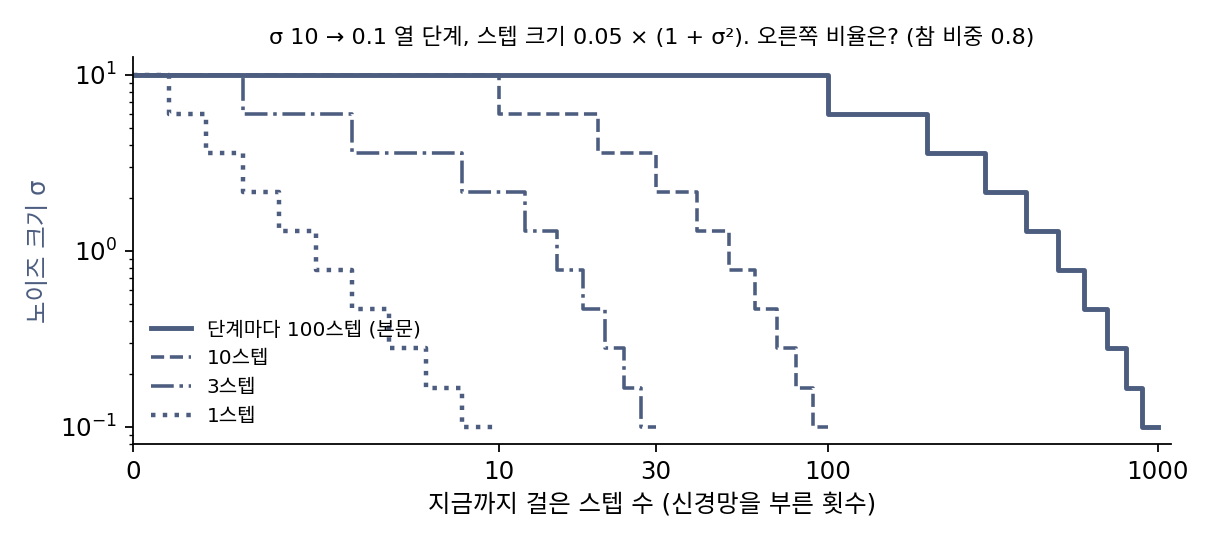
돌려 봤어요. 10스텝이면 0.650, 3스텝이면 0.580, 1스텝이면 0.541이에요. 표준편차도 1.037, 1.753, 2.478로 커지고요. 단계마다 1스텝이면 신경망을 열 번만 부르면 되는데, 비율도 모양도 다 틀려요.
각 단계에서 점들이 그 단계의 분포에 자리 잡기 전에 σ가 줄어 버린 거야. σ가 클 때 퍼져 있던 모양이 그대로 남아서 표준편차가 큰 거고.
(나)는요? 모두 100스텝이면 10단계 × 10스텝과 100단계 × 1스텝이 있어요.
100단계 × 1스텝이 0.658로 10단계 × 10스텝의 0.650보다 조금 나아요. 300스텝이면 30단계 × 10스텝이 0.746이고요.
같은 스텝 수라면 한 단계에서 오래 머무르는 것보다 σ를 잘게 나눠 조금씩 줄이는 편이 낫구나. 단계 사이 분포 차이가 작으면 점들이 따라가기 쉬우니까. 그러면 단계를 끝없이 잘게 나누고 단계마다 한 스텝씩만 걸으면 어떻게 될까?
좋은 물음이에요. σ를 연속으로 줄이면서 스텝마다 한 번씩만 스코어를 읽는 방법에서 노이즈를 얼마나 넣어야 하는지가 다음 이야기예요.
시험 전날 밤새는 것보다 매일 조금씩 공부하는 게 낫다는 말이 숫자로 나왔네요.
위젯 1에서 문제 5 설정을 불러와, 단계마다 스텝 수를 줄일 때 히스토그램의 비율과 폭이 어떻게 바뀌는지 확인해 보세요.