확률 플로우 ODE: 노이즈 없이 같은 분포로
역방향 SDE에서 노이즈를 빼면 점들이 꼭대기로 몰렸다. 그런데 처음부터 노이즈 없이 걷던 거꾸로 흐르기(x + DsΔt)는 데이터 분포에 그대로 닿았다. 둘 다 「노이즈를 넣지 않는」 스텝인데 무엇이 다를까? 역방향 SDE에서 새로 넣는 노이즈 항을 끄면, 점들은 모두 봉우리 한가운데로 몰려야 할까?
노이즈 항을 끄는 두 방법
평면에 봉우리 일곱 개를 비중 0.12~0.18로 둔 분포가 있다(봉우리마다 폭 0.4). 노이즈 크기 σ = 8로 분포한 점 4,000개를 σ = 0.01까지 500스텝에 걸쳐 세 규칙으로 걷게 한다. 역방향 SDE는 스텝마다 줄어드는 노이즈 분산만큼 스코어 방향으로 걷고, 같은 분산의 노이즈를 새로 넣는다. 둘째 규칙은 새 노이즈만 끄고, 셋째 규칙은 새 노이즈를 끄는 대신 스코어 방향 스텝을 절반으로 줄인다.
| 규칙 | 봉우리마다 도착한 비율과 참 비중의 차이 (총변동) | 가운데 봉우리 비율 (참값 0.12) | 봉우리 안의 퍼짐 (참값 0.4) |
|---|---|---|---|
| 역방향 SDE (노이즈 있음) | 0.017 | 0.12 | 0.39 |
| 노이즈만 끔 | 0.586 | 0.64 | 0.24 |
| 노이즈를 끄고 스텝을 절반으로 | 0.019 | 0.13 | 0.39 |
총변동은 두 비율 표의 차이 절댓값을 더해 반으로 나눈 값이고, 0이면 두 표가 똑같다. 노이즈만 끈 점들은 64%가 한가운데 봉우리에 집중되고 봉우리 안에서도 뭉친다. 스텝을 절반으로 줄인 점들은 노이즈 없이도 역방향 SDE와 같은 비율, 같은 퍼짐으로 도착한다. 스텝을 절반으로 줄인 규칙은 역방향 SDE에서 랑주뱅 스텝 한 쌍(스코어 항 절반과 노이즈)을 모두 뺀 것이고, 노이즈만 끈 규칙은 쌍에서 노이즈만 빼고 스코어 항은 남긴 것이다.
노이즈 없이 거꾸로 가는 식에 붙은 이름
역방향 SDE에서 랑주뱅 스텝 한 쌍을 빼는 일을 일반적인 형태에서 하면, 스코어 항 g²sΔt가 절반이 되고 노이즈 항이 사라진다.
이 책의 기본 일정(f = 0, g² = 2D)을 넣으면 x + DsΔt, 곧 노이즈가 섞이며 퍼지는 흐름의 속도 v = −Ds를 거꾸로 따라가던 스텝과 같은 식이다. 노이즈가 하나도 없는 보통의 미분방정식(ODE, ordinary differential equation, 상미분방정식의 머리글자)인데, 매 순간 점들의 분포는 역방향 SDE와 똑같이 pt다. 이 상미분방정식을 확률 플로우 ODE (노이즈 섞인 분포의 흐름을 노이즈 없이 따라가는 상미분방정식 / probability flow ODE)라 한다. 송과 동료들은 2021년 논문에서 역방향 SDE와 같은 분포에서 샘플을 뽑는 이 ODE를 함께 내놓으며, 이 식으로는 그림의 우도를 정확히 계산할 수 있고 샘플을 더 적은 계산으로 뽑을 수 있다고 적었다.
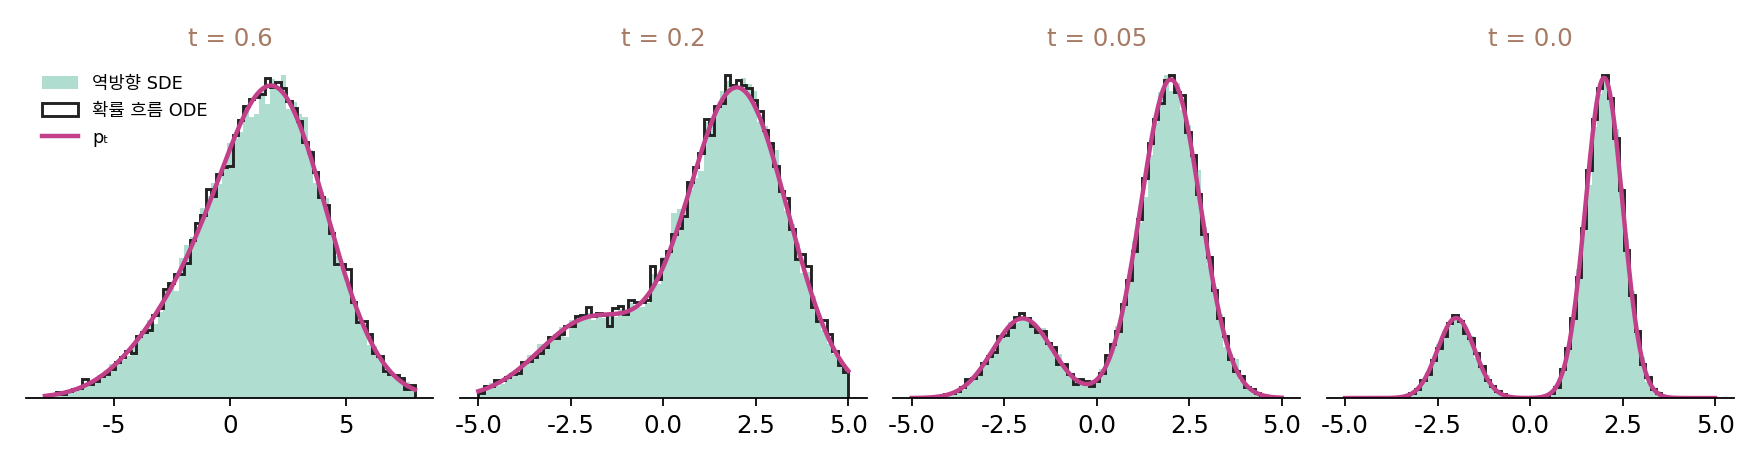
그러면 출발점이 도착점을 완전히 정하는 ODE에서 다양성은 어디서 올까? 0.3에서 출발한 점을 확률 플로우 ODE로 두 번 걸으면 두 번 다 1.620에 닿고, 역방향 SDE로 걸으면 씨앗(난수)에 따라 2.364, 2.318처럼 달라진다. 확률 플로우 ODE가 내놓는 그림의 다양성은 모두 출발점, 다시 말해 t = 1에서 뽑은 처음 노이즈에서 온다. 역방향 SDE가 새로 넣는 노이즈는 다양성의 원천이 아니라 같은 분포에 이르는 또 하나의 걷는 방식이다.
ML에서: 그림과 노이즈를 오가는 지도
확률 플로우 ODE는 시간을 어느 쪽으로든 풀 수 있다. −2(비중 0.2)와 +2(비중 0.8), 폭 0.5인 두 봉우리 데이터를 D = 4로 퍼뜨린 경우에 점 −2.3, 1.1, 2.0, 2.6을 이 ODE로 t = 0에서 1까지 앞으로 풀면 −4.26, −1.192, 2.135, 5.464에 닿고, 거기서 거꾸로 풀면 처음 네 점이 10⁻¹²보다 작은 차이로 돌아온다. 그림 한 장을 노이즈 하나로, 그 노이즈를 다시 같은 그림으로 옮기는 일대일 지도다. 그래서 실제 그림을 노이즈 쪽으로 보냈다가 다시 그림 쪽으로 풀어 볼 수 있고, 송과 동료들이 말한 우도 계산도 이 일대일 대응에 기댄다. 역방향 SDE에는 스텝마다 새 노이즈가 들어가니 이런 지도가 없어서, 같은 출발점에서도 매번 다른 그림이 나온다.
문제 9. 발표 순서 정하기
네 조가 한 학기 동안 매주 발표한다. (가) 매주 제비를 새로 뽑아 순서를 정하는 방법과, 첫 주에만 제비를 뽑고 그 뒤로는 매주 순서를 한 칸씩 돌리는 방법이 있다. 두 방법에서 민준이네 조가 5주째에 첫 번째로 발표할 확률은 각각 얼마인가? (나) 두 방법은 무엇이 다른가?
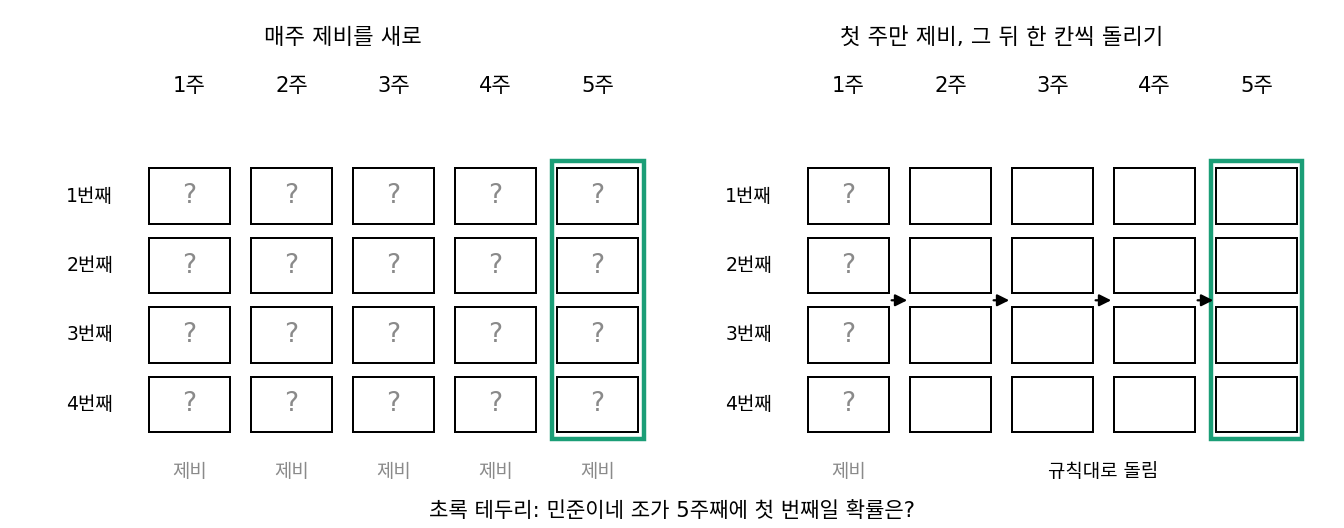
매주 새로 뽑으면 1/4이에요. 한 번만 뽑는 쪽은… 첫 주 제비가 네 가지 가운데 하나로 균등하게 나오니까, 5주째 순서도 네 가지 가운데 하나로 정해져요. 그래서 역시 1/4이에요.
그럼 두 방법이 똑같은 거야?
(나)는 한 주씩 떼어 보면 두 방법 모두 매주 1/4이야. 다른 건 주와 주 사이의 관계지. 한 번만 뽑으면 이번 주 순서를 알면 다음 주 순서도 정해지고, 매주 뽑으면 아무 관계가 없어.
무작위가 한 번만 들어가도, 그 무작위가 처음에 고르게 흩어져 있으면 매 순간의 분포는 같을 수 있어요.
문제 10. 노이즈 없는 스텝은 무너지는가
데이터가 N(0, 1)이고 D = 1.5로 노이즈를 섞어, 시간 t의 분포가 pt = N(0, 1 + 3t)이다(t = 1에서 N(0, 4)). 확률 플로우 ODE를 t = 1에서 0까지 풀면, N(0, 4)에서 뽑은 출발점들은 어떤 분포에 닿는가?
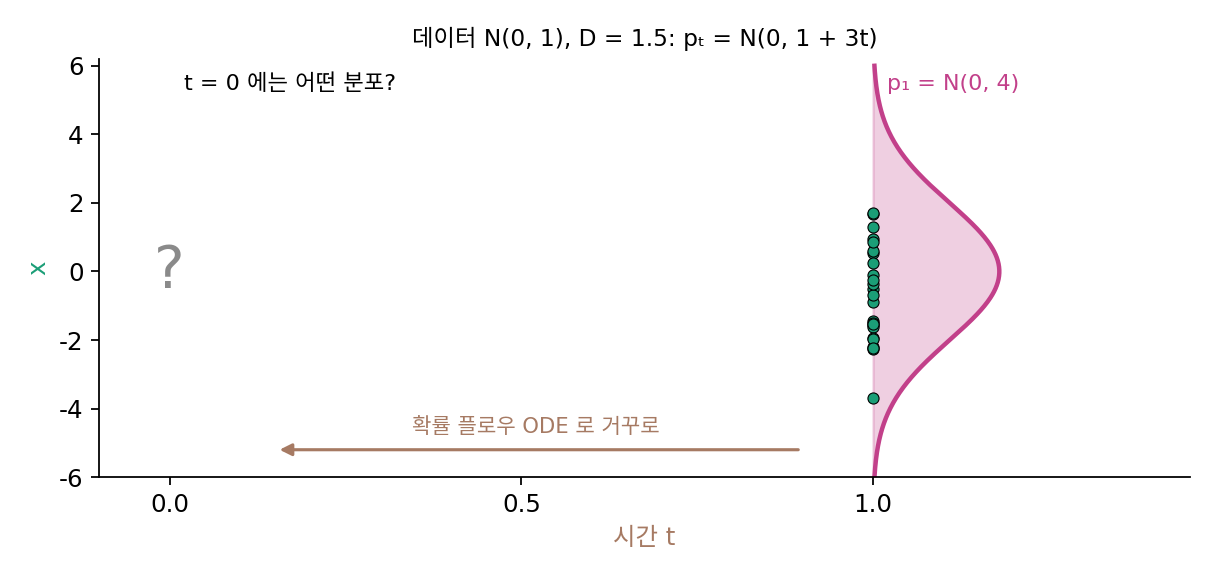
데이터가 N(0, 1)이니까 스코어는 −x예요. 스텝이 x + 1.5 × (−x)Δt니까 시간 1을 거꾸로 오면 x(0) = x(1)e^(−1.5)예요. 표준편차가 2 × 0.223 = 0.446이에요. 데이터보다 훨씬 좁아요. 역시 노이즈 항이 없으면 쪼그라드나 봐요.
그 스코어는 몇 시의 분포예요?
아… 데이터 분포요. 시간 t의 분포는 N(0, 1 + 3t)라서 스코어가 −x/(1 + 3t)예요.
민준 학생, 그 스코어로 다시 풀어 봐요.
스텝이 x + 1.5xΔt/(1 + 3t)… 풀면 x가 √(1 + 3t)에 비례해요. t = 1에서 0으로 오면 x(0) = x(1)/2예요.
N(0, 4)를 반으로 줄이면 N(0, 1)이에요. 20만 개로 돌려도 표준편차 1.001이고요. 무너지지 않아요. 데이터 스코어로 돌렸을 때만 0.446이 나와요.
랑주뱅 스텝에서 노이즈를 끈 것과 무엇이 달라요?
랑주뱅은 지형이 하나로 고정돼 있어서 노이즈를 끄면 모두 꼭대기로 가요. 확률 플로우 ODE는… 지형이 매 순간 바뀌네요.
출발점들은 어떻게 놓여 있었죠?
N(0, 4)로 흩어져 있어요. 스코어 항도 역방향 SDE의 절반이라, 그 흩어짐이 표준편차 2에서 1로 고르게 줄어들 뿐 사라지지 않아요.
발표 순서 문제랑 같네요. 제비는 처음 한 번 뽑았고, 그 뒤는 정해진 규칙대로 가도 매 순간의 분포는 맞아요.
문제 11. 출발점이 틀렸을 때
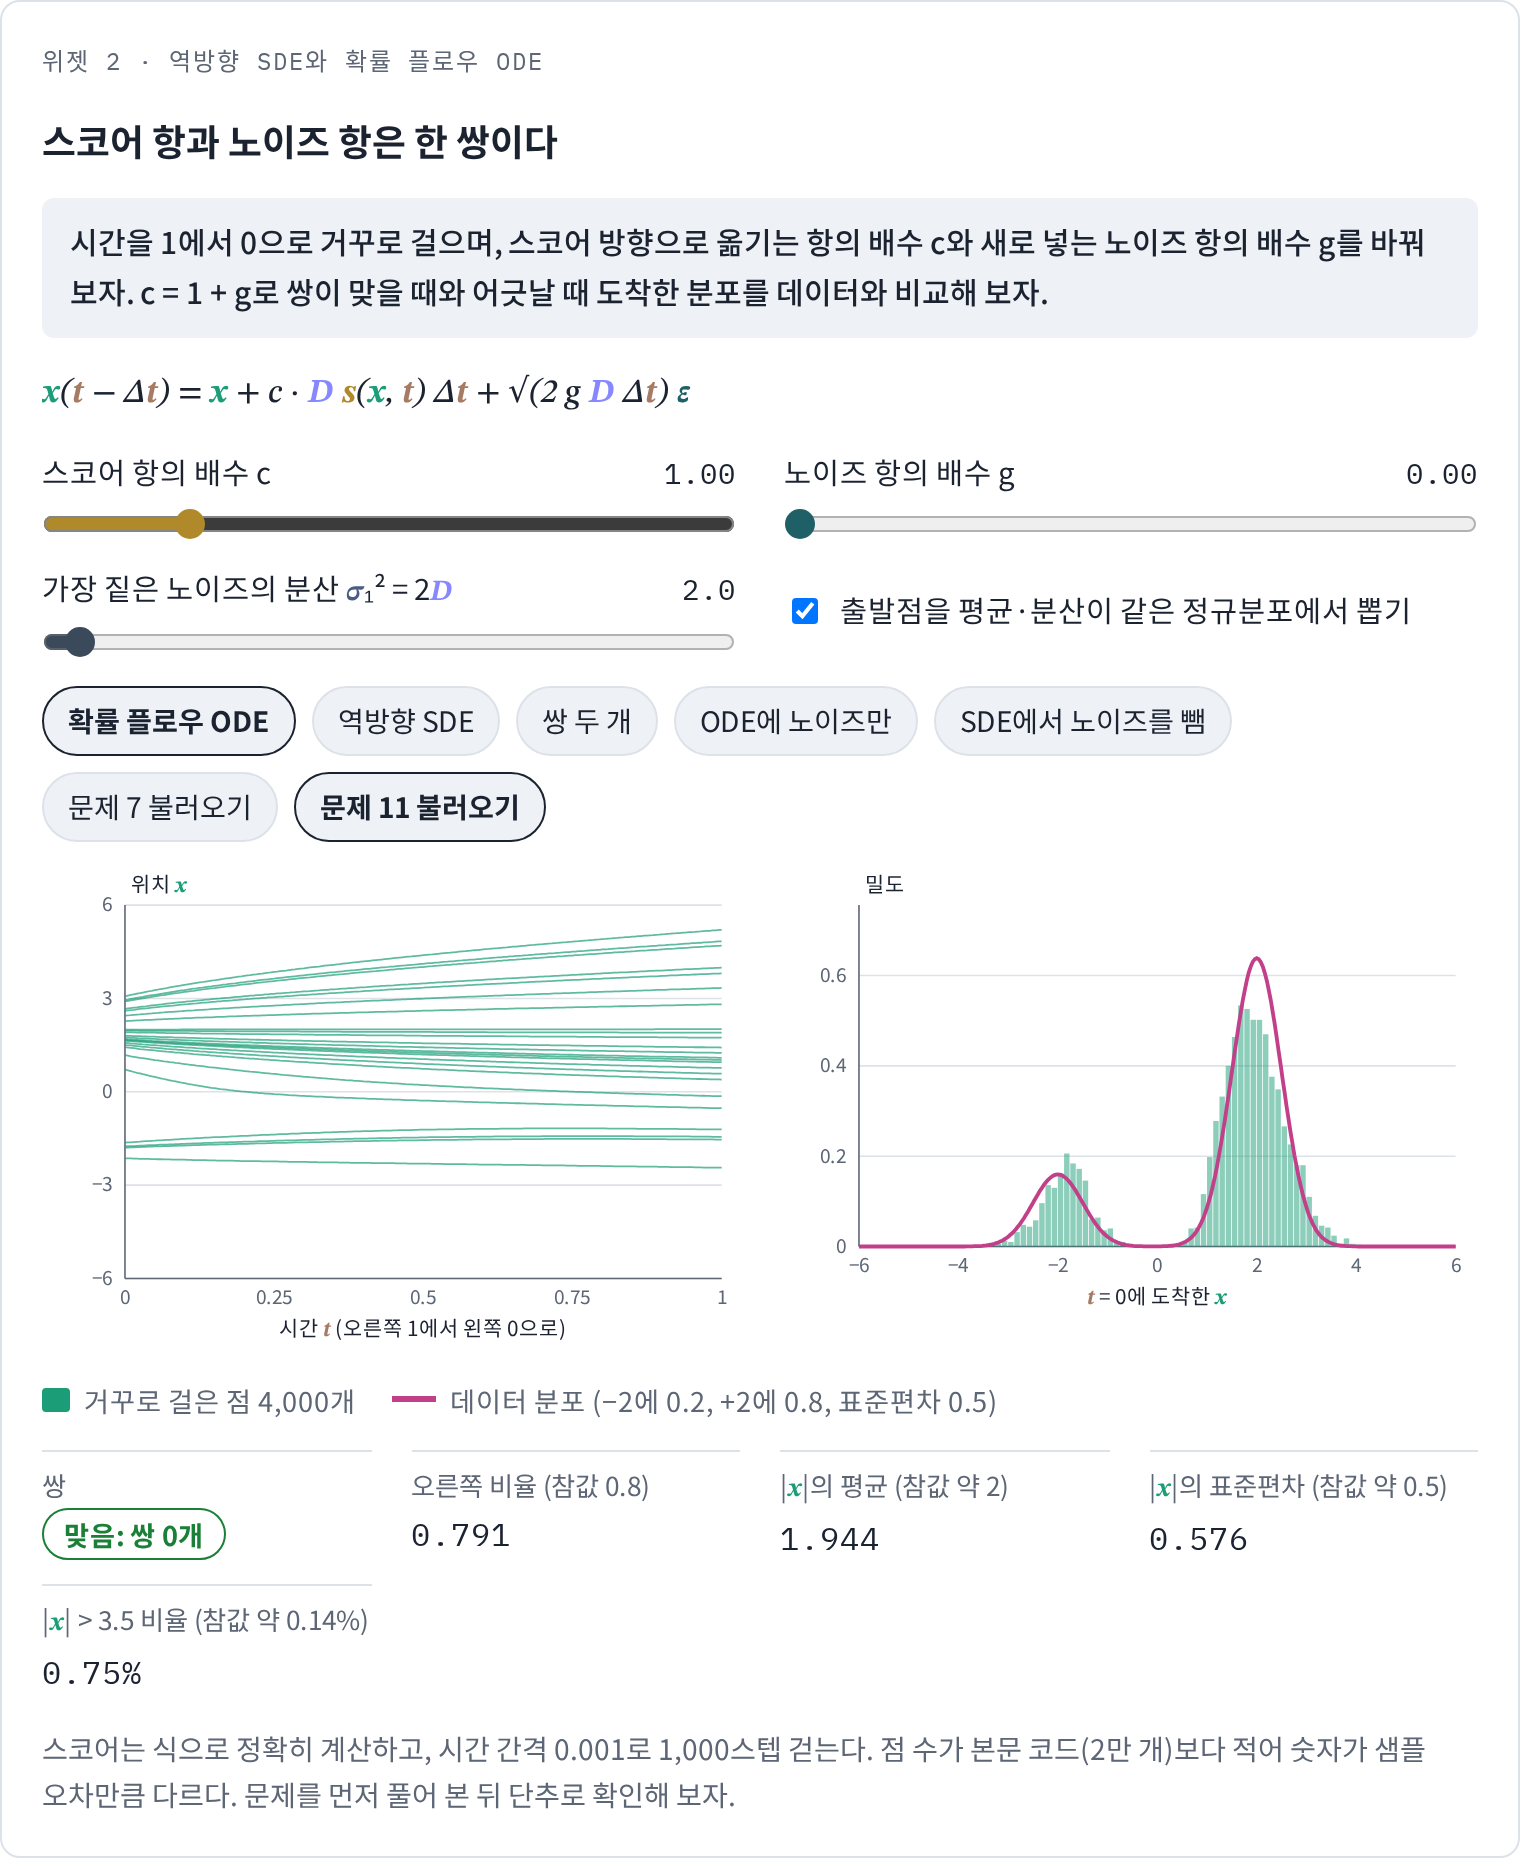
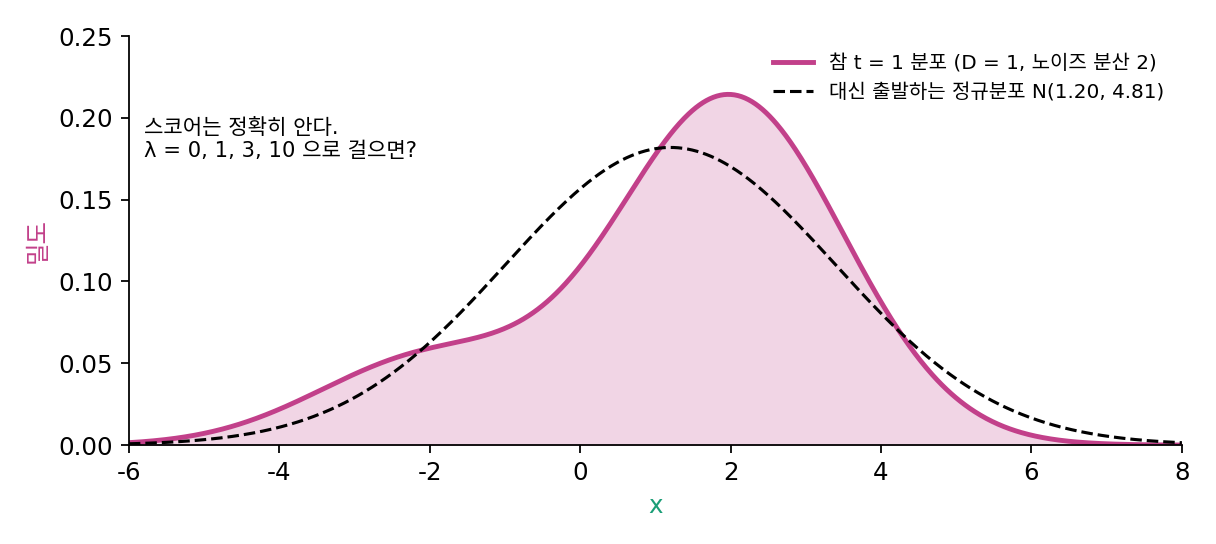
실제로는 t = 1의 분포를 정확히 모르니, 평균과 분산이 같은 정규분포에서 출발한다. 데이터는 −2(비중 0.2)와 +2(비중 0.8), 폭 0.5이고, 이번에는 노이즈를 옅게 섞어 t = 1의 노이즈 분산이 2다(D = 1). 이 분포는 아직 두 봉우리 형태가 남아 평균 1.20, 분산 4.81인 정규분포와 꽤 다르다. 스코어는 정확히 알고, 정규분포에서 뽑은 점 2만 개를 거꾸로 걷는다. (가) 확률 플로우 ODE(λ = 0)와 역방향 SDE(λ = 1)로 걸으면, |x|의 표준편차와 |x| > 3.5인 비율은 참값(0.499, 0.13%)과 얼마나 다른가? (나) 랑주뱅 쌍을 더 넣으면(λ = 3, 10)? (다) 그림을 뽑는 모델이 왜 스텝마다 노이즈를 다시 넣는지 (가), (나)의 결과로 설명하라. (풀어 본 뒤 위젯 2의 「문제 11 불러오기」로 ODE 경우를 확인해 보자.)
확률 플로우 ODE랑 역방향 SDE는 같은 분포를 지난다고 했으니까 결과도 같겠죠.
그 말은 어떤 조건에서 한 말이었죠?
출발 분포가 정확히 p₁일 때요. 지금은 정규분포에서 출발하니까 출발 분포가 p₁이라는 조건이 깨졌어요.
돌려 볼게요. ODE는 |x|의 표준편차 0.573, |x| > 3.5가 0.84%예요. 참값 0.13%의 여섯 배예요. SDE는 0.506과 0.19%로 훨씬 가까워요. λ = 3이면 0.498, 0.10%, λ = 10이어도 0.498, 0.10%예요.
정확한 p₁에서 출발하면 ODE도 0.498과 0.13%였어. 그러니까 ODE의 오차는 전부 출발점 탓이야.
왜 SDE는 출발점의 잘못을 덜 물려받을까요?
ODE는 출발점이 도착점을 정하니까, 출발 분포가 틀린 만큼 도착 분포도 그대로 틀려요. SDE는 스텝마다 그 시간의 pt를 정상 분포로 갖는 랑주뱅 스텝을 하나씩 얹은 거라, 걸을수록 점들이 pt 쪽으로 다시 섞여요. 틀린 출발을 잊는 거예요.
문제 6(자리 바꾸기)에서 많이 바꿀수록 처음 자리를 잊던 거랑 같네요! 그러면 (다)는, 실제 모델은 출발 분포도 조금 틀리고 신경망이 배운 스코어도 조금씩 틀리니까, 스텝마다 섞어서 출발 분포와 스코어의 오차가 쌓이지 않게 하려는 거예요.
그래요. 스코어가 정확하고 출발이 정확하면 노이즈는 넣어도 그만, 안 넣어도 그만이에요. 출발이나 스코어가 틀렸을 때 역방향 SDE는 그 오차를 잊고, 확률 플로우 ODE는 끝까지 기억해요. 대신 ODE는 같은 출발점이면 같은 그림이라는 지도를 얻고요. 어느 쪽을 고를지는 무엇이 더 필요하냐에 달렸어요.
수렴하는 반복법이 처음 값을 잊는 것과 비슷하네요. 반복할 때마다 오차가 줄어드니까요.
위젯 2에서 문제 11 설정을 불러와, 정규분포에서 출발한 ODE의 히스토그램이 참 분포와 어디서 차이가 나는지 보세요.