코드 속의 두 숫자: 스코어 배수와 새 노이즈를 짝으로
앞 절에서 주변 분포를 지키는 규칙이 한 가족이고, 가족을 선택하는 파라미터 λ가 「스코어 항의 배수」와 「새 노이즈의 크기」를 짝으로 움직인다는 것을 보았다. 실제 샘플러 코드에도 이 파라미터가 있을까? 있다면 코드의 어느 줄이고, 그 줄의 숫자를 고치면 무엇이 깨질까?
역사: 노이즈 레벨 열 개에서 연속인 시간으로
스탠퍼드 대학에서 스테파노 에르몬(Stefano Ermon)의 지도를 받던 박사과정 학생 양 송(Yang Song)은 2019년 에르몬과 함께 노이즈 레벨 열 개의 스코어를 배워 어닐드 랑주뱅으로 그림을 뽑는 방법을 냈다. 다음 해 두 사람은 개량판을 냈고, 같은 2020년 6월 호(Jonathan Ho)와 동료들의 DDPM이 나왔다. 송은 뒤에 쓴 글(2021년 5월 블로그)에서 여러 크기의 노이즈를 섞는 생각은 스코어 기반 모델만의 것이 아니고, 그 가운데 2015년 졸-딕스타인과 동료들의 디퓨전 확률 모델이 가장 가깝다고 적었다.
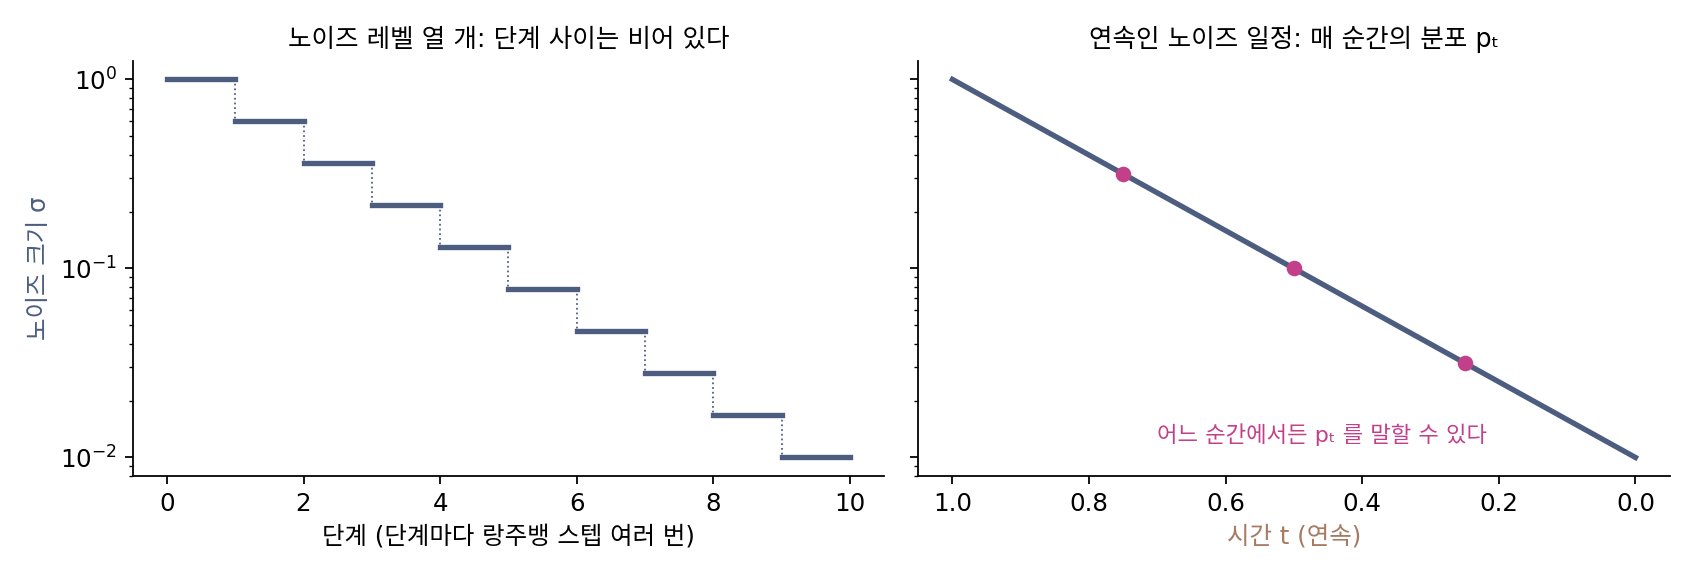
2020년 11월 26일, 송은 졸-딕스타인, 킹마(Diederik P. Kingma), 쿠마르(Abhishek Kumar), 에르몬, 풀(Ben Poole)과 함께 「확률 미분방정식을 통한 스코어 기반 생성 모델」을 arXiv에 올렸다. 블로그의 말로는 노이즈 레벨의 수를 무한으로 넓힌 것이다. 이산 단계 몇 개 대신 노이즈가 연속으로 쌓이는 SDE를 두자, 송·에르몬의 방법과 DDPM이 한 틀 안의 두 가지 노이즈 일정으로 들어갔다. 그런데 이 틀에서 그림을 뽑는 랑주뱅 샘플링이나 SDE 풀이로는 그림 한 장의 로그우도를 정확히 계산할 수 없었다. 초록은 이 SDE와 같은 분포에서 뽑는 동치인 신경망 ODE를 이끌어 냈고, 그것으로 정확한 우도 계산과 더 효율적인 샘플링이 가능해진다고 적었다. 이 ODE가 확률 플로우 ODE다. 블로그는 이 ODE를 SDE를 주변 분포를 바꾸지 않고 바꾼 것이라 설명했다. 이산화한 역방향 SDE가 걷다가 쌓는 오차를 바로잡으려고, SDE 한 스텝(예측) 뒤에 스코어로 걷는 교정 스텝을 덧붙이는 예측–교정 샘플러도 같은 논문에 있었다.
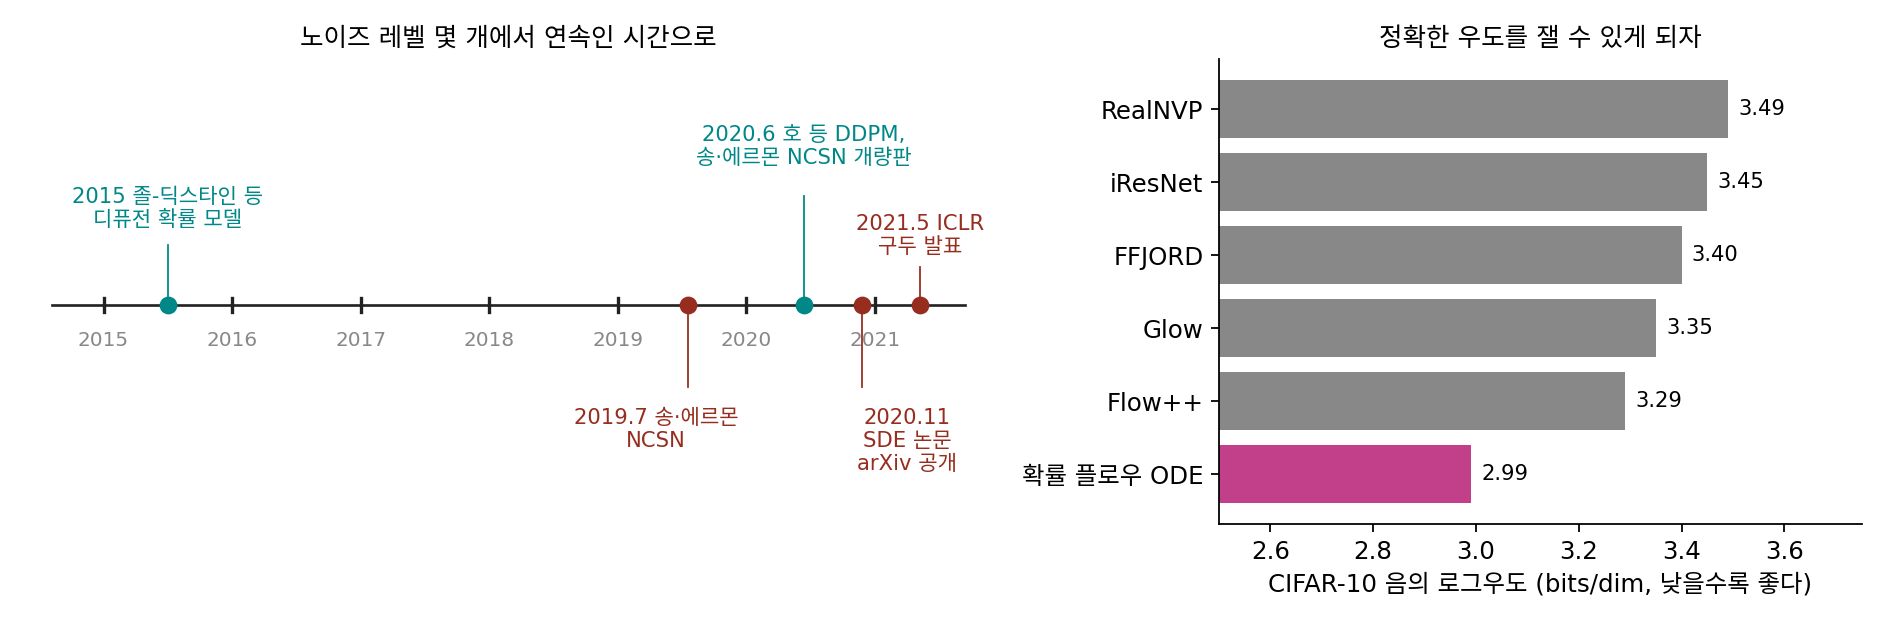
논문은 CIFAR-10 무조건 생성에서 FID 2.20, 인셉션 점수 9.89를 기록했고, 로그우도는 2.99 bits/dim이었으며, 스코어 기반 모델로는 처음으로 가로세로 1,024픽셀 그림을 높은 품질로 뽑았다. ICLR 2021에서 구두 발표로 뽑혔고, 저자들은 JAX 구현 score_sde와 PyTorch 구현 score_sde_pytorch를 함께 공개했다.
노이즈 레벨을 열 개에서 무한으로 늘린 게 그렇게 큰 일이었어요? 열 개면 그냥 촘촘히 늘리면 될 것 같은데요.
열 개일 때 확률 플로우 ODE를 적을 수 있었을까요?
음, 단계가 띄엄띄엄이면 단계 사이를 잇는 미분방정식이 없으니까… 시간이 연속이 되어야 「매 순간의 분포」를 말할 수 있고, 그래야 그 분포를 지키는 ODE를 적을 수 있겠네요.
그런데 우도를 계산하려고 ODE를 만들었다는 게 신기해요. 지금은 ODE를 빨리 뽑는 데 주로 쓰잖아요.
출발점과 그림이 하나씩 짝지어지니, 그림 한 장의 확률을 노이즈 쪽 확률에서 거슬러 계산할 수 있었던 거예요. 이제 그 논문의 코드에서 SDE와 ODE가 어디서 달라지는지 봐요.
코드: 플래그 하나와 두 개의 숫자
score_sde_pytorch 저장소(Apache-2.0)의 sde_lib.py는 순방향 SDE를 받아 역방향 SDE나 확률 플로우 ODE를 만드는 함수 reverse(score_fn, probability_flow)를 둔다. SDE와 ODE가 달라지는 곳은 두 줄이다.
drift = drift - diffusion[:, None, None, None] ** 2 * score * (0.5 if self.probability_flow else 1.)
# Set the diffusion function to zero for ODEs.
diffusion = 0. if self.probability_flow else diffusion
drift는 순방향의 끌림 f, diffusion은 노이즈 세기 g, score는 s다. 이 저장소는 시간을 앞으로 측정하는 형태로 적어서 역방향으로 걸을 때 dt가 음수이니, 이 장의 형태(Δt는 양수)로 옮기면 스텝은 x − fΔt + (배수) × g²sΔt + (새 노이즈 세기) × √Δt ε이다. 플래그가 켜지면 배수 0.5와 새 노이즈 0, 꺼지면 배수 1과 새 노이즈 g를 선택한다. 이 장의 기본 일정(f = 0, g² = 2D)에서 λ 쌍 규칙의 스코어 항 (1 + λ)DsΔt는 배수 (1 + λ)/2이고, 새 노이즈 √(2λDΔt)는 세기 √λ g다.
| 설정 | 스코어 항 배수 | 새 노이즈 세기 | λ |
|---|---|---|---|
probability_flow=True |
0.5 | 0 | 0 |
probability_flow=False |
1 | g | 1 |
| 일반 | (1 + λ)/2 | √λ g | λ |
플래그 하나가 두 숫자를 함께 바꾸는 이유가 앞 절의 짝이다. 0.5와 0은 「쌍 없음」, 1과 g는 「쌍 하나」를 선택하는 한 벌이라, 둘 가운데 하나만 바꿀 수는 없다. 두 봉우리 데이터에서 이 두 줄을 그대로 옮긴 numpy 코드로 2만 개를 2,000스텝 걸으면 플래그를 켠 쪽이 오른쪽 비율 0.797, |x|의 평균 1.998, 표준편차 0.500이고, 끈 쪽이 0.796, 1.998, 0.503이다.
def reverse_step(x, t, dt, lam, rng):
    g2 = 2 * D                                     # 기본 일정: f = 0, g² = 2D
    s = score(x, S2 + 2 * D * t)                   # 그 시간의 분포 pₜ 의 스코어
    mult = (1 + lam) / 2                           # probability_flow=True 는 0.5, False 는 1
    noise = np.sqrt(lam * g2 * dt) * rng.normal(size=x.shape)   # True 는 0, False 는 g√dt ε
    return x + mult * g2 * s * dt + noise
코드: 노이즈를 먼저 올리고 ODE로 내려오기
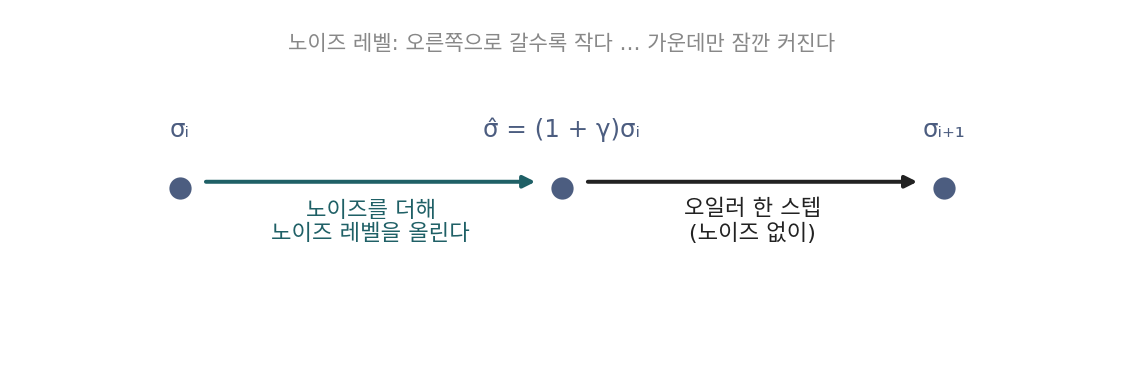
ComfyUI에 들어 있는 k-diffusion(캐서린 크로슨이 만든 샘플러 모음, MIT)의 sample_euler는 카라스(Tero Karras)와 동료들의 2022년 논문 알고리즘 2를 옮긴 것이라고 첫 줄에 적혀 있다. 노이즈 크기를 σ로 나타내는 이 코드는 노이즈 없는 오일러 스텝으로 확률 플로우 ODE를 푼다. 그런데 s_churn이라는 설정값을 0보다 크게 두면 스텝마다 이런 일을 먼저 한다.
gamma = min(s_churn / (len(sigmas) - 1), 2 ** 0.5 - 1) if s_tmin <= sigmas[i] <= s_tmax else 0.
sigma_hat = sigmas[i] * (gamma + 1)
...
x = x + eps * (sigma_hat ** 2 - sigmas[i] ** 2) ** 0.5
denoised = model(x, sigma_hat * s_in, **extra_args)
...
dt = sigmas[i + 1] - sigma_hat
x = x + d * dt
노이즈 레벨을 σᵢ에서 σ̂ = (1 + γ)σᵢ로 잠깐 올렸다가, 거기서 노이즈 없는 오일러 한 스텝으로 다음 레벨 σᵢ₊₁까지 내려온다. 올리는 반쪽은 분산 σ̂² − σᵢ²인 노이즈를 새로 더하는 일이다. 노이즈 레벨 σ의 분포는 데이터에 분산 σ²인 노이즈를 섞은 것이니, 거기에 서로 상관없는 노이즈를 더 섞으면 분산이 더해져 σ̂의 분포가 정확히 나온다. 순방향 과정을 한 토막 다시 밟은 셈이고, 이 반쪽은 주변 분포를 하나도 어기지 않는다. 내려오는 반쪽은 확률 플로우 ODE라 역시 주변 분포를 지킨다. 두 반쪽이 다 주변 분포를 지키니 처닝을 얹어도 같은 분포에 닿아야 하고, 그 사이에 점들은 새 노이즈로 섞인다. 스코어 항의 배수와 새 노이즈를 한 줄에 함께 적는 대신, 노이즈를 먼저 넣고 그 노이즈를 걷어 내는 ODE를 나중에 밟는 형태로 짝을 맞춘 것이다.
ML에서: 샘플러 목록의 「sde」와 「ancestral」
ComfyUI의 샘플러 목록에는 euler 옆에 euler_ancestral이, dpmpp_2m 옆에 dpmpp_2m_sde가 있다. 이름 끝에 ancestral이나 sde가 붙은 것은 스텝마다 새 노이즈를 넣어 λ > 0 쪽 가족을 걷는 판이다. 같은 모델 파일을 그대로 쓰는데 샘플러 이름만 바꿔 선택할 수 있는 것은, 모델이 배운 것이 시각마다의 주변 분포의 스코어뿐이기 때문이다. 같은 시드에서 그림의 구도가 달라지는 것은 길의 결합 분포가 달라서이고, 그림들이 퍼진 분포는 스코어가 정확하다면 같다.
문제 14. 배수만 고친 커밋
누군가
score_sde_pytorch의reverse안 두 줄을 아래처럼 고쳐 커밋하면서 「ODE와 SDE의 중간쯤으로 걸으려고」라는 메시지를 달았다. 데이터는 −2(비중 0.2)와 +2(비중 0.8), 폭 0.5, D = 4다. (가) 스코어 항 배수 0.75는 λ가 얼마일 때의 배수인가? (나) 그 λ에 맞는 새 노이즈 세기는 g의 몇 배인가? (다) 고친 코드(새 노이즈 0.5g)로 걸으면 결과는 참값(오른쪽 비율 0.800, |x|의 표준편차 0.5)과 비교해 어떻게 되는가?
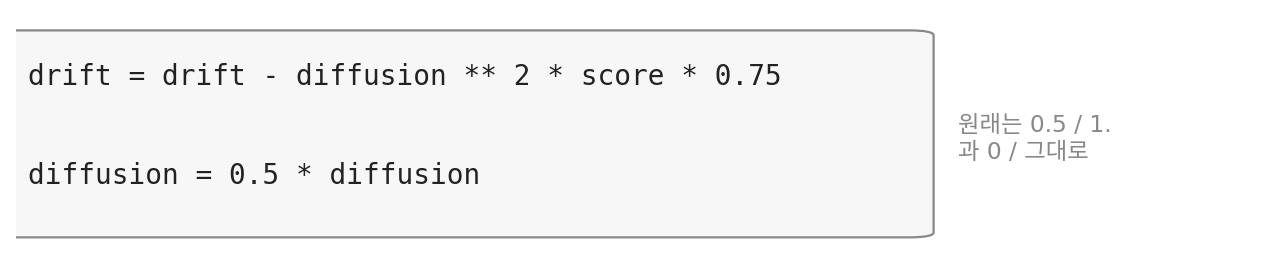
(가)는 배수가 (1 + λ)/2니까 0.75면 λ = 0.5야.
(나)는 새 노이즈 세기가 √λ g니까 √0.5 = 0.707배. 커밋은 0.5배라 짝보다 작아.
둘 다 「중간」이라 0.75와 0.5로 조정한 것 같은데, 돌려 볼게. 고친 그대로면 오른쪽 비율 0.823, |x| 평균 1.974, 표준편차 0.401이야. 봉우리가 좁아지고 큰 봉우리 쪽으로 더 몰렸어.
새 노이즈를 0.707g로 고치면요? 그리고 배수 0.75에 노이즈를 g 그대로 두면요?
0.707g면 0.797, 1.997, 0.500으로 참값이에요. g 그대로면 0.756, 2.048, 0.649로 거꾸로 넓어지고요.
배수의 「중간」과 노이즈 세기의 「중간」이 같은 비율이 아니구나. 배수는 λ에 대해 직선이고 노이즈 세기는 제곱근이라, 0.5배는 λ = 0.25의 노이즈야. 끌림은 λ = 0.5인데 노이즈는 0.25만큼이니 덜 퍼뜨려서 좁아진 거고.
볶음밥 레시피를 반으로 줄이면서 밥은 반만 넣고 간장은 그대로 넣은 거네. 같이 줄여야 하는 걸 하나만 줄였어.
문제 15. 처닝을 넣었더니 (킬러)
위 두 봉우리 데이터를 k-diffusion 식 오일러 샘플러로 뽑는다. 노이즈 레벨은 카라스 일정(로 7)으로 50스텝이다. (가)
s_churn = 10이면 스텝마다 γ는 얼마이고, σ̂는 σᵢ의 몇 배인가? (나) 결과가 오른쪽 비율 0.813, |x|의 표준편차 0.470으로 참값(0.800, 0.5)에서 벗어났다. 노이즈를 더하는 반쪽도, ODE로 내려오는 반쪽도 주변 분포를 지킨다면 오차는 어디서 왔는가? (다) 코드는 γ를 √2 − 1 아래로 묶는다. γ가 그 상한일 때 한 스텝에 더하는 노이즈의 분산은 이미 들어 있던 노이즈 분산의 몇 배인가?
(가)는 γ = 10 ÷ 50 = 0.2라서 σ̂ = 1.2σᵢ야.
(나)는 처닝 노이즈가 문제 같아. 노이즈를 더 넣었으니 그만큼 분포가 흐트러진 거지.
노이즈를 더한 직후의 점들은 어떤 분포에 놓여 있어요?
레벨 σᵢ의 분포에 분산 σ̂² − σᵢ²을 더 섞었으니까 정확히 σ̂의 분포예요. 거기선 오차가 없네요. 그럼 내려오는 쪽인데…
오일러 한 스텝이 σ̂에서 σᵢ₊₁까지 가야 하니까, 처닝이 없을 때보다 스텝 크기가 커. 50스텝이면 원래도 스텝 크기가 큰데, 그걸 더 키운 거야. ODE는 정확히 풀면 주변 분포를 지키지만 오일러 한 스텝은 근사라서, 스텝 크기가 클수록 그 근사 오차가 커지지.
확인해 볼게. s_churn = 10을 그대로 두고 스텝만 늘리면 200스텝에서 0.803과 0.495, 800스텝에서 0.800과 0.498이야. 스텝이 늘면 γ = 10/스텝 수라 한 스텝의 처닝도 작아지고, 스텝 크기도 작아져서 참값으로 돌아와. 그런데 출발과 도착의 상관은 800스텝에서도 0.254라, 처닝 없을 때의 0.888보다 훨씬 낮아.
분포는 돌아왔는데 상관은 돌아오지 않았네요. 무엇이 남은 거예요?
길의 결합 분포요. s_churn 은 스텝 전체에 넣는 노이즈의 총량이라, 잘게 나눠도 섞이는 정도는 그대로 남아요. 주변 분포는 그대로고 길만 바뀌는, 앞 절의 λ와 같은 역할이에요.
(다)는 γ = √2 − 1이면 σ̂ = √2 σᵢ라서, 더하는 분산이 2σᵢ² − σᵢ² = σᵢ²야. 이미 들어 있던 노이즈와 같은 양까지만 더하게 막아 둔 거네.
그래요. 상한까지 올리면 한 스텝에 노이즈를 두 배로 만들었다가 걷어 내는 셈이라, 내려오는 오일러 스텝의 크기가 그만큼 커져요. 50스텝에서 s_churn = 40으로 상한에 닿게 하면 오른쪽 비율이 0.821로 더 벗어나고요. 처닝은 분포를 지키는 설정이지만, 그 약속은 스텝 크기가 충분히 작을 때만 지켜져요.