GPT 한 벌: 층을 쌓고 파라미터를 세기
마스크를 씌운 셀프 어텐션 하나로는 모델이 되지 않는다. 어텐션은 앞 토큰들의 값을 비중대로 섞어 가져올 뿐이라서, 가져온 것을 토큰 안에서 곱씹어 새 특징으로 바꾸는 계산이 따로 있어야 한다. 그 계산을 맡는 MLP 를 어텐션과 묶어 층 하나로 만들고 층을 여러 번 쌓는데, 쌓을 때 무엇이 필요한지도 이미 배웠다.
역사: 번역기의 반쪽으로 언어 모델을 만들다
바스와니와 동료들의 2017년 트랜스포머는 원문을 읽는 인코더와 번역문을 쓰는 디코더를 한 쌍으로 둔 번역기였다. 이듬해 OpenAI 의 래드퍼드(Alec Radford)와 동료들은 「Improving Language Understanding by Generative Pre-Training」(2018)에서 인코더를 떼어 내고 디코더만 남겼다. 논문은 이 모델을 「가려진 셀프 어텐션 헤드를 쓰는 12층 디코더 전용 트랜스포머(폭 768, 헤드 12)」라고 적었고, 문맥은 512 토큰, 위치 정보는 원래 논문의 사인 형태 대신 학습하는 위치 임베딩, 활성화 함수는 GELU 였다. 나중에 GPT-1 이라 불리게 된 모델이다.
이 논문에서 우리 장에 가장 가까운 대목은 데이터를 고른 이유다. 저자들은 출판되지 않은 책 7,000권 정도를 모은 BooksCorpus 로 학습했는데, 「이어진 긴 글이 들어 있어 생성 모델이 먼 앞의 정보에 기대는 법을 배울 수 있다」는 것이 이유였다. 크기가 비슷한 다른 데이터(1B Word Benchmark)는 문장 단위로 섞여 있어 「먼 거리의 구조가 부서진다」고 적었다. 먼 앞을 보는 모델을 만들었으면, 먼 앞이 쓸모 있는 글도 함께 골라야 했던 것이다.
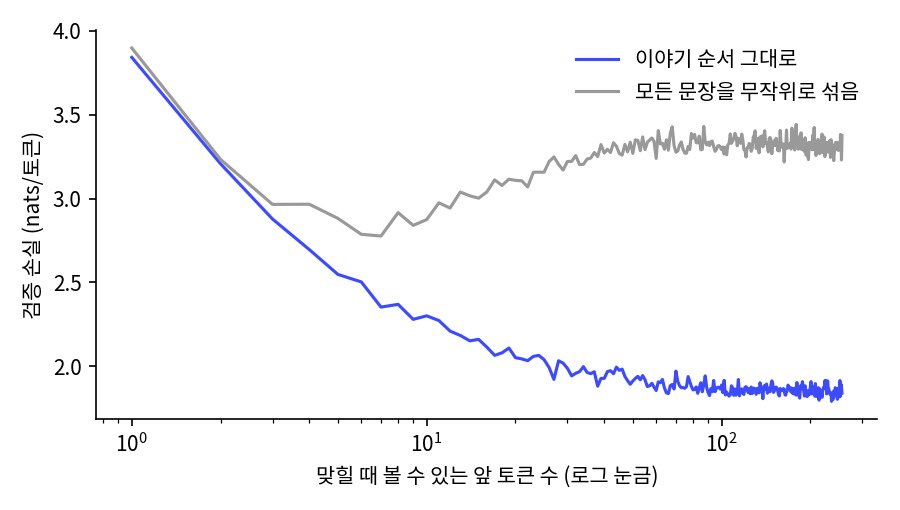
섞은 글에서는 앞 문장이 지금 문장과 상관없으니, 먼 앞을 읽을수록 오히려 엉뚱한 단서를 얻는다. 그런 글로만 학습했다면 모델은 먼 앞을 쓰는 법을 배울 거리 자체가 없었을 것이다.
이듬해 래드퍼드와 동료들은 「Language Models are Unsupervised Multitask Learners」(2019)에서 디코더만 쌓는 같은 구조를 크게 키운 GPT-2 를 냈다. 레딧에서 카르마(추천 점수)를 3 이상 받은 바깥 링크 4,500만 개를 따라가 모은 웹 글 WebText(중복을 걷어 낸 문서 800만 개 정도, 40GB)로 학습했고, 문맥을 1,024 토큰으로 늘렸으며, 가장 큰 모델은 48층, 폭 1,600, 파라미터 15억 개였다. 층 정규화를 하위 블록의 입력 쪽으로 옮기고, 잔차로 들어가는 층의 가중치를 처음에 1/√N(N 은 잔차 층의 수)만큼 줄여 두었다. 논문은 이 크기에서도 모델이 WebText 를 아직 「덜 배웠다」고 적었다.
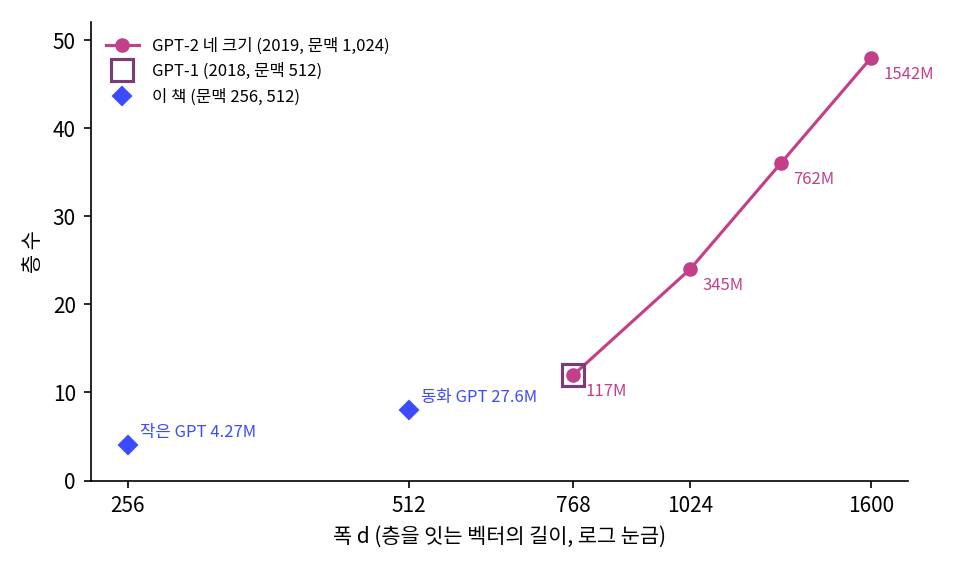
우리 GPT 는 GPT-2 의 형태를 거의 그대로 줄였다. 학습하는 위치 임베딩, 입력 쪽 층 정규화, 폭 4배의 GELU MLP, 잔차 투영의 초기화 축소가 모두 들어 있고, 옵티마이저는 AdamW 다. 우리 모델의 폭 256, 4층은 GPT-2 의 가장 작은 판보다 폭은 1/3, 층은 1/3 이다.
층 하나와 모델 전체
sources/common/gpt.py 는 전체 176 줄이고 빈 줄과 주석 줄을 빼면 146 줄인데, 층 하나와 모델의 앞으로 가는 계산은 다음이 전부다.
# sources/common/gpt.py 에서 발췌
class Block(nn.Module):
    def forward(self, h, cache=None):
        h = h + self.attn(self.ln_1(h), cache)   # 정규화 → 어텐션 → 더하기
        h = h + self.mlp(self.ln_2(h))           # 정규화 → MLP(d → 4d → d, GELU) → 더하기
        return h

class GPT(nn.Module):
    def forward(self, idx, targets=None, ...):
        pos = torch.arange(pos0, pos0 + T, device=idx.device)
        h = self.wte(idx) + self.wpe(pos)        # 토큰 임베딩 + 위치 임베딩
        for blk in self.blocks:
            h = blk(h)
        logits = self.lm_head(self.ln_f(h))      # 마지막 정규화 → 어휘 4,096 개의 점수
        ...
# __init__ 에서: self.lm_head.weight = self.wte.weight   (입력·출력 임베딩 공유)
층마다 h = h + … 형태로 계산한 것을 더하기만 하는 연결을 잔차 연결 (입력을 그대로 넘기고 계산한 만큼 더하는 연결 / residual connection)이라 부른다. 토큰 임베딩에서 시작한 벡터 h 는 층을 지날 때마다 무언가가 더해져 마지막 층까지 이어지는데, 층들이 이 벡터를 어떻게 나눠 쓰는지는 모델 속을 들여다볼 때 자세히 본다.
마지막 줄의 lm_head.weight = self.wte.weight 는 토큰을 벡터로 바꾸는 표(토큰 임베딩)와 벡터를 어휘의 점수로 바꾸는 행렬을 같은 행렬로 쓰라는 뜻이다. 들어오는 토큰과 나가는 토큰이 같은 어휘이니 같은 표를 앞뒤로 쓰는 것이고, GPT-2 도 그렇게 했다.
파라미터를 임베딩·어텐션·MLP·정규화로 나눠 세면 다음과 같다(sources/gpt/train_gpt_small.out 1절).
## 1. 파라미터 4,273,664 개 (설정 GPTConfig(vocab_size=4096, block_size=256, n_layer=4, n_head=4, n_embd=256, mlp=True))
  토큰 임베딩 wte (출력과 공유)                   1,048,576
  위치 임베딩 wpe                               65,536
  층 하나의 어텐션 (Q,K,V + 출력 투영)               263,168
  층 하나의 MLP (d -> 4d -> d)                525,568
  층 하나의 LayerNorm 둘                         1,024
  마지막 LayerNorm                               512
  층 하나 합계 789,760 (= 12 d² + 13 d = 789,760), 층 4 개 3,159,040
층 하나의 수는 폭 d 만으로 정해진다. 어텐션은 쿼리·키·값을 한꺼번에 만드는 d × 3d 행렬과 출력 투영 d × d 로 가중치가 4d², MLP 는 d × 4d 와 4d × d 로 8d² 다. 바이어스(어텐션 4d, MLP 5d)와 층 정규화 둘(4d)을 더하면 다음 식이 된다.
층 넷이 3,159,040 개로 전체의 74% 를 차지하고, 공유한 토큰 임베딩이 1,048,576 개로 24.5% 다. MLP 언어 모델은 파라미터의 82% 가 출력층에 있었는데, GPT 는 같은 출력층을 입력 표와 나눠 쓰고 그 대신 층에 파라미터를 쓴다.
ML에서: 「200줄 GPT」라는 말
이 형태의 GPT 를 짧은 코드로 다시 짜 보이는 것은 이제 언어 모델을 배우는 사람들의 관례가 되었다. 카파시의 nanoGPT 와, 이 책이 따라가는 nanochat 의 모델 파일도 수백 줄이다. 우리 파일은 146 줄이니 「200줄이 안 되는 GPT」라고 부르는 편이 맞다. 크기를 키울 때 바뀌는 것은 GPTConfig 의 숫자 다섯 개(어휘 크기, 문맥 길이, 층 수, 헤드 수, 폭)뿐이고, 클래스 코드는 한 줄도 고치지 않는다.
문제 3. 동화 GPT 의 파라미터를 미리 세기
다음에는 같은 코드로 어휘 4,096, 문맥 512, 8층, 층마다 헤드 8 개, 폭 512 인 GPT 를 학습할 예정이다. 입력·출력 임베딩을 공유한다고 할 때, 학습을 돌리기 전에 파라미터 수를 세어라.

층 하나부터 할게. 12d² + 13d 에 d = 512 를 넣으면 3,145,728 + 6,656 = 3,152,384 개. 그런데 12d² + 13d 는 헤드 4 개짜리 모델에서 센 거잖아. 헤드가 8 개로 두 배니까 어텐션 가중치 4d² 는 두 배로 쳐야 할 것 같아.

잠깐, 코드부터 볼게. c_attn 은 nn.Linear(cfg.n_embd, 3 * cfg.n_embd) 하나라서 헤드 수가 아예 안 들어가. 만든 다음에 view(B, T, self.n_head, hd) 로 잘라 쓸 뿐이야.
아, 폭 512 를 헤드 8 개가 64 씩 나눠 쓰는 거구나. 헤드를 늘리면 헤드 하나가 좁아질 뿐이고, 행렬 크기는 그대로네. 그럼 두 배로 칠 필요 없이 층 여덟 개가 25,219,072 개야.

층 말고 남은 것도 세어 볼까요?
마지막 층 정규화 2 × 512 = 1,024 개, 토큰 임베딩 4,096 × 512 = 2,097,152 개, 위치 임베딩은 문맥이 512 라서 512 × 512 = 262,144 개요. 다 더하면 27,579,392 개예요.
학습을 돌리면 스크립트가 센 값과 비교해 봐요. 맞으면 모델을 생각한 대로 만든 거예요. 헤드 수는 쿼리·키·값을 몇 조각으로 나눌지만 정하고, 파라미터 수는 폭과 층 수가 정해요.
문제 4. 입력과 출력의 임베딩을 따로 두면
lm_head.weight = self.wte.weight줄을 지워 출력 행렬을 따로 학습하게 하면, (가) 작은 GPT(어휘 4,096, 폭 256)의 파라미터는 몇 개가 되고 몇 % 늘어나는가? (나) 문제 3 의 동화 GPT 는? (다) 어휘 50,257, 폭 768 인 GPT-2 의 가장 작은 판에서는 출력 행렬 하나가 몇 개인가?
(가)는 출력 행렬 4,096 × 256 = 1,048,576 개가 더 생기니까 5,322,240 개, 24.5% 늘어요.
(나)는 4,096 × 512 = 2,097,152 개가 더해져서 29,676,544 개, 7.6% 요. 모델이 클수록 비율이 작아지네.
왜 작아질까요?
임베딩은 어휘 × 폭이라 폭에 비례하는데, 층은 폭의 제곱에 비례하잖아요. 폭이 두 배가 되면 층은 네 배로 커져서 임베딩의 비중이 줄어요.

그런데 (다)는 어휘가 50,257 이니까 50,257 × 768 = 38,597,376 개야. 1억 1,700만 개 가운데 3,800만이면 작지 않은데.
둘 다 맞게 봤어요. 비율은 폭과 어휘 크기가 함께 정해요. 어휘가 클수록 공유로 아끼는 양이 커서, GPT-2 같은 크기에서는 공유가 파라미터의 3분의 1 가까이를 아껴 줬어요. 이 책이 따라가는 nanochat 은 출력 행렬을 따로 두는데, 그 비교도 모델을 키운 뒤에 다시 만나요.