MLP 와 같은 조건으로: 바이트당 비트 0.6129
GPT 가 좋다는 말은 많이 들었지만, 우리 데이터에서 얼마나 좋은지는 같은 조건으로 학습해 봐야 안다. 조건이 다르면 차이가 모델에서 왔는지 학습량에서 왔는지 가를 수 없다. 그래서 MLP 언어 모델과 같은 토크나이저(BPE 4,096), 같은 4,000 스텝, 같은 스텝당 16,384 토큰으로 학습하고, 같은 검증 글 전체에서 바이트당 비트를 잰다. 학습률만 GPT 에 흔히 쓰는 2e-3 으로 두었다.
# sources/gpt/train_gpt_small.py 에서 발췌
cfg = GPTConfig(vocab_size=tok.vocab_size, block_size=256, n_layer=4, n_head=4, n_embd=256)
m = GPT(cfg).to(dev)
h = T.train(m, tr, va, tb, batch_size=64, block_size=256, max_steps=4000, lr=2e-3, warmup=100,
            grad_clip=1.0, eval_every=250, log_every=250, device=dev, eval_tokens=2_000_000)
full = T.evaluate(m, va, tb, 64, 256, len(va), dev)
## 3. 학습: 4,000 스텝, 배치 64 x 256 토큰, 학습률 2e-3 (예열 100 스텝 + 코사인), 그래디언트 자르기 1.0
eval step      0 | tokens 0 | val_loss 8.3832 | val_bpb 3.0421 | 0s
eval step    500 | tokens 8,192,000 | val_loss 2.4512 | val_bpb 0.8928 | 11s
eval step   1000 | tokens 16,384,000 | val_loss 2.1310 | val_bpb 0.7756 | 22s
eval step   2000 | tokens 32,768,000 | val_loss 1.8828 | val_bpb 0.6853 | 47s
eval step   3000 | tokens 49,152,000 | val_loss 1.7505 | val_bpb 0.6373 | 73s
eval step   4000 | tokens 65,536,000 | val_loss 1.6862 | val_bpb 0.6140 | 100s
검증 글 전체: 손실 1.6838, 바이트당 비트 0.6129, 학습 100초
같은 조건의 MLP 언어 모델(앞 6 토큰): 바이트당 비트 0.9326
학습 기록은 250 스텝마다 찍히는데 여기에는 500 스텝마다만 옮겼다. RTX 4090 한 장에서 100초 만에 바이트당 비트가 0.6129 가 되었다. MLP 의 0.9326 보다 바이트마다 0.32 비트를 덜 쓰니, 같은 검증 글을 적는 데 드는 비트가 2/3 쯤으로 줄었다. 학습한 토큰은 6,553만 개로 학습 글 5억 5,265만 토큰의 12% 가 조금 못 된다.
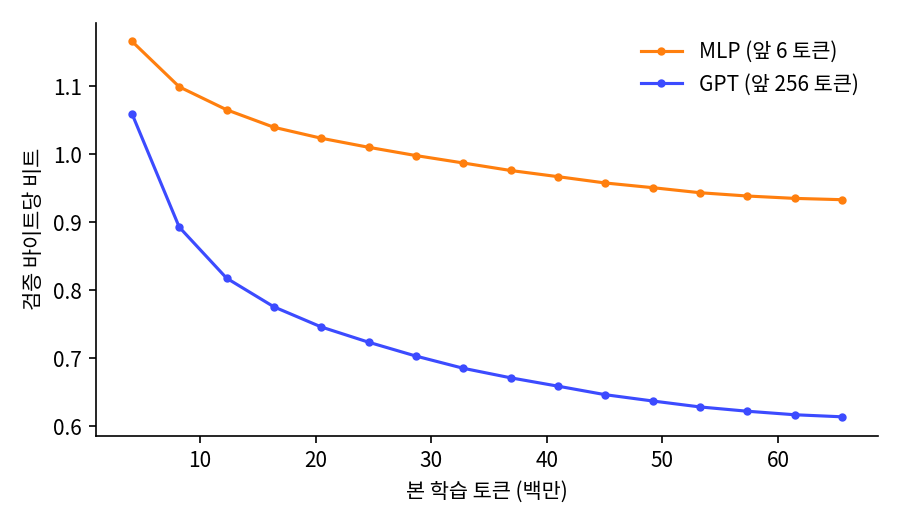
GPT 가 학습한 지 410만 토큰째(250 스텝)에 이미 1.0597 로, MLP 가 6,553만 토큰을 다 본 뒤의 0.9326 과 크게 다르지 않다. 그러면 GPT 가 앞서는 부분은 이야기의 어디에서 생길까? 학습한 두 모델을 검증 글 앞 200만 토큰에 걸고, 256 토큰 조각 안의 위치마다 손실을 따로 평균했다(sources/gpt/position_and_mask.py).
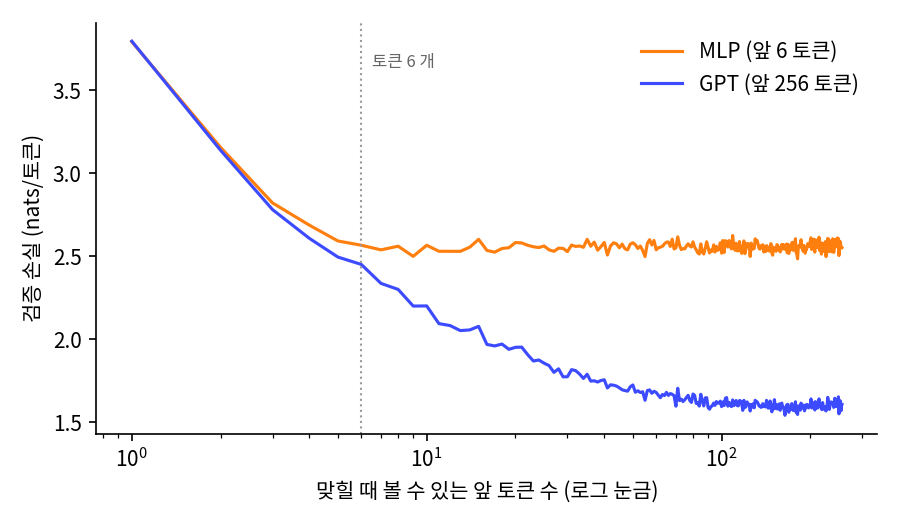
## 1. 위치마다의 검증 손실 (nats/토큰, 검증 글 앞 1,999,872 토큰, 256 토큰 조각 7,812 개)
  위치는 0부터 센다. 위치 t 는 앞 토큰 t+1 개를 보고 다음 토큰을 맞힌다.
      위치      MLP      GPT
       0   3.7939   3.7971
       5   2.5671   2.4513
      15   2.5358   1.9691
      63   2.5748   1.6605
     255   2.5521   1.6073
  위치 0~5 평균: MLP 2.9368, GPT 2.8790
  위치 6~31 평균: MLP 2.5501, GPT 1.9728
  위치 32~127 평균: MLP 2.5584, GPT 1.6503
  위치 128~255 평균: MLP 2.5593, GPT 1.5991
  전체 평균: MLP 2.5669, GPT 1.6862
출력에서 위치 몇 줄을 줄였다. 볼 수 있는 토큰이 하나뿐인 위치 0 에서는 바로 앞 토큰 하나로 할 수 있는 일이 어느 모델이나 같아서, 두 모델의 손실이 3.79 로 같다. MLP 의 손실은 앞 여섯 토큰을 다 채운 뒤로 2.55 근처에서 더 내려가지 않는데, GPT 는 앞 16 토큰에서 1.97, 앞 64 토큰에서 1.66 까지 내려간 뒤 100 토큰쯤부터 1.6 정도에서 평평해진다. 문맥은 256 토큰까지 보이지만, 이 작은 모델이 손실을 줄이는 데 쓰는 문맥은 앞 100 토큰쯤까지다.
샘플: 이야기는 이어지지만
같은 모델에 「Once upon a time」을 주고 온도 1.0 으로 이어 쓰게 했다.
[1] Once upon a time, there was a little bunny named Bobo. Bobo was very bossy. He could not dance back. He loved animals, but he did not like to clean. One day, Bobo went on a hop and played. He hopped and hopped, but he was not the boss.\nAs Bobo hopped, he saw a very big dog. The dog was not listening. The dog wanted to play. Bobo tried to be brave, but the dog said, "No, Bobo! You cannot play trick on me!" Bobo did not like Max thinking. He wanted to stay away from the dog.\n
[2] Once upon a time, in a big forest, there lived a bunny named Bounce. Bounce loved to play with his friend, Bounce. One day, Bounce and Bounce were playing a game called "match".\n"Let's play!" said Bounce to Bounce. They played and laughed all day long. Bounce liked to chase the big, safe place to sleep.\nOne day, Bounce and Bounce had a party. They played a big cake, pie, and ate it together. Bounce was very good at
첫 샘플에서 Bobo 는 처음부터 끝까지 Bobo 다. 학습 데이터에 없는 이름일 텐데도 첫 문장에서 지은 이름을 여러 문장 뒤까지 다시 쓰고, 「hop」을 꺼낸 뒤로는 토끼답게 「hopped」가 이어진다. 두 번째 샘플은 이름을 지나치게 잘 이어 써서, 토끼 Bounce 의 친구도 Bounce 이고 둘이 함께 파티를 연다.
Bounce 의 친구 Bounce. 앞에 나온 이름이 하나뿐이니 그걸 또 쓴 거네.
그래도 일곱 토큰 만에 루나를 잊던 때보다는 낫잖아. 이번엔 끝까지 Bounce 야.
문제 5. 차이는 어느 위치에서 왔나
위치마다의 손실 표에서 두 모델의 전체 평균 차이는 2.5669 − 1.6862 = 0.8807 nat 이다. 0.8807 nat 가운데 위치 32~255 에서 온 부분은 몇 % 인가? 그리고 두 모델이 같은 토큰들을 보는 위치 0~5 에서도 GPT 가 0.058 nat 낮은 것은 왜일까?

구간마다 「차이 × 구간 길이 / 256」을 더하면 되겠다. 0~5 는 0.0578 × 6 / 256 = 0.0014, 6~31 은 0.5773 × 26 / 256 = 0.0586, 32~127 은 0.9081 × 96 / 256 = 0.3405, 128~255 는 0.9602 × 128 / 256 = 0.4801. 다 더하면 0.8806 이라 반올림까지 맞아.

그럼 위치 32 부터가 0.3405 + 0.4801 = 0.8206, 전체의 93% 네. 차이 대부분이 앞 32 토큰 넘게 볼 수 있는 자리에서 나왔어.

두 번째 물음은요? 위치 0~5 에서는 둘이 보는 것이 같은데도 GPT 가 조금 낮아요.

보는 게 같으면 같은 확률을 낼 수 있어야 하는데요. 모델이 다르니까 같은 문맥을 더 잘 쓰는 걸까요?
GPT 는 층이 넷이고 MLP 는 은닉층이 하나잖아. 같은 여섯 토큰이라도 곱씹는 계산이 더 깊어.
하나 더 있어요. 조각을 검증 글에서 잘랐으니, 위치 0 의 토큰도 실제로는 이야기 한가운데에 있을 수 있어요. 위치 0 의 모델이 「앞에 무엇이 있었을지」를 아는 방법이 있을까요?
없죠. 앞을 못 보니까요. 그럼 위치 0~5 의 작은 차이는 순전히 같은 문맥을 다루는 솜씨 차이고, 큰 차이는 볼 수 있는 문맥의 길이 차이네요.
그래요. 둘을 섞지 않고 나눠 볼 수 있었던 건 위치마다 쟀기 때문이에요. 평균 하나만 봤으면 「GPT 가 0.88 nat 낫다」로 끝났겠죠.