루나에게 말 걸기: 같은 시작 문장에 왜 매번 다른 이야기가 나올까
온도: 확률표를 펴고 오므리기
서연이 말한 「온도」는 대화형 모델의 설정 화면에서 흔히 보는 그 설정으로, 온도를 0으로 내리면 그리디 선택이 되고, 올리면 같은 질문에도 답이 다양해진다. 그런데 확률표대로 뽑는 것이 가장 자연스러워 보이는데, 표를 일부러 바꿔서 뽑는 설정이 왜 필요할까? 그리고 그 설정에 하필 물리의 이름이 붙은 이유는 무엇일까?
로짓은 모델이 확률표를 만들기 직전에 토큰마다 매긴 점수이고, softmax 가 이 점수를 확률로 바꾼다. 로짓을 온도 τ로 나눈 뒤 softmax 를 씌우는 것은, 온도 1의 확률 p를 1/τ 제곱한 뒤 합이 1이 되게 다시 나누는 것과 같다. 확률은 로짓의 지수에 비례하므로, 로짓을 τ로 나누면 지수가 1/τ배가 되기 때문이다.
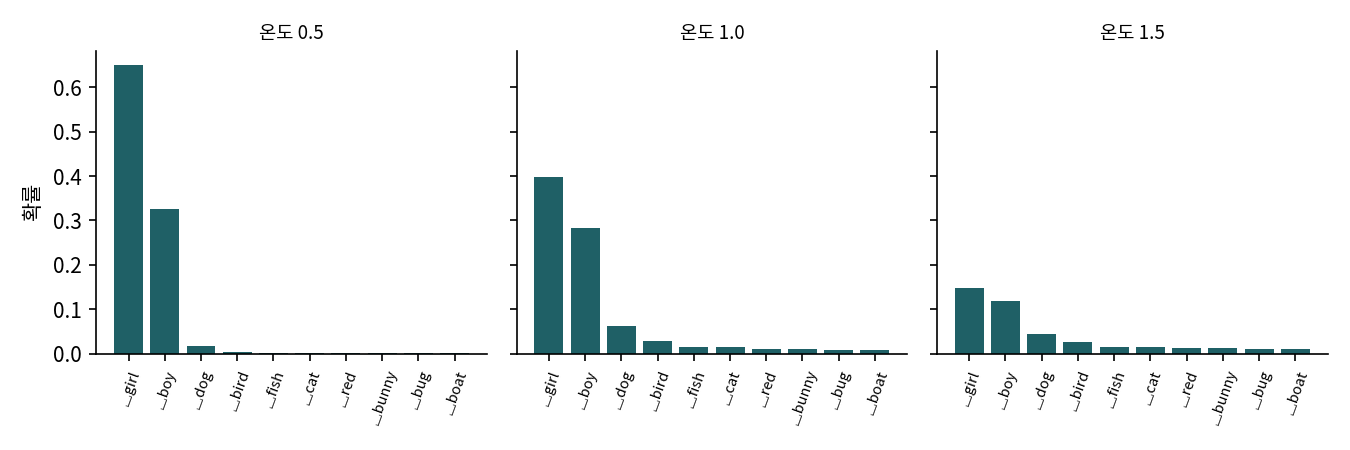
우리 모델이 「Once upon a time, there was a little」 다음 자리에 매긴 표를 세 온도로 바꿔 보았다.
| 토큰 | τ = 0.5 | τ = 1.0 | τ = 1.5 |
|---|---|---|---|
| ␣girl | 0.6497 | 0.3983 | 0.1481 |
| ␣boy | 0.3265 | 0.2823 | 0.1178 |
| ␣dog | 0.0162 | 0.0629 | 0.0433 |
| ␣bird | 0.0035 | 0.0290 | 0.0259 |
| 엔트로피 (nats) | 0.767 | 2.441 | 5.230 |
| 확률 0.001 넘는 토큰 | 4개 | 57개 | 137개 |
(␣ 는 토큰 앞의 빈칸이다.) 온도를 0.5로 내리면 「girl」과 「boy」 둘이 확률의 97% 를 차지하고, 1.5로 올리면 1등의 확률이 0.15 로 떨어지면서 확률 0.001 을 넘는 토큰이 137개로 는다. 엔트로피는 표가 얼마나 퍼졌는지를 nat 으로 잰 값인데, 0.767 에서 5.230 까지 일곱 배 가까이 커졌다. 모델이 바뀐 것은 없고, 같은 표를 뽑기 직전에 오므리거나 편 것뿐이다. 온도는 뽑는 단계에만 쓰는 설정이라 학습할 때 계산하는 로그확률에는 끼어들지 않는다.
자리 하나에서 본 표의 변화가 글 전체에서는 어떻게 나타날까? 같은 시작 문장으로 온도마다 샘플 20개씩 200 토큰을 뽑아, 되풀이 비율과 평균 놀람을 쟀다. 평균 놀람은 뽑힌 토큰에 온도 1 모델이 준 확률의 −ln 을 평균한 것으로, 모델 자신이 보기에 얼마나 뜻밖의 토큰을 골랐는지를 nats/토큰으로 잰다.
| 설정 | 되풀이 비율 | 평균 놀람 (nats/토큰) |
|---|---|---|
| 그리디 선택 (τ = 0, 샘플 1개) | 0.056 | 0.577 |
| τ = 0.7 | 0.065 | 0.971 |
| τ = 1.0 | 0.033 | 1.812 |
| τ = 1.5 | 0.001 | 5.851 |
온도를 올릴수록 평균 놀람이 커진다. 온도 1.5의 5.851 은 그리디 선택의 열 배이고, 모델 자신이 「여기에 이게 올 리 없다」고 본 토큰을 자주 골랐다는 뜻이다. 되풀이 비율은 온도 0.7 이 0.065 로 가장 높고 1.5 에서는 0.001 로 거의 사라진다. 샘플을 읽어 보면 숫자의 뜻이 보인다.
### τ=0.7 [2]  Minjune was three years old and very curious. Every day, Minjune would look up at the sky and watch the clouds. … Minjune quickly hid behind a big tree and waited for a moment. …
### τ=1.0 [1]  Minjun wanted to build a tall tower, so he packed his mattress, but it wasn't steady - it was too hard for Minjret to work. He asked his dad, "Can you help me with the blocks?" … So Minjit and his dad gathered the blocks …
### τ=1.5 [1]  Minjun wanted to build a tall tower like the others. A day of craft fell for and Min foc math laughed only few hours.\nMinjit asked him dad, "Can I build an airport wall thoughNo one else can". Dad smiled and kindly adjusted -That Tiny stayed from tw radish pushed even parade. …
온도 0.7 의 루나는 매끄럽게 쓰지만 같은 낱말을 자주 다시 살펴보고, 온도 1.0 의 루나는 이야기가 다양해지는 대신 Minjun 이름이 Minjret, Minjit 으로 흔들린다. 온도 1.5 에서는 둘째 문장부터 낱말이 문법 없이 흩어진다. 되풀이 비율이 0.001 로 떨어진 것은 다양해서가 아니라 말이 안 되는 토큰을 골랐기 때문이다.
0.7 이 제일 루나답다. 1.0 은 내 이름을 자꾸 바꾸고.

1.5 는 루나가 아니라 키보드에 고양이가 올라간 거고.
문제 3. 제곱해서 고르는 점심 메뉴
점심 메뉴 셋을 좋아하는 정도가 비빔밥 0.6, 국수 0.3, 돈가스 0.1 이고, 그 비율대로 날마다 메뉴를 뽑는다. (가) 좋아하는 정도를 제곱한 뒤 합이 1이 되게 다시 나눠서 뽑으면 메뉴마다의 확률은? (나) 제곱근으로 바꾸면? (다) 두 경우는 온도가 각각 얼마인 경우인가?
제곱하면 0.36, 0.09, 0.01 이고 합이 0.46 이니까, 나누면 0.7826, 0.1957, 0.0217. 비빔밥이 거의 매일이고 돈가스는 한 달에 한 번도 안 나오겠다.

제곱근은 0.7746, 0.5477, 0.3162 에 합이 1.6385. 나누면 0.4727, 0.3343, 0.1930 이야. 돈가스가 열 번에 두 번은 나와.

(다)는 식에서 지수를 맞춰 보면 돼요.
지수가 1/τ 니까 제곱은 τ = 0.5, 제곱근은 τ = 2 예요. 좋아하는 순서는 그대로 두고 차이만 키우거나 줄이네요.
순서가 안 바뀌니까 τ 를 0 쪽으로 끝까지 내리면 비빔밥만 남겠다. 그게 그리디 선택이고.
문제 4. 표의 숫자로 온도를 거꾸로 확인하기
표에서 τ = 1.0 일 때 「girl」과 「boy」의 확률은 0.3983, 0.2823 이다. (가) 온도의 식을 쓰면 τ = 0.5 와 τ = 1.5 에서 두 확률의 비는 각각 얼마가 되어야 하나? 표의 값으로 맞는지 확인하라. (나) 두 확률의 비는 분모의 합을 몰라도 계산할 수 있는가? (다) τ = 1.5 에서 「girl」의 확률이 0.3983 에서 0.1481 로 줄어든 것은 비만으로는 설명되지 않는다. 무엇이 더 필요한가?
일단 τ = 1 의 비는 0.3983 ÷ 0.2823 = 1.411. 표에서 τ = 0.5 는 0.6497 ÷ 0.3265 = 1.990 이고, 1.5 는 0.1481 ÷ 0.1178 = 1.257 이야.
식으로는 비가 1/τ 제곱이 돼. τ = 0.5 면 1.411² 이고, 음, 1.991 쯤. 1.5 면 1.411 의 2/3 제곱인데, 로그로 하면 ln 1.411 이 0.344 니까 2/3 를 곱해서 0.230, 지수로 돌리면 1.258.
표와 끝자리까지 맞네요. (나)는요?
비를 내면 분모가 위아래에서 지워져요. 두 토큰만 알면 나머지 4,094 개를 몰라도 되고요.
그럼 (다)는 어디서 왔을까요? 비만 보면 girl 은 boy 보다 1.257 배로 여전히 앞서는데, 확률 자체는 반 넘게 줄었어요.
음… 분모 아닐까요? τ = 1.5 에서 꼬리의 토큰들이 다 같이 커져서, 0.001 넘는 토큰이 57개에서 137개로 늘었잖아요. 둘 사이의 비는 조금만 줄었는데, 분모에 백 개 넘는 꼬리의 확률이 더해지니까 둘 다 작아진 거예요.
온도를 올리면 위쪽 토큰끼리의 순서는 그대로인데 꼬리 전체가 함께 올라와요. 온도 1.5 샘플이 무너진 것도 그 꼬리에서 토큰이 뽑혔기 때문이고요.