루나에게 말 걸기: 같은 시작 문장에 왜 매번 다른 이야기가 나올까
top-k 와 top-p: 확률표의 꼬리를 잘라 내기
온도 1.0 의 루나는 이야기가 다양했지만 이름이 흔들렸고, 1.5 의 루나는 문장이 무너졌다. 두 경우 모두 확률이 작은 꼬리의 토큰이 가끔 뽑힌 탓이다. 꼬리의 토큰 하나하나는 확률이 작아도, 어휘가 4,096 개이니 꼬리 전체를 더하면 작지 않고, 200 토큰을 쓰는 동안 그중 몇 번은 꼬리에서 뽑힌다. 그러면 다양함은 살리면서 꼬리만 잘라 낼 수는 없을까?
역사: 동화 데이터와 「신경 글의 퇴화」
꼬리를 자르자는 생각은 이야기를 쓰는 모델에서 먼저 나왔다. 2018년 5월, 페이스북 AI 리서치의 앤절라 팬(Angela Fan), 마이크 루이스(Mike Lewis), 얀 도팽(Yann Dauphin)은 「계층적 신경 이야기 생성(Hierarchical Neural Story Generation)」을 아카이브에 올렸다. 레딧의 글쓰기 게시판에서 모은 이야기 303,358 편과 그 이야기를 이끈 짧은 글감을 함께 묶은 데이터로 모델을 학습해, 글감을 주면 이야기를 쓰게 한 연구였다. 생성 방법을 적은 대목에서 그들은 빔 서치(가장 확률이 큰 글을 넓게 찾는 방법)가 학습 데이터의 흔한 구절과 되풀이되는 글을 낳고, 아무 제한 없이 뽑으면 아주 드문 낱말이 끼어들어 글을 망친다고 적었다. 그래서 스텝마다 확률이 큰 10개 후보 안에서만 뽑았는데, 이것이 지금 top-k 라고 부르는 방법이다.
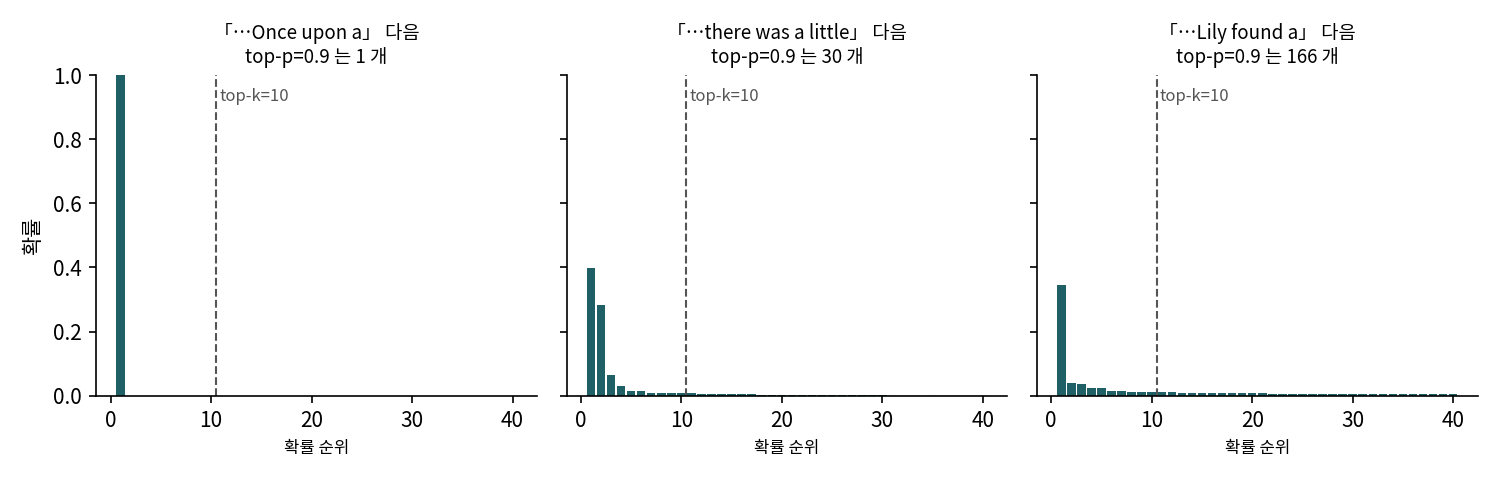
이듬해 2019년 4월, 아리 홀츠먼(Ari Holtzman)과 동료들(얀 부이스, 리 두, 맥스웰 포브스, 최예진)은 「신경 글 퇴화의 기이한 사례(The Curious Case of Neural Text Degeneration)」를 올렸다. 그들은 확률을 가장 크게 하는 해독이 따분하고 이상하게 되풀이되는 글을 낳고, 그렇다고 표대로 다 뽑으면 엉뚱한 글이 나온다는 두 실패를 나란히 놓았다. top-k 의 약점도 짚었다. 다음 토큰이 거의 정해진 자리와 여러 토큰이 고르게 그럴듯한 자리에서 같은 k 개를 남기면, 앞의 자리에서는 엉뚱한 후보까지 남기고 뒤의 자리에서는 그럴듯한 후보를 잘라 버린다는 것이다. 그들이 낸 방법은 후보 수를 고정하지 않고, 확률이 큰 토큰부터 더해 합이 p 에 이를 때까지만 남기는 것이었고, 남은 후보 묶음을 「핵(nucleus)」이라 불렀다. 같은 생각을 우리 모델의 세 자리에서 다시 재 보았다.
같은 k, 다른 자리
확률이 큰 k 개만 남기고 나머지를 버린 뒤 다시 나눠 뽑는 것을 top-k 샘플링, 확률이 큰 것부터 더해 합이 p 를 넘는 순간까지만 남기는 것을 top-p 샘플링(nucleus sampling)이라 한다. 그림의 세 자리에서 두 규칙이 남기는 것을 숫자로 보면 다음과 같다.
| 시작 문장의 끝 | 1등 토큰과 확률 | 엔트로피 (nats) | top-k = 10 이 남기는 확률 합 | top-p = 0.9 가 남기는 토큰 수 |
|---|---|---|---|---|
| Once upon a | ␣time 1.0000 | 0.001 | 1.0000 | 1개 |
| Once upon a time, there was a little | ␣girl 0.3983 | 2.441 | 0.8338 | 30개 |
| One day, Lily found a | ␣big 0.3460 | 4.054 | 0.5306 | 166개 |
「Once upon a」 뒤에서는 「time」 하나가 확률 1.0000 이라 top-k = 10 도 실제로 뽑히는 것은 「time」뿐이다. 차이는 후보가 퍼진 자리에서 난다. 「Lily found a」 뒤에서 top-k = 10 은 확률의 53% 만 남기고, 「new」 「pretty」 「small」 다음에 올 수 있는 그럴듯한 형용사들을 잘라 버린다. top-p = 0.9 는 같은 자리에서 166개를 남기고, 뾰족한 자리에서는 1개만 남겨 자리마다 표의 형태에 맞춰 후보 수를 바꾼다. 공용 모듈은 두 규칙을 온도 뒤에 차례로 건다.
# sources/common/sample.py 의 filter_logits (발췌)
logits = logits / temperature                       # 1) 온도
if top_k is not None:                               # 2) k 등보다 작은 로짓은 버린다
    kth = torch.topk(logits, top_k, dim=-1).values[:, -1:]
    logits = logits.masked_fill(logits < kth, float("-inf"))
probs = logits.softmax(dim=-1)
if top_p is not None:                               # 3) 큰 것부터 더해 p 를 채우면 나머지는 버린다
    sp, si = probs.sort(dim=-1, descending=True)
    cum = sp.cumsum(dim=-1)
    drop = cum - sp > top_p                         # 앞에서 이미 p 를 채웠으면 버린다(1등은 늘 남는다)
    ...
같은 시작 문장으로 샘플 20개씩 뽑아 온도 1 의 샘플과 비교했다.
| 설정 | 되풀이 비율 | 평균 놀람 (nats/토큰) |
|---|---|---|
| τ = 1.0 (자르지 않음) | 0.033 | 1.812 |
| top-k = 10 | 0.042 | 1.160 |
| top-k = 50 | 0.038 | 1.523 |
| top-p = 0.5 | 0.073 | 0.700 |
| top-p = 0.9 | 0.041 | 1.268 |
| τ = 1.5 + top-p = 0.9 | 0.003 | 4.630 |
꼬리를 자르자 평균 놀람이 1.812 에서 1.1~1.5 로 내려갔고, 샘플의 이름도 덜 흔들렸다. top-p = 0.9 의 첫 샘플은 이렇다.
### top-p=0.9 [1] Minjun wanted to build a tall tower, so he asked his friend, "Can I build the tallest tower?" His friend said, "Yes, you can. Here is an onion". \nMinjun was very happy and he thanked his friend. …
탑을 쌓겠다니까 양파를 줘. 문장은 다 맞는데.

꼬리를 잘라도 말이 되는 것과 이야기가 되는 건 다르네. 그래도 Minjret 보다는 낫다.
표의 마지막 줄은 이상하다. 온도 1.5 에 top-p = 0.9 를 더해도 평균 놀람이 4.630 으로, 온도 1.0 의 1.812 보다 훨씬 크다. 꼬리를 잘랐는데 왜 여전히 무너지는지는 아래 문제 6에서 코드를 따라가며 찾아본다.
문제 5. 회식 메뉴를 다섯 개만 남길까, 표가 70% 가 될 때까지 남길까
동아리 회식 장소를 투표로 정한다. 첫째 주에는 고깃집이 표의 92% 를 받았고 나머지 8% 는 열 곳에 흩어졌다. 둘째 주에는 표가 스무 곳에 고르게 흩어졌다(곳마다 약 5%). 후보를 줄인 뒤 표 비율대로 제비를 뽑기로 했다. (가) 「표가 많은 다섯 곳만 남기기」로 하면 두 주에 각각 무엇이 문제인가? (나) 「표가 많은 곳부터 더해 70% 가 될 때까지 남기기」로 하면 두 주에 몇 곳이 남는가? (다) 두 규칙은 top-k 와 top-p 가운데 어느 것인가?
둘째 주부터 볼게. 다섯 곳만 남기면 표의 25% 만 남아. 나머지 열다섯 곳도 똑같이 5% 씩 받았는데 순위가 조금 낮다는 이유로 빠지고.

첫째 주는 반대야. 고깃집이 92% 니까 다섯 곳을 남기면 표가 1% 도 안 되는 네 곳이 같이 남아. 그래도 비율대로 뽑으니까 걔네가 뽑힐 일은 드물긴 하겠다.

(나)로 하면요?
첫째 주는 고깃집 하나로 이미 92% 라 한 곳. 둘째 주는 5% 씩 더해서 열네 곳이 돼야 70% 에 이르러요.
그러니까 (가)가 top-k 고 (나)가 top-p 야. 표가 한 곳에 몰리면 top-p 는 하나만 남기고, 고르게 퍼지면 많이 남겨. 그림의 「Once upon a」 뒤 1개, 「Lily found a」 뒤 166개랑 같은 모양이네.
첫째 주의 다섯 곳이 크게 해롭지 않았던 것도 기억해 둬요. 비율대로 뽑으면 작은 후보는 남아 있어도 잘 안 뽑혀요. 그 작은 후보가 갑자기 해로워지는 때가 있는데, 다음 문제에서 볼 거예요.
남겨 둔 네 곳의 표가 어떤 이유로 갑자기 불어나는 때겠네요. 온도를 올리면 꼬리가 같이 올라왔던 것처럼.
문제 6. 온도 1.5 에 top-p 를 걸어도 무너지는 이유
샘플 20개로 잰 평균 놀람이 τ = 1.0 은 1.812, top-p = 0.9 는 1.268, τ = 1.5 는 5.851, τ = 1.5 + top-p = 0.9 는 4.630 이었다. 「Once upon a time, there was a little」 다음 자리에서 τ = 1 이면 top-p = 0.9 가 30개를 남긴다. (가)
filter_logits는 온도와 top-p 를 어떤 순서로 거는가? (나) 그 순서로 τ = 1.5 에 top-p = 0.9 를 걸면, 같은 자리에서 남는 토큰은 30개보다 많을까 적을까? (다) 순서를 바꿔 top-p 로 먼저 자르고 온도를 나중에 걸면 무엇이 달라질까?
(가)는 코드에 있어. 로짓을 온도로 먼저 나누고, softmax 하고, 그다음에 top-p. 그러니까 top-p 는 이미 펴진 표에서 잘라.
그럼 (나)는 많아지겠다. τ = 1.5 의 표는 1등이 0.1481 이고 0.001 넘는 토큰이 137개였으니까, 0.9 를 채우려면 훨씬 많이 더해야 해.
몇 개쯤일지는 재 보지 않았으니 「30개보다 훨씬 많다」까지만 말할 수 있어요. 그 많아진 후보에는 무엇이 들어 있을까요?
온도 1 에서는 잘렸을 꼬리요. 온도가 꼬리를 키워서 핵 안으로 끌어들이고, top-p 는 끌려 들어온 꼬리를 그대로 남겨요. 그래서 4.630 이 5.851 보다만 조금 낮은 거고요.

(다)는 순서를 바꾸면 τ = 1 표에서 30개를 먼저 고르고, 그 30개 안에서만 펴는 거지? 꼬리는 들어올 수가 없고, 남은 후보끼리 더 고르게 뽑히겠네.
그래요. 그런 순서를 쓰는 구현도 있어요. 다만 우리 실험은 그 순서로 돌려 보지 않았으니, 평균 놀람이 얼마나 될지는 직접 재 봐야 알아요. 설정 화면의 설정 여러 개가 같이 있을 때, 어느 것이 먼저 걸리는지 코드로 확인하는 습관이 필요한 이유예요.