한국어는 몇 조각인가: 영어로 배운 토크나이저의 바깥
민준이 어휘 4,096 토크나이저에 장난삼아 「루나」를 넣어 보자, 화면에는 알아볼 수 없는 물음표 상자 여섯 개가 떴다.
「 Luna」는 한 토큰인데, 「루나」는 여섯 개야. 글자는 두 개뿐인데.

한글은 UTF-8 로 글자 하나에 3 바이트잖아. 영어 동화로만 합쳤으니 한글 바이트는 한 번도 안 합쳐진 거고.
영어로 배운 토크나이저로 한국어를 자르면 무엇이 일어나고, 한국어로 배우면 얼마나 나아질까?
같은 예문을 토크나이저 여섯 개로
이 책의 BPE 두 가지(어휘 512, 4,096), 한국어 타이니스토리즈로 따로 배운 한국어 BPE(어휘 4,096), 그리고 공개된 토크나이저 셋(GPT-2, GPT-4 의 cl100k, GPT-4o 의 o200k)으로 예문을 잘랐다. 한국어 BPE 는 한국어 타이니스토리즈 검증 파일의 앞 90% 이야기(27,623,893 바이트)로 학습했다. 이 한국어판은 영어 타이니스토리즈를 기계로 번역한 글이라 문장 품질이 고르지 않다.
| 예문 | 우리 BPE 512 | 우리 BPE 4096 | 한국어 BPE 4096 | GPT-2 | cl100k | o200k |
|---|---|---|---|---|---|---|
Once upon a time there was a girl named Lily. |
11 | 11 | 45 | 11 | 11 | 11 |
Hello, I am Luna. |
12 | 6 | 17 | 6 | 6 | 6 |
루나 |
6 | 6 | 2 | 6 | 3 | 2 |
안녕, 나는 루나야. |
25 | 25 | 7 | 23 | 13 | 8 |
별빛 정거장 |
16 | 16 | 5 | 15 | 8 | 5 |
옛날 옛날에 루나라는 아이가 살았어요. |
53 | 53 | 9 | 48 | 26 | 16 |
(토큰 수. 토큰들까지 적은 출력은 sources/tokens/train_bpe.out.)
영어로만 배운 우리 BPE 는 한국어 예문을 바이트 수만큼 흩어 놓는다. 「옛날 옛날에 루나라는 아이가 살았어요.」는 53 바이트라서 53 토큰이고, 합치기가 한 번도 일어나지 않았다. 반대로 한국어로 배운 BPE 는 영어 예문을 글자 하나씩 잘라 45 토큰으로 만들므로, 토크나이저는 자기가 배운 글의 언어에서만 글을 줄인다고 할 수 있다.
한국어 BPE 가 자른 결과를 보면 「안녕」, 「 나는」, 「 살았어요」가 한 토큰인데, 「루나」만은 둘로 남는다.
'안녕, 나는 루나야.' (11 글자, 25 바이트)
  한국어 BPE 4096:  7 | 안녕 , ␣나는 ␣루 나 야 .
  GPT-4o(o200k):  8 | 안 녕 , ␣나는 ␣루 나 야 .

한국어 BPE(어휘 4,096): 한국어 타이니스토리즈 검증 파일 앞 90% 이야기 27,623,893 바이트로 학습, 87.0초
  한국어 BPE 에서 '루나': 토큰 하나 아님 -> ['루', '나']
  한국어 BPE 에서 ' 루나': 토큰 하나 아님 -> ['␣루', '나']
  한국어 BPE 에서 '나': 190번째 합치기로 토큰 하나
  학습 글에 '루나' 274번, 'Luna' 는 영어 학습 글 50MB 에 881번
「나」는 190번째 합치기에서 이미 한 토큰이 되었지만, 「루나」는 학습 글에 274 번밖에 나오지 않아 합치기 3,839 번 안에 들지 못했다.

한국어 동화에서도 루나는 두 조각이네.
게임 속 루나는 한국어로 말했는데.
서연이 그 말을 하고 화면 속 「␣루」와 「나」 두 칸을 잠깐 보는 동안, 민준은 대답하지 않고 영어 표로 창을 돌렸다.
글자 하나에 드는 토큰 수
예문 몇 개로는 우연이 섞이므로, 한국어 샘플 글(한국어 검증 파일 뒤 10% 이야기 앞 40만 바이트, 166,884 글자)과 영어 샘플 글(영어 검증 글 앞 40만 바이트, 399,834 글자)을 토크나이각각 잘라 글자 하나에 드는 토큰 수를 쟀다. 한국어 샘플 글은 한국어 BPE 를 학습할 때 쓰지 않은 뒤쪽 10% 다.
토크나이저                 한국어 글자당     영어 글자당     한국어/영어
우리 BPE 4096             2.388      0.253       9.43
한국어 BPE 4096            0.425      0.988       0.43
GPT-2                   2.115      0.249       8.51
GPT-4(cl100k)           1.027      0.241       4.26
GPT-4o(o200k)           0.619      0.239       2.59
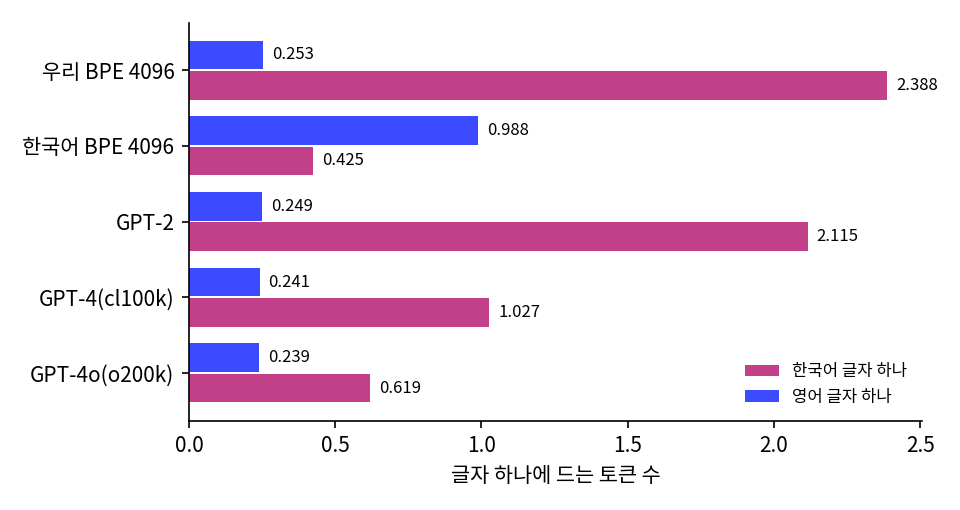
GPT-2 의 토크나이저는 한국어 글자 하나에 2.115 토큰을 쓴다. 영어 글자 하나에 0.249 토큰이니, 같은 글자 수의 글이라면 한국어가 8.51 배의 토큰이 된다. GPT-4 의 cl100k 에서 4.26 배, GPT-4o 의 o200k 에서 2.59 배로 줄어드는데, 새 토크나이저일수록 학습 글에 한국어가 더 많이 들어갔다고 짐작할 수 있다(토크나이저를 학습한 글의 구성은 공개되지 않아 확인하지 못했다).
이 책이 2부부터 쓰는 nanochat 의 토크나이저(어휘 32,768, 웹 글 ClimbMix 로 학습)도 이 머신에서 재 보았다. 한국어 글에서 토큰 하나에 1.21 바이트가 들어, 같은 글에 GPT-4 토크나이저는 2.45 바이트였다(우리가 잰 값, 이 머신의 CPU 로 nanochat 고정 커밋 92d63d4 의 토크나이저를 학습해 잼). 같은 한국어 글에 GPT-4 보다 토큰이 두 배쯤 든다는 뜻이므로, nanochat 으로 키울 루나도 한국어는 거의 바이트 단위로 읽게 된다.
ML에서: 토큰이 많으면 비싸다
토큰 수는 곧 비용이다. 학습은 토큰 수에 비례해 계산이 들고, 모델이 한 번에 읽는 문맥 길이도 토큰 수로 정해지며, 유료 언어 모델 서비스의 값도 토큰 수로 매긴다. 같은 내용을 한국어로 쓰면 토큰이 몇 배 드는 토크나이저라면, 한국어 사용자는 같은 일에 몇 배의 값을 내고 같은 문맥 창에 몇 분의 일의 글만 넣는 셈이 된다. 새 토크나이저들이 어휘를 키우고 학습 글에 여러 언어를 섞는 것은 언어 사이의 토큰 수 차이를 줄이려는 시도이기도 하다.
문제 6. 문자 메시지 80 바이트
우리나라 휴대폰 단문 메시지는 한 통에 흔히 80 바이트까지 보낼 수 있는데(통신사에 따라 90 바이트), 이 방식에서 영어 글자는 1 바이트, 한글 글자는 2 바이트로 적는다. 「Happy birthday, Luna!」(21 글자)와 같은 뜻의 한글 메시지 「생일 축하해 루나!」(공백·문장 부호 포함 10 글자)는 각각 몇 바이트이고, 한 통에 글자를 몇 개까지 넣을 수 있는가?
영어는 21 바이트, 한 통에 80 글자요.
한글 메시지는 한글 일곱 글자가 14 바이트에 공백 둘과 느낌표 하나가 3 바이트라 17 바이트예요. 한글만 쓰면 한 통에 40 글자고요.

두 메시지의 바이트 수는 비슷한데, 한 통에 넣을 수 있는 글자 수는 왜 반이 될까요?
한글이 짧게 말하는 대신 글자 하나가 무거운 거네요. 같은 뜻을 적는 데는 바이트가 비슷하게 들었어요. 그런데 GPT-2 토크나이저는 한글 글자 하나에 2.115 토큰이니까, 바이트 말고 토큰으로 세면 한글이 훨씬 손해고요.
메시지의 규칙은 한글 한 글자를 2 바이트로 정해 두었어요. 토크나이저는 한글 한 글자를 몇 토큰으로 자를지 무엇이 정했죠?
토크나이저를 학습한 글이요. 학습 글에 한국어가 적으면 한글 바이트끼리 합쳐질 기회가 적으니까, 한글이 잘게 남아요.
문제 7. GPT-2 의 문맥 1,024 토큰
GPT-2 는 한 번에 1,024 토큰까지 읽는다. GPT-2 토크나이저는 한국어 글자 하나에 2.115 토큰, 영어 글자 하나에 0.249 토큰을 쓴다. 문맥 하나에 한국어와 영어 글자가 각각 몇 개까지 들어가는가? 이야기 앞에 나온 이름을 기억해 쓰는 일에는 무슨 차이가 생기는가?
1,024 ÷ 2.115 가 484, 1,024 ÷ 0.249 가 4,112 예요(sources/tokens/problems.out). 영어는 4,000 글자가 넘게 들어가는데 한국어는 500 글자도 안 돼요.
영어 타이니스토리즈 이야기 하나가 평균 202 토큰이니까(sources/tokens/encode_dataset.out), 영어로는 이야기 다섯 편이 들어가겠네. 한국어로 같은 이야기를 쓰면 몇 배 길어지니까 한 편도 다 안 들어갈 수도 있고.
한국어 이야기 첫 문단에 아이 이름이 나오고, 끝 문단에서 그 이름을 다시 불러야 한다면요?
이름과 끝 문단 사이가 484 글자를 넘으면, 이름이 문맥 밖으로 밀려나요. 모델이 아무리 잘 배워도 못 보는 거니까 기억할 수가 없어요.
토크나이저가 한 언어를 잘게 자르면, 그 언어에서는 모델이 볼 수 있는 거리가 그만큼 줄어드는 거네요.