어휘 크기: 토큰이 길어지면 무엇이 줄고 무엇이 늘까
합치기를 더 할수록 토큰은 길어지고 같은 글이 더 적은 토큰으로 줄어드니, 같은 개수의 토큰으로 더 먼 앞까지 볼 수 있다는 점에서는 어휘가 클수록 좋을 것 같다. 그런데 1부는 왜 8,192 까지 배워 놓고 4,096 에서 잘랐을까? 어휘를 두 배로 늘릴 때마다 토큰 수는 얼마나 줄어들까?
어휘 다섯 가지로 같은 검증 글을 잘라 보기
검증 글 전체(22,132,376 바이트)를 어휘 크기만 바꿔 자르고 토큰 수를 셌다. 토큰 하나에 든 평균 바이트 수를 압축률 (토큰 하나에 담긴 바이트 수 / bytes per token)이라 부르자.
## 어휘 크기와 압축률 (검증 글 전체 22,132,376 바이트, 글자 22,123,162)
    어휘         토큰 수     바이트/토큰     글자/토큰
   256   22,132,376      1.000     1.000   (바이트 그대로)
   512    9,208,073      2.404     2.403
  1024    7,012,197      3.156     3.155
  2048    6,056,674      3.654     3.653
  4096    5,607,193      3.947     3.945
  8192    5,443,827      4.066     4.064
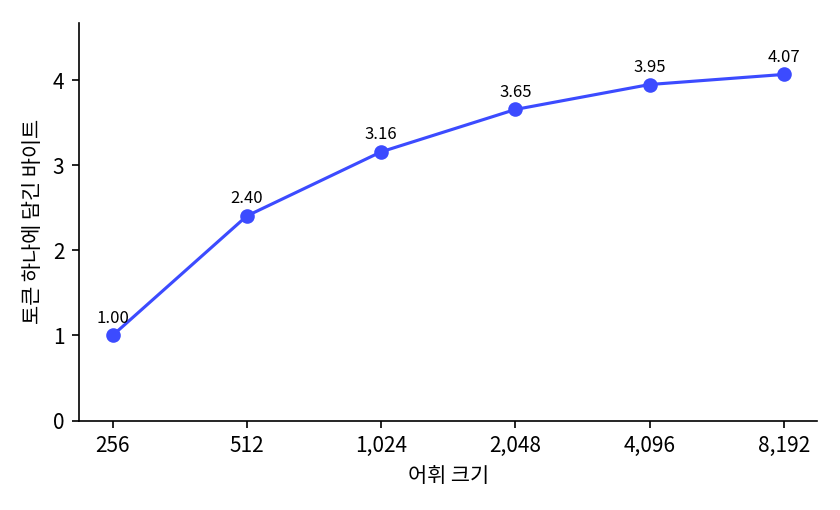
어휘를 256 에서 512 로, 합치기 255 번만 더해도 토큰 수는 2,213만 개에서 921만 개로 반 아래가 된다. 반면 4,096 에서 8,192 로 합치기를 4,096 번 더하면 토큰 수는 2.91% 밖에 줄지 않는다(sources/tokens/problems.out). 앞에서 합친 토큰은 「 the」처럼 수십만 번 나오는 묶음이고, 뒤에서 합친 토큰은 4,000번째 합치기 「 beef」처럼 드문 낱말이기 때문이다.
  100번째: '␣ha' + 'pp' -> '␣happ'
  500번째: 'W' + 'h' -> 'Wh'
 1000번째: '␣to' + 'p' -> '␣top'
 2000번째: '␣j' + 'elly' -> '␣jelly'
 4000번째: '␣bee' + 'f' -> '␣beef'
 7900번째: 'ri' + 'er' -> 'rier'
타이니스토리즈의 낱말은 쉬워서 흔한 낱말은 일찍 토큰이 된다. 그래서 「Once upon a time there was a girl named Lily.」는 어휘 512 로도 4,096 으로도 똑같이 11 토큰이다. 어휘를 크게 늘려 얻는 것은 이야기에 가끔 나오는 낱말(「 jelly」, 「 beef」)을 한 토큰으로 읽는 일뿐이다.
어휘를 늘리면 늘어나는 것
모델 쪽에서 보면 어휘는 공짜가 아니다. 언어 모델은 토큰마다 벡터 하나를 받아 읽고, 마지막에는 어휘의 모든 토큰에 점수를 하나씩 매겨 다음 토큰을 고른다. 앞 토큰 여럿을 읽는 작은 신경망(은닉 벡터 길이 512)이라면, 점수를 매기는 마지막 층의 파라미터는 어휘 4,096 에서 2,101,248 개이고 어휘 8,192 에서는 4,202,496 개로 두 배가 된다. 토큰 수 2.91% 를 줄이려고 마지막 층을 두 배로 키우는 셈이니, 작은 모델에게는 손해다.
드문 토큰이 늘어나는 것도 문제다. 4,000번째 합치기로 생긴 「 beef」는 학습 글에서 몇 번 나오지 않으므로, 모델은 그 토큰 뒤에 무엇이 오는지 배울 기회를 몇 번밖에 얻지 못한다. 어휘를 키울수록 토큰 하나하나가 학습 글에 나오는 횟수는 준다. 1부가 어휘 4,096 을 고른 것은 작은 모델과 쉬운 동화 글에서 이 두 손해와 압축률을 맞바꾼 결과다. nanochat 이 웹 글로 큰 모델을 학습할 때는 어휘가 32,768 이다.
토크나이저를 바꾸면 토큰 하나에 든 바이트 수가 바뀌므로, 토큰 하나당 손실은 토크나이저가 다른 모델끼리 비교할 수 없다. 서연이 지난 학기 강의를 떠올렸다.
1부의 모든 모델은 이 규칙대로 검증 손실을 바이트당 비트로 바꿔 적는다. 토큰마다 그 토큰이 담은 원문 바이트 수를 알고 있으므로(BPETokenizer.token_bytes), 손실의 합을 바이트 수의 합으로 나누면 된다.
ML에서: 큰 모델의 어휘
GPT-2 의 어휘는 50,257 개였고, 그 뒤의 큰 모델들은 어휘를 그보다 몇 배로 늘려 왔다. 모델이 커지면 어휘 크기에 비례하는 입출력 층이 전체 파라미터에서 차지하는 비율이 작아지고, 학습 글도 많아져 드문 토큰도 충분히 자주 나오게 된다. 그래서 작은 모델은 작은 어휘, 큰 모델은 큰 어휘가 어울린다. 이 저울질은 1부의 4,096 과 nanochat 의 32,768 사이에서도 같다.
문제 4. 바이트 바이그램과 토큰 바이그램
바이트 하나를 토큰으로 본 바이그램의 검증 손실은 2.2833 nats/바이트(바이트당 비트 3.2940)였다. 어휘 4,096 의 BPE 토큰으로 바이그램을 세면 검증 손실이 3.5296 nats/토큰, 바이트당 비트가 1.2818 이다. 토큰당 손실은 토큰 바이그램이 더 크다. 어느 모델이 검증 글을 더 잘 맞히는가?

숫자만 보면 2.2833 이 3.5296 보다 작으니까 바이트 쪽이 나은 것 같은데요.

두 손실은 무엇 하나당 손실이에요?
아, 하나는 바이트 하나당이고 하나는 토큰 하나당이네요. 토큰 하나는 4 바이트쯤 되니까 같은 자로 잰 게 아니에요.

바이트당 비트로 바꾸면 바로 비교돼요. 1.2818 대 3.2940 이니까 토큰 바이그램이 2.5 배쯤 잘 맞혀요.
바이트당 비트에서 거꾸로 토큰 하나에 든 바이트 수도 구할 수 있을까요?
3.5296 을 ln 2 로 나누면 토큰당 비트고, 그걸 1.2818 로 나누면… 토큰 하나에 3.973 바이트예요(sources/tokens/problems.out). 검증 글을 부호화할 때 나온 3.976 과 거의 같네요.
둘 다 앞 토큰 하나만 보는 바이그램인데, 토큰 하나가 4 바이트쯤 되니까 바이트로 치면 앞을 네 글자쯤 보는 거네. 그래서 이렇게 차이가 나는구나.
그래요. 같은 「바로 앞 하나만 보기」라도 하나의 크기를 키우니 더 먼 앞을 보게 됐어요. 토크나이저를 고르는 일이 모델이 볼 수 있는 거리를 정하는 일이기도 해요.
문제 5. 어휘를 두 배로
어휘를 4,096 에서 8,192 로 늘리면 검증 글의 토큰 수는 5,607,193 개에서 5,443,827 개가 된다. 은닉 벡터 길이 512 인 작은 신경망의 마지막 층 파라미터는 2,101,248 개에서 4,202,496 개가 된다. 1부의 작은 모델에게 어휘 8,192 가 나은가?
토큰 수는 2.91% 줄고 마지막 층은 두 배예요. 계산 비용만 보면 손해네요.
근데 토큰이 줄면 같은 문맥 길이로 더 멀리 보잖아. 2.91% 라도 멀리 보는 건 이득 아니야?
앞 토큰 여섯 개를 보는 모델이라고 해 볼까요. 어휘 4,096 이면 여섯 토큰이 몇 바이트쯤이에요?
토큰 하나에 3.947 바이트니까 23.7 바이트쯤이요. 8,192 면 4.066 이라 24.4 바이트쯤이고요. …1 바이트도 안 늘어요.

늘어난 어휘는 「 beef」 같은 드문 낱말이라, 그 토큰들은 학습 글에 몇 번 안 나와서 배우기도 어렵겠어요.
어휘를 늘려서 얻는 거리는 뒤로 갈수록 작아지고, 드문 토큰을 배울 데이터는 모자라져요. 데이터가 많고 모델이 큰 nanochat 은 같은 계산에서 32,768 을 골랐어요. 어휘 크기는 모델과 데이터의 크기에 맞춰 고르는 값이에요.