흐림: 조건을 세밀하게 주면 선명해질까
VAE 가 뽑은 그림을 보면 아직 흐릿하다. 사전분포에서 잠재 변수를 뽑아 디코더가 내놓은 잉크 확률을 그리면, 회색(0.2 ~ 0.8) 칸이 18.5%다. 학습에 쓴 흑백 그림에는 회색 칸이 하나도 없다.
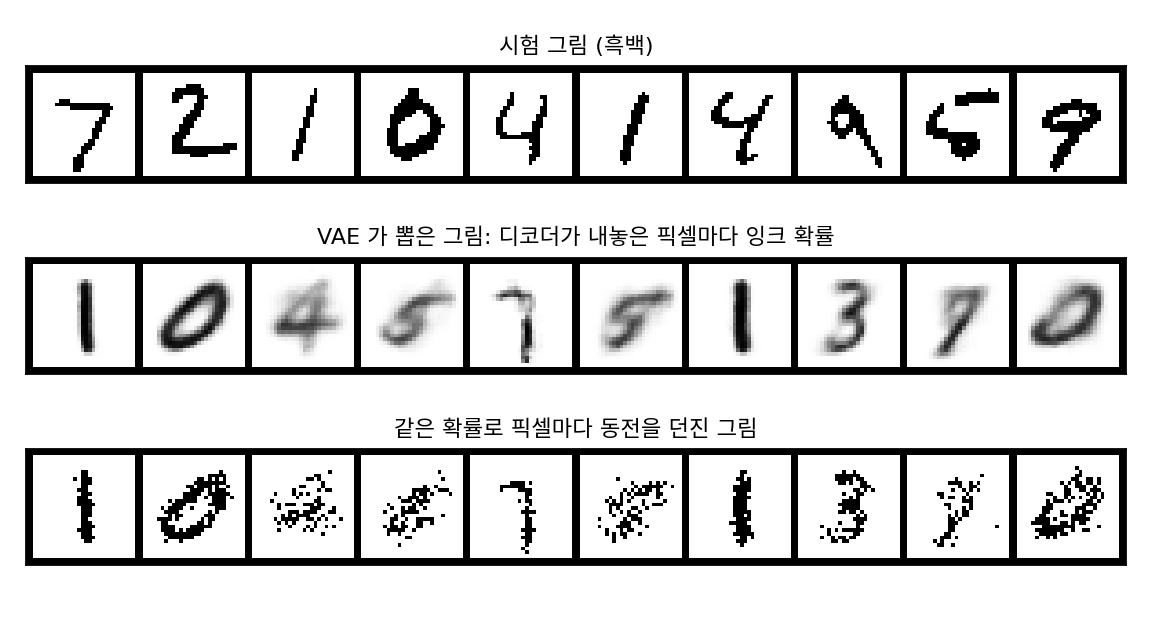
잠재 변수를 16칸으로 늘려 같은 방식으로 학습해도 회색 칸이 8.6% 남는다. 잠재 변수가 늘면 ELBO는 −90.36까지 오르지만 흐릿함은 사라지지 않는다.
흐림이 어디서 오는지는 이미 보았다. 라벨 「3」 하나에 6,131가지 3이 붙어 있으면, 제곱 오차로 배운 신경망은 그 평균(조건부 평균)을 그렸다. 많이 망가진 그림을 고친 디노이저도 그 그림이 나올 수 있었던 원래 그림들의 평균을 내놓아 흐려졌다. VAE 의 디코더가 평균을 내놓는 것도 같은 이유 때문인데, 잠재 변수 2칸의 값이 정해진 뒤에도 그 잠재 변수 값에 어울리는 그림이 여럿 남아 있으면 디코더는 칸마다 그 그림들의 잉크 비율을 내놓을 수밖에 없다. 그렇다면 디코더에게 정보를 더 주면 어떨까? 같은 3이라도 「뾰족한 3」인지 「둥근 3」인지, 굵게 썼는지 가늘게 썼는지까지 알려 주면 남는 후보가 줄어 평균이 덜 흐려지지 않을까?
조건을 디코더에 함께 주기
가장 쉬운 정보는 라벨이다. 인코더와 디코더의 입력 끝에 라벨 원-핫 벡터를 이어 붙이고, 나머지는 VAE 와 똑같이 학습한다. 그러면 디코더는 「잠재 변수 z와 조건 c를 받아 그림을 그리는」 함수 pθ(x ∣ z, c)가 되고, 새 그림을 뽑을 때는 원하는 조건을 골라 주고 잠재 변수는 N(0, I)에서 뽑는다. 이렇게 조건을 받는 VAE 를 조건부 VAE (조건을 함께 받는 VAE / conditional VAE)라 한다. 2015년 손기혁(Kihyuk Sohn), 이홍락(Honglak Lee), 옌(Xinchen Yan)이 출력이 여러 가지일 수 있는 예측 문제를 풀려고 이 구조를 내놓았다.
스타일을 그림에서 재기
라벨보다 세밀한 조건은 데이터에 붙어 있지 않으니, 그림에서 직접 세 가지를 쟀다.
- 쏠림: 잉크 칸들의 무게중심이 28 × 28 격자 가운데에서 좌우·상하로 몇 칸 벗어났나(두 수). 재 보니 학습 그림 6만 장의 표준편차가 0.31칸, 0.33칸뿐이었다. MNIST 는 만들 때 그림을 잉크의 무게중심이 격자 가운데에 오도록 옮겨 두었기 때문이다. 흑백으로 자르면서 생긴 작은 차이만 남았다.
- 두께: 잉크 칸 수. 숫자마다 원래 다르다(중앙값 1은 58칸, 3은 110칸, 0은 136칸). 그래서 같은 숫자 안에서의 순위로 쓴다. 학습 그림 「3」 6,131장은 아래 10%가 75칸 이하, 위 10%가 152칸 이상이다.
- 둥근 정도: 가로·세로·두 대각선 방향의 곧은 획을 찾는 5칸짜리 필터 네 개를 합성곱으로 씌우고, 잉크 칸마다 어느 방향으로 곧게 가장 길게 이어지는지 센다. 네 방향에 고르게 퍼질수록 둥글다(방향 비율의 엔트로피를 log 4로 나눈 값, 0 ~ 1). 숫자별 평균은 1이 0.53, 7이 0.82, 0이 0.93, 8이 0.94다. 둥근 정도도 두께처럼 같은 숫자 안의 순위로 쓴다.
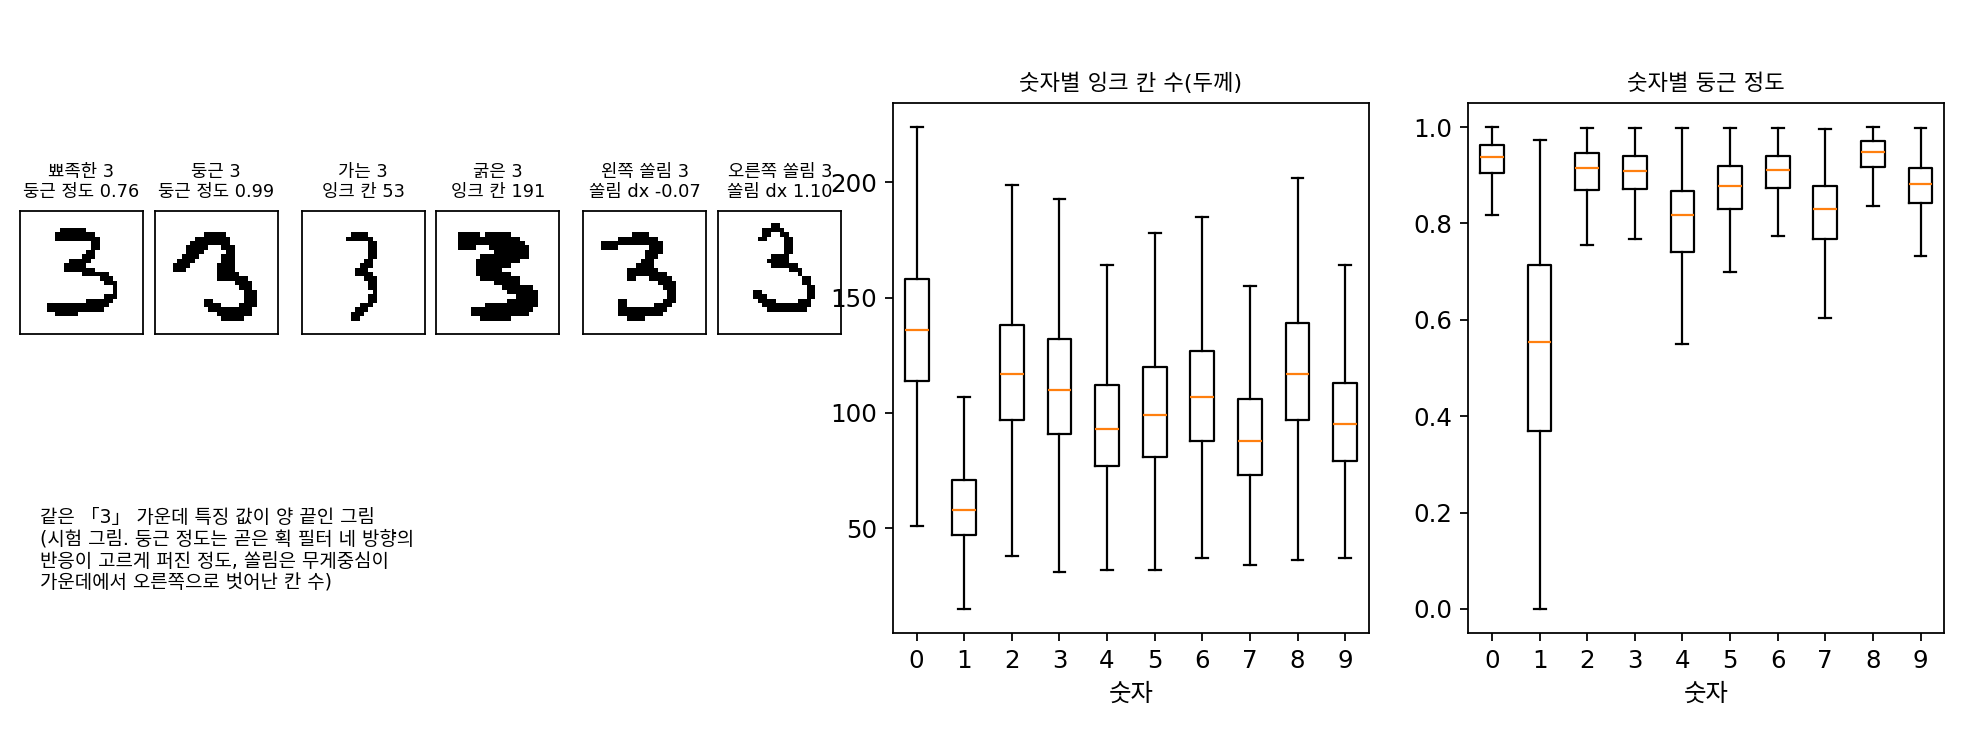
조건으로는 라벨에 스타일 넷(좌우 쏠림, 상하 쏠림, 두께, 둥근 정도)을 붙였다. 스타일은 각각 학습 그림을 네 구간으로 나눠 구간 번호로 준다. 조건이 몇 가지 값 가운데 하나여야 조건 값마다 학습 그림에서 얼마나 흔한지를 셀 수 있어서다. 라벨 10 × 스타일 4⁴ = 2,560가지 조건이 된다.
세 모델 비교하기
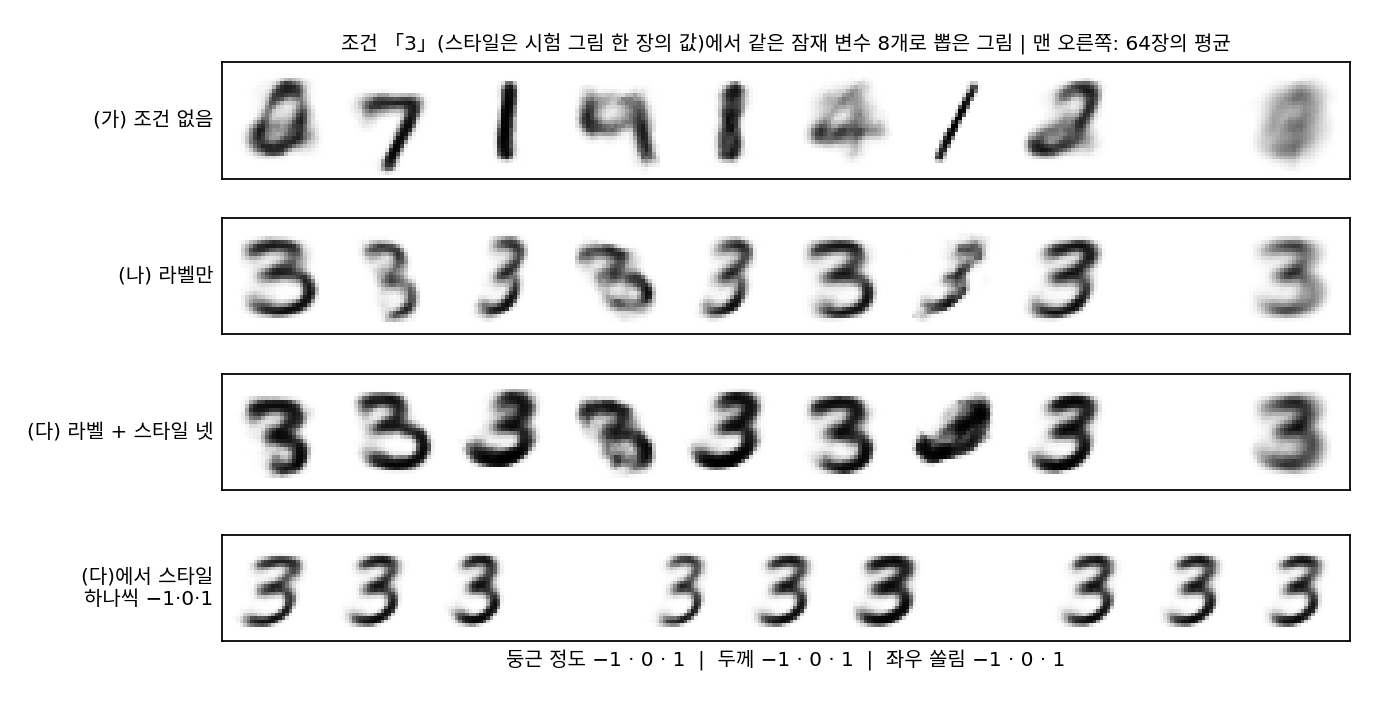
몸통·잠재 변수 2칸·학습 횟수가 같고 조건만 다른 세 모델을 비교했다. (가) 조건 없는 VAE, (나) 라벨만 받는 조건부 VAE, (다) 라벨과 스타일 넷을 받는 조건부 VAE. 시험 그림 1만 장의 조건으로 N(0, I)에서 잠재 변수를 하나씩 뽑아 그린 그림과, 시험 그림을 인코더에 넣었다 되살린 그림을 잰다.
| (가) 조건 없음 | (나) 라벨 | (다) 라벨 + 스타일 넷 | |
|---|---|---|---|
| 뽑은 그림의 회색 칸 | 18.6% | 15.7% | 13.6% |
| 조건의 라벨로 읽힘 | (조건 없음) | 99.7% | 98.9% |
| 같은 조건으로 16장 뽑았을 때 칸마다 표준편차의 평균 | 0.125 | 0.100 | 0.092 |
| 시험 그림을 되살린 제곱 거리 | 41.71 | 37.50 | 33.28 |
| 조건을 받은 ELBO (재구성 − KL) | −137.56 | −123.58 | −111.57 |
조건을 더 줄수록 회색 칸이 줄고, 되살린 그림이 원래 그림에 가까워지고, ELBO 가 오른다. 그런데 같은 조건에서 뽑은 16장의 칸마다 표준편차(그림의 다양성)도 함께 줄었고, 회색 칸은 13.6%에서 멈춰 있다.
문제 15. 칸마다 동전을 던지면 흐림이 사라질까
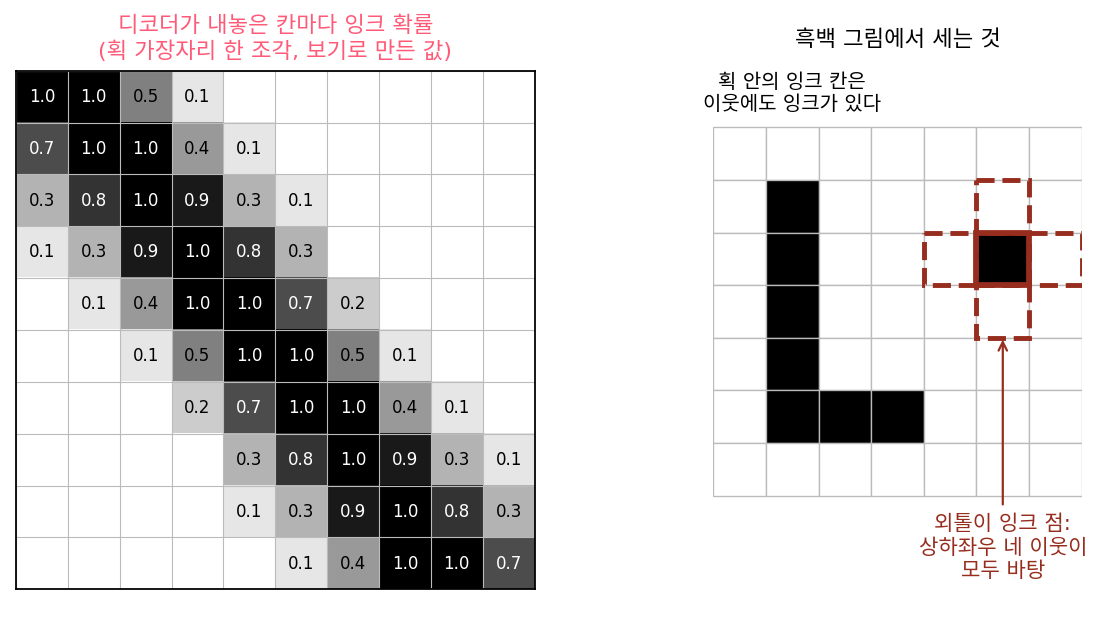
VAE가 뽑은 그림은 잉크 확률이라 흐릿하다. 그렇다면 디코더가 내놓은 확률대로 칸마다 동전을 던져 흑백 그림을 만들면 되지 않을까? 손글씨 VAE(잠재 변수 2칸)에서 N(0, I)로 잠재 변수 1만 개를 뽑아 그렇게 만든 그림과, 시험 그림을 비교한다. 상하좌우 네 이웃이 모두 바탕인 잉크 칸을 「외톨이 잉크 점」이라 하자. (가) 그림 한 장당 외톨이 잉크 점은 시험 그림에서 0.06개, 동전 그림에서 9.74개다(잉크 칸 수는 둘 다 한 장당 약 104개). 무엇이 달라졌는가? (나) 왜 이런 일이 생기는가? (다) 무엇을 바꾸어야 하는가?
동전을 던지면 칸마다 0 아니면 1이니까 회색이 없어지죠. 흐림 문제는 끝났네요.
잉크 칸 수는 비슷한데, 외톨이 점이 160배예요. 그림으로는 어때요?
획 둘레에 깨 뿌린 것 같은 점이 많고, 획 가운데도 구멍이 숭숭 났어요. 흐린 그림이 지저분한 그림으로 바뀌었을 뿐이에요.
실제 손글씨에서는 왜 외톨이 점이 거의 없을까요?
펜으로 그으니까요. 한 칸이 잉크면 그 옆 칸도 잉크일 가능성이 아주 커요. 칸들이 서로 맞춰서 움직여요.
그럼 디코더 쪽은 어때요? pθ(x ∣ z)를 어떤 형태로 정했는지 떠올려 봐요.
칸마다 따로 던지는 동전 784개의 곱이요. 어, 그러면 잠재 변수 z가 정해진 뒤에는 칸끼리 아무 관계가 없네요.
그래도 z가 획 자리를 정해 주면 되는 거 아냐?
잠재 변수 2칸이 「획이 어디를 지나는지」까지 다 정하지 못하면, 남은 불확실함은 칸마다 따로 던지는 동전으로밖에 나타낼 수 없어. 확률을 그리면 흐려지고, 동전을 던지면 칸마다 따로 튀고.
그거 절댓값 오차 문제랑 같아요! 라벨로 그림을 맞힐 때 칸마다 따로 중앙값을 고르면 획이 끊긴다던 거요. 칸들이 「이번엔 왼쪽 1」이라고 함께 정하는 장치가 없으니까요.
그래요. 잠재 변수를 16칸으로 늘려도 회색 칸이 8.6% 남았어요. 잠재 변수가 늘면 남은 불확실함이 줄지만 없어지지는 않아요. (다)는 이 장에서 바로 답할 수 없어요. 칸들이 서로 맞춰 움직이는 그림의 분포를, 동전 784개의 곱이 아닌 다른 형태로 적어야 해요.
「각 좌표의 주변분포가 맞는다고 결합분포가 맞는 건 아니다」는 말이 바로 이 그림이네요.
문제 16. 뾰족한 3과 둥근 3을 알려 주면
위의 세 모델을 두고 토론하려고, 학습 그림으로 잰 값을 아래에 모았다. 「조건만 아는 가장 좋은 디코더」는 조건이 같은 학습 그림들의 칸마다 잉크 비율을 그대로 내놓는 디코더이고(잠재 변수 없음), 그 재구성은 시험 그림으로 잰 평균 로그 확률이다. 「조건의 로그 확률」은 학습 그림에서 그 조건(라벨, 또는 라벨과 스타일 구간)이 나온 비율의 로그를 시험 그림마다 평균 낸 값이다.
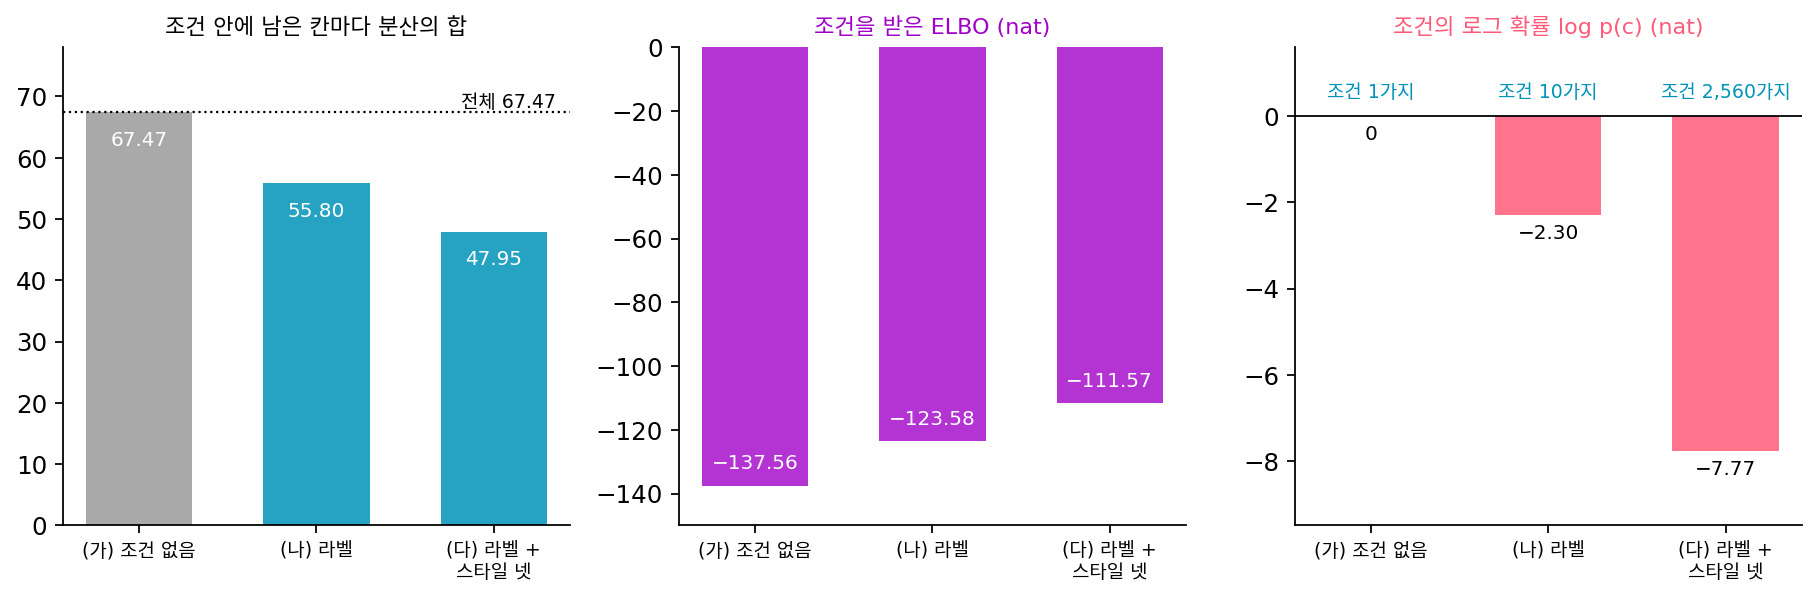
(가) 조건 없음 (나) 라벨 (다) 라벨 + 스타일 넷 조건 안에 남은 칸마다 분산의 합 (전체 67.47) 67.47 55.80 47.95 조건만 아는 가장 좋은 디코더의 재구성 (nat) −205.9 −169.8 −169.4 조건의 로그 확률 log p(c) (nat) 0 −2.30 −7.77 조건을 받은 ELBO (nat) −137.56 −123.58 −111.57 (가) 조건을 세밀하게 주면 VAE 그림이 선명해지는가? (나) (다)의 ELBO가 (가)보다 26 nat 높다. 두 값은 같은 것을 잰 것인가? (다) 그렇다면 조건을 한없이 잘게 나누면 되는가? (라) 둥근 정도를 재려고 우리는 곧은 획 필터 네 개를 손으로 골랐다. 이 실험에서 아쉬운 점은 무엇인가?
(가)는 표만 보면 「된다」 같지만, 나는 「조금만 된다」에 걸게. 회색 칸이 18.6%, 15.7%, 13.6%로 줄긴 해도 흑백 그림의 0%와는 한참 멀어. 위젯에서 같은 조건으로 잠재 변수 여덟 개를 넣은 평균은 29.5%, 26.0%, 23.0%로 여전히 뿌옇고.
나는 「된다」에 걸래. 위젯 6에서 라벨 3에 둥근 정도만 올려도 3이 동그래지잖아. 조건을 많이 줄수록 남는 후보가 줄어서 평균이 덜 흐려지는 거지.
그래도 디코더가 칸마다 따로 던지는 동전이라는 건 그대로잖아. 앞 문제에서 본 것처럼, 잠재 변수와 조건이 정해진 뒤에 남은 불확실함은 칸마다 따로 퍼질 수밖에 없어.
둘 다 숫자가 있으니 좋아요. 그 남은 불확실함이 얼마나 되는지를 먼저 재 봐요. 첫 줄은 무엇을 잰 거예요?
코드로 해 보니까 이래요. 학습 그림 전체의 칸마다 분산을 더하면 67.47이에요. 라벨별로 묶어 묶음 안의 분산을 평균 내면 55.80이고요.
두 값의 차는 어디로 간 거예요?
음… 묶음마다 평균 그림이 다르니까, 그 평균 그림끼리의 분산이요? 따로 재 보니 11.67이라 딱 맞아요. 전체 분산 = 조건 안 분산의 평균 + 조건별 평균의 분산이네요.
전체 분산을 라벨이 정하는 분산과 라벨 안에 남는 분산으로 나눴던 그 셈이네. 흑백 그림이라 숫자만 달라.
그 55.80은 라벨만 아는 신경망에게 무슨 뜻이에요? 제곱 오차로 아무리 잘 배우면 무엇을 내놓죠?
라벨 3을 받으면 3인 그림들의 평균… 아, 라벨별 평균 그림밖에 못 내놓으니까 55.80만큼은 꼭 틀리겠네요. 스타일 칸까지 나누면 꼭 틀리는 오차의 하한(조건 안에 남은 분산)이 47.95로 내려가고요.
그럼 조건을 주는 건 그 하한을 낮추는 일이네. 0까지는 못 내리고.
응. 그래서 (가)의 답은 「조건 안에 남은 분산이 줄어드는 만큼만 선명해진다」야. 민준이랑 내가 둘 다 반만 맞았네.
그럼 (나)는 쉬워요. 조건을 주니까 ELBO가 −137.56에서 −111.57로 26 nat나 올랐어요. 조건부 VAE 가 그림을 훨씬 잘 설명하는 모델이에요.
(다)의 ELBO는 무엇의 하한이었죠? 그림 x의 로그 확률이에요?
어… 조건 c를 받은 뒤의 log pθ(x ∣ c)의 하한이에요. 조건은 공짜로 받았고요. 그림을 처음부터 뽑으려면 조건부터 골라야 하는데, 조건을 고르는 확률은 안 셌어요.
그럼 (가)의 조건 없는 모델과 공정하게 비교하려면 어떻게 해야 할까요?
조건을 고르는 단계요. 조건을 비율 p(c)대로 고른 다음 그 조건의 그림을 그리는 모델이라고 보면… 그 모델이 x에 주는 확률은 p(c)pθ(x ∣ c)보다 작지 않겠네요.
그럼 로그로는 log p(c)를 더하는 거네. 그건 표 셋째 줄에 있어. (나)는 −123.58 − 2.30 = −125.88, (다)는 −111.57 − 7.77 = −119.34.
어, 26 nat가 아니라 18 nat쯤이네. 그래도 오르긴 올랐어.
왜 올랐을까요? 조건이라는 것을 모델 쪽에서 보면 무엇이에요?
조건을 고르는 것도 「먼저 무언가를 뽑고 그다음에 그림을 그린다」는 거니까, 잠재 변수를 하나 더 둔 것과 같아요. 2칸짜리 연속 잠재 변수에 10가지, 2,560가지짜리 이산 잠재 변수를 덧붙인 거고요. 단, 그 이산 잠재 변수의 값은 사람이 재서 정해 줬고요.
그럼 (다)는 되지 않을까요? 조건을 하나 더 붙일 때마다 조건부 분산의 기댓값은 줄어들기만 하잖아요. 끝까지 잘게 나누면 조건 안에 남은 분산이 0까지 내려갈 거고요.
둘째 줄을 봐요. 라벨에서 라벨 + 스타일로 갈 때 조건만 아는 디코더의 재구성은 얼마나 나아졌어요?
−169.8에서 −169.4… 0.4 nat요. 첫 줄에서는 분산이 55.80에서 47.95로 꽤 줄었는데요?
잠깐, 두 줄은 잰 그림이 달라. 첫 줄은 학습 그림 안에서 잰 거고, 둘째 줄은 칸 비율을 학습 그림으로 세고 시험 그림으로 잰 거야.
그게 왜? 2,560칸이면… 아, 칸마다 학습 그림이 평균 23장뿐이구나. 23장으로 낸 칸 평균은 처음 보는 시험 그림에 잘 안 맞겠다.
그럼 끝까지 잘게 나누면 어떻게 돼요? 칸 하나에 그림이 몇 장 남죠?
한 장이요. 그러면 조건 하나를 정하는 게 그림 한 장을 전부 정하는 일이 돼요. 셋째 줄의 log p(c) 도 벌써 −2.30에서 −7.77로 비싸졌는데, 끝에는 조건의 로그 확률이 그림 하나의 로그 확률만큼 비싸지겠네요.
같은 조건에서 뽑은 그림의 칸마다 표준편차도 0.125, 0.100, 0.092로 줄었어. 다양성도 같이 사라지는 거야.
그래요. 조건은 공짜가 아니에요. 조건 안에 남은 분산을 낮춘 만큼 log p(c)로 값을 치르고, 조건 값을 누가 정해 줘야 해요. (라)는요?
둥근 정도 필터요. 가로·세로·대각선 네 개를 우리가 골랐는데, 그게 숫자를 가르는 데 정말 좋은 필터인지는 몰라요. 쏠림은 MNIST 가 이미 가운데 맞춰 놔서 거의 쓸모가 없었고요. 어떤 필터가 쓸모 있는지를 사람이 정하지 않고, 라벨 없이 데이터에서 저절로 찾을 수는 없을까요?
좋은 물음이에요. 필터의 숫자 자체를 학습으로 정하는 신경망이 있어요. 합성곱 필터를 층마다 배우는 합성곱 신경망이고, 그것을 여러 해상도로 내려갔다 올라오게 쌓은 것이 U-Net 이에요. 이 장의 MLP 는 784칸을 한 줄로 늘어놓고 다뤘지만, 그 신경망들은 그림이 2차원으로 이웃한다는 사실을 처음부터 이용해요.