재파라미터화: 뽑기를 거쳐 미분하기
VAE의 손실에는 「인코더 분포 qφ(z ∣ x)에서 잠재 변수를 하나 뽑는다」는 단계가 들어 있다. 손실을 줄이려면 인코더의 파라미터 φ로 손실을 미분해야 하는데, 역전파가 뽑기 단계를 어떻게 지나갈까? 실제로 코드에서 z = torch.normal(mu, sd) 처럼 그 분포에서 바로 뽑으면 mu 와 sd 에는 그래디언트가 흐르지 않는다. 주사위를 던진 결과를 주사위의 무게중심으로 미분할 수는 없는 것처럼 보인다.
한계 ②에서 바란 것은 무작위 요소를 쉽게 정의하는 것이었고, 새 그림을 뽑을 때의 무작위는 N(0, I) 하나로 정했다. 그런데 학습 안의 무작위는 그림마다 다른 인코더 분포, 곧 인코더의 파라미터에 따라 모양이 바뀌는 분포에서 뽑는다. 이 무작위도 N(0, I)처럼 쉽게 정의된 형태로 다시 적을 수 있다면, 뽑기를 거쳐서도 미분이 지나가지 않을까?
장난감: 평균을 옮기면 결과가 어떻게 바뀌나
계산이 손으로 되는 가장 작은 경우로 보자. 잠재 변수 하나가 정규분포 N(μ, σ²)에서 뽑히고, 손실은 f(z) = (z − 3)²이라 하자. 평균 손실은 E[(z − 3)²] = (μ − 3)² + σ²이라 μ로 미분하면 2(μ − 3)이고, μ = 1, σ = 1이면 −4다. 이 −4를 샘플만으로 추정하고 싶다.
뽑기를 둘로 나눠 적어 보자. 먼저 파라미터와 상관없는 표준정규 노이즈 ε(엡실론)을 뽑고, 그다음 그것을 늘이고 옮긴다.
무작위는 ε 하나에 몰리고, μ와 σ는 보통의 덧셈과 곱셈으로만 z에 들어가므로, 평균을 내는 분포가 파라미터와 상관없어져 미분을 기댓값 안으로 넣을 수 있다. 뽑기를 「파라미터와 상관없는 노이즈 + 파라미터로 미분되는 변환」으로 바꿔 쓰는 이 방법을 재파라미터화 (무작위를 바깥으로 빼내 미분이 지나가게 하는 바꿔 쓰기 / reparameterization trick)라 한다. 킹마와 웰링이 이 이름을 붙였다.
로그 미분과 비교하기
뽑기를 거쳐 미분하는 방법은 하나 더 있다. 분포의 로그 확률을 파라미터로 미분해 손실에 곱하는 방법이다(로그 미분, 또는 스코어 함수 추정). 로그 미분은 f를 미분하지 않아도 되고 z가 띄엄띄엄한 값이어도 쓸 수 있어서, 윌리엄스(Ronald Williams)가 1992년에 강화학습의 REINFORCE 알고리즘으로 정리한 뒤 널리 쓰였다. 같은 −4를 재파라미터화와 로그 미분으로 샘플 하나씩 추정해 보자.
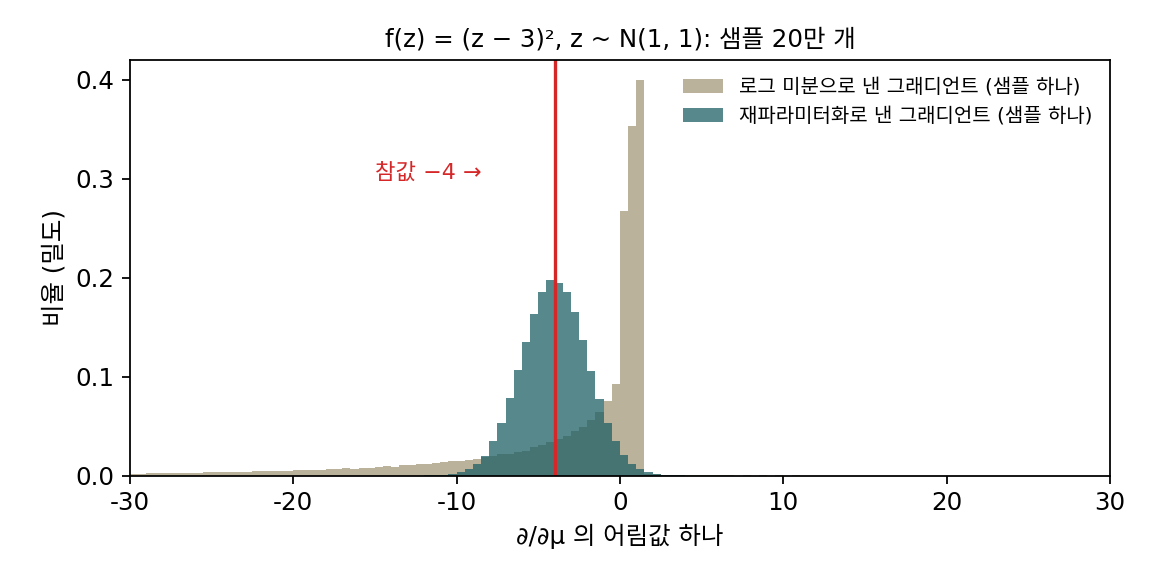
둘 다 평균은 맞고, 차이는 추정값의 표준편차에 있다. 샘플 하나의 표준편차가 재파라미터화는 2.00, 로그 미분은 9.34이고, 샘플 100개를 평균 내도 0.200 대 0.934다. 로그 미분으로 재파라미터화만큼 정확하게 추정하려면 샘플이 (9.34 / 2.00)² ≈ 22배 필요하다. 재파라미터화가 f의 미분값 f′(z)라는 정보를 더 쓰기 때문이다. 로그 미분은 「이 샘플의 손실이 컸는가 작았는가」만 보고, 재파라미터화는 「z를 조금 옮기면 손실이 어느 쪽으로 바뀌는가」까지 본다.
ML에서: 코드 한 줄
VAE 코드에서 재파라미터화는 한 줄이다: z = mu + torch.exp(0.5 * logvar) * torch.randn_like(mu). 표준편차는 늘 양수여야 하는데 신경망 출력은 음수도 될 수 있기 때문에, 인코더는 표준편차 대신 로그 분산(logvar)을 내놓고 그 로그 분산을 지수에 넣어 양수로 바꾼다. 「평균 + 크기 × 표준정규 노이즈」이라는 이 형태는 이 책에서 그림에 노이즈를 섞을 때마다 다시 나온다.
문제 9. 버스 시간표를 옮기면
아침 버스는 시간표상 8시 50분에 정류장에 오지만, 실제 도착은 시간표에 「지연의 크기 4분 × 그날의 표준 지연」을 더한 시각이다. 닷새 동안의 표준 지연은 −0.5, 0.2, 1.5, −1.0, 0.8이었고, 시각은 9시를 0으로 놓고 분 단위로 잰다. (가) 닷새의 도착 시각과 평균은? (나) 시간표를 1분 늦추면 닷새 평균 도착은 얼마나 바뀌는가? (다) 지연의 크기를 4분에서 5분으로 키우면 날마다 도착이 얼마나 바뀌는가? 닷새 평균은?
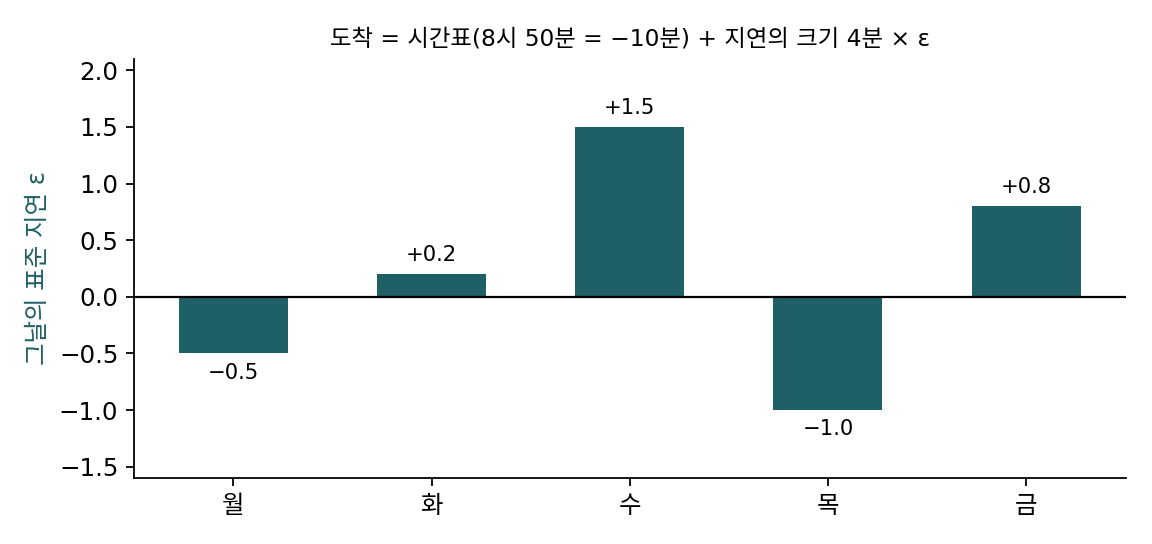
도착은 −10 + 4 × (표준 지연)이니까 −12, −9.2, −4, −14, −6.8분이고 평균은 −9.2분이에요. 9시 9분 전이요.
(나)는요?
날마다 1분씩 늦어지니까 평균도 1분이요. 쉽네요.
(다)는 버스가 날마다 다르게 늦으니까, 지연의 크기를 바꾸면 무슨 일이 생길지 다시 시뮬레이션을 돌려 봐야 하지 않아?
같은 닷새를 다시 산다고 생각해 봐요. 그날그날의 표준 지연은 그대로 두고요.
아, 표준 지연이 그대로면 도착은 −10 + 5 × (표준 지연)이라서, 날마다 바뀌는 양이 그날의 표준 지연이에요. −0.5, 0.2, 1.5, −1.0, 0.8분. 평균은 0.2분이에요. 다시 뽑을 필요가 없네요.
날마다의 운은 고정해 두고, 시간표와 지연의 크기가 운에 어떻게 곱해지고 더해지는지만 보면 되는 거구나. z = μ + σε에서 ε가 그날의 표준 지연이네요.
문제 10. 표준편차로 미분하기
z ~ N(μ, σ²)이고 손실이 z²이다. (가) 재파라미터화로 ∂E[z²]/∂σ를 구하고, E[z²] = μ² + σ²을 직접 미분한 값과 비교하라. (나) μ = 0, σ = 1에서 샘플 하나로 낸 추정값의 분산을 재파라미터화와 로그 미분으로 각각 구하라. 로그 미분의 추정값은 z² × ∂ log q/∂σ = ε²(ε² − 1)이다(σ = 1).
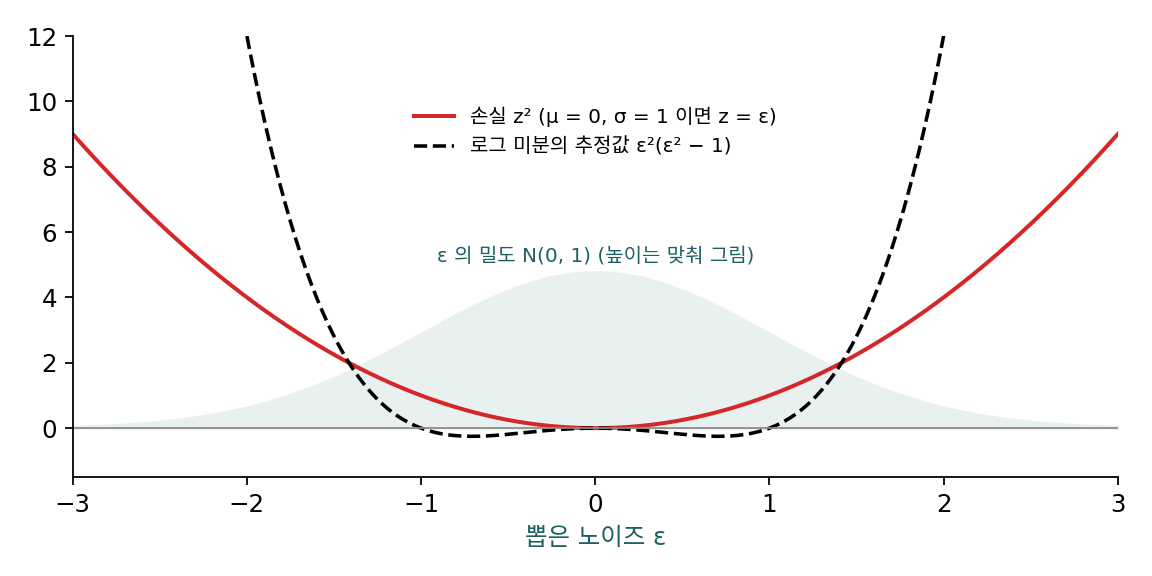
z² = (μ + σε)²을 σ로 미분하면 2(μ + σε)ε이고, 평균을 내면 E[ε] = 0, E[ε²] = 1이라 2σ예요. 직접 미분해도 2σ. 같아요.
(나)는 백만 개 뽑아서 확인해도 되고, 손으로도 돼요.
백만 개로 해 봤어요. 재파라미터화는 평균 1.996, 분산 7.99이고, 로그 미분은 평균 1.994, 분산 74.19예요. 둘 다 평균은 2인데 분산이 아홉 배 넘게 차이 나요.
손으로도 맞네. 재파라미터화 추정값은 2ε²라서 분산이 4 × Var(ε²) = 4 × 2 = 8이야. 로그 미분은 ε⁶까지 들어가서 E[ε⁸ − 2ε⁶ + ε⁴] − 2² = 105 − 30 + 3 − 4 = 74. 정규분포의 높은 차수 모멘트가 분산을 키우는구나.
그 차수가 어디서 왔는지 보면, 로그 미분은 손실 값 z² 전체를 곱하고 있어요. 손실이 큰 샘플 하나가 추정값을 크게 흔들어요.
문제 11. 잠재 변수가 동전이라면
잠재 변수가 연속인 값 대신 동전 하나라고 하자. 인코더는 앞면 확률 π를 내놓고, 잠재 변수는 z = 1(앞면) 또는 0(뒷면)이다. 재파라미터화를 흉내 내어 「파라미터와 상관없는 노이즈 u ~ 고른분포(0, 1)을 먼저 뽑고 z = [u < π]」로 쓴다. (가) π = 0.3일 때 u 열 개(같은 u)로 z를 만들고, π = 0.31로 조금 올려 다시 만들면 z는 어떻게 바뀌는가? (나) 이 식으로 ∂z/∂π를 구하면? (다) 재파라미터화가 통하려면 어떤 조건이 필요한가?
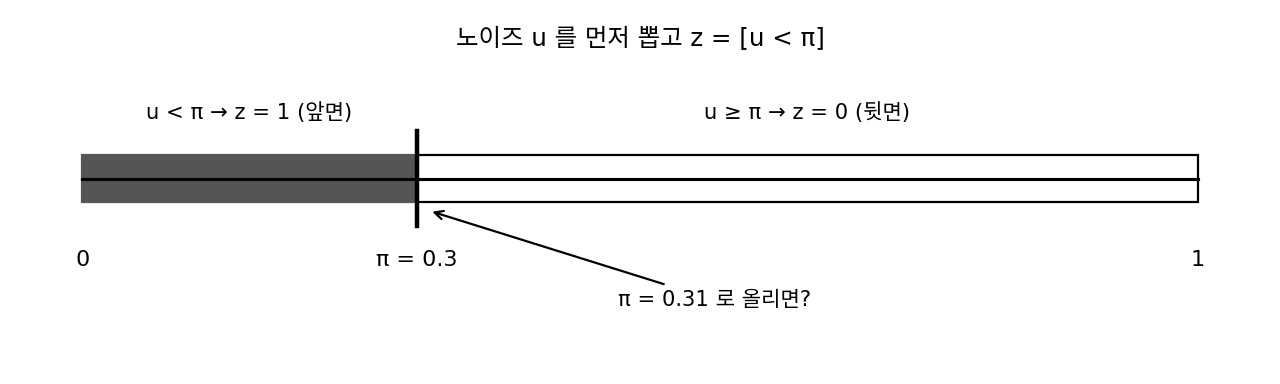
같은 u 열 개로 해 봤는데, π = 0.3에서 0, 0, 1, 0, 0, 0, 0, 0, 0, 1이고 π = 0.31에서도 똑같아요. 하나도 안 바뀌었어요.
그럼 (나)는요?
거의 모든 u에서 π를 조금 바꿔도 z가 그대로니까 0이요. u가 정확히 π인 곳에서만 0에서 1로 뛰고요. 그래디언트가 0이면 인코더는 아무것도 못 배우잖아요.
바꿔 쓰기는 됐는데 미분이 안 지나가. 버스 문제에서는 시간표를 1분 옮기면 도착도 1분 옮겨 갔는데, 동전은 확률을 조금 옮겨도 결과가 뛰기 전까지는 꿈쩍도 안 해.
(다)는요?
z가 파라미터에 대해 매끄럽게, 미분할 수 있게 움직여야 해요. 그리고 손실도 z로 미분할 수 있어야 하고요. 연속인 잠재 변수와 미분되는 디코더가 두 조건을 채워서 VAE에서는 통했던 거예요. 동전처럼 띄엄띄엄한 잠재 변수에는 로그 미분 같은 다른 방법이 필요하고요.
0.1 kg 단위로만 보여 주는 체중계랑 같네요. 50 g 쪄도 숫자가 안 바뀌다가 어느 순간 0.1이 뛰니까, 조금씩 바뀐 걸 숫자로는 알 수가 없어요. 몸무게가 π, 체중계에 뜨는 숫자가 z 예요.