인코더 분포: 점 하나를 정규분포로 넓히기
한계 ①을 풀 생각은 앞 절의 마지막 문제에서 나왔다. 디코더가 학습 그림의 잠재 변수에서만 배웠으니 그 둘레도 같은 그림으로 배우게 하자. 그러려면 학습할 때 잠재 변수를 점 하나로 넣지 말고, 점 둘레의 작은 범위에서 그때그때 하나씩 뽑아 넣으면 되는데, 그러려면 인코더가 그림마다 점 대신 분포를 내놓아야 한다.
여기서 처음 보는 사람은 두 번 멈칫하는데, 첫째는 인코더가 분포를 내놓는다는 게 무슨 뜻이냐는 것이다. 그림 한 장은 784칸의 밝기로 딱 정해진 것인데, 거기에 왜 분포가 필요할까? 게다가 학습 도중에 무작위로 뽑는 단계까지 끼어들어, 오토인코더라면 같은 그림에 늘 같은 잠재 변수가 나왔을 텐데 이제는 넣을 때마다 다른 잠재 변수가 나온다. 「인코더가 분포를 내놓는다」는 물음은 이미 아는 것에서 출발하면 풀리는데, 오토인코더가 내놓던 점 하나도 사실은 분포였다.
점 하나도 분포다
분포는 「어느 값이 얼마의 확률로 나오는가」를 적은 것이다. 보통 주사위는 1부터 6까지에 1/6씩을 주고, 늘 6만 나오게 조작한 주사위는 6에 확률 1, 나머지에 0을 준다. 조작한 주사위의 확률표도 분포는 분포인데, 다만 모든 확률이 한 값에 몰려 있어서 던질 때마다 같은 값이 나올 뿐이다.
값이 연속일 때도 같아서, 모든 확률이 한 점 a에 몰린 분포를 디랙 델타(분포)라 한다. 물리학자 디랙(Paul Dirac)이 1927년 양자역학 논문에서 이 기호를 들여왔고, 1930년 그의 교과서로 널리 퍼졌다. 확률 밀도로 그리면 폭이 0인데 아래 넓이가 1이라 키가 끝없이 높은 뾰족한 막대다. 평균이 a인 정규분포 N(a, σ²)의 표준편차 σ를 0으로 줄여 가면 종 모양이 좁고 높아지다가 디랙 델타의 막대가 된다.
이 말로 오토인코더를 다시 읽으면, 인코더는 그림 x를 받아 잠재 변수 z에 확률 1을 몰아 준 디랙 델타를 내놓았다. 디코더가 되살린 그림도 784개의 숫자로 된 784차원 그림 공간의 점 하나이므로, 그림 공간의 점 하나가 잠재 공간의 점 하나로 갔다가 그림 공간의 점 하나로 돌아온 것이다.
디랙 델타를 넓히면
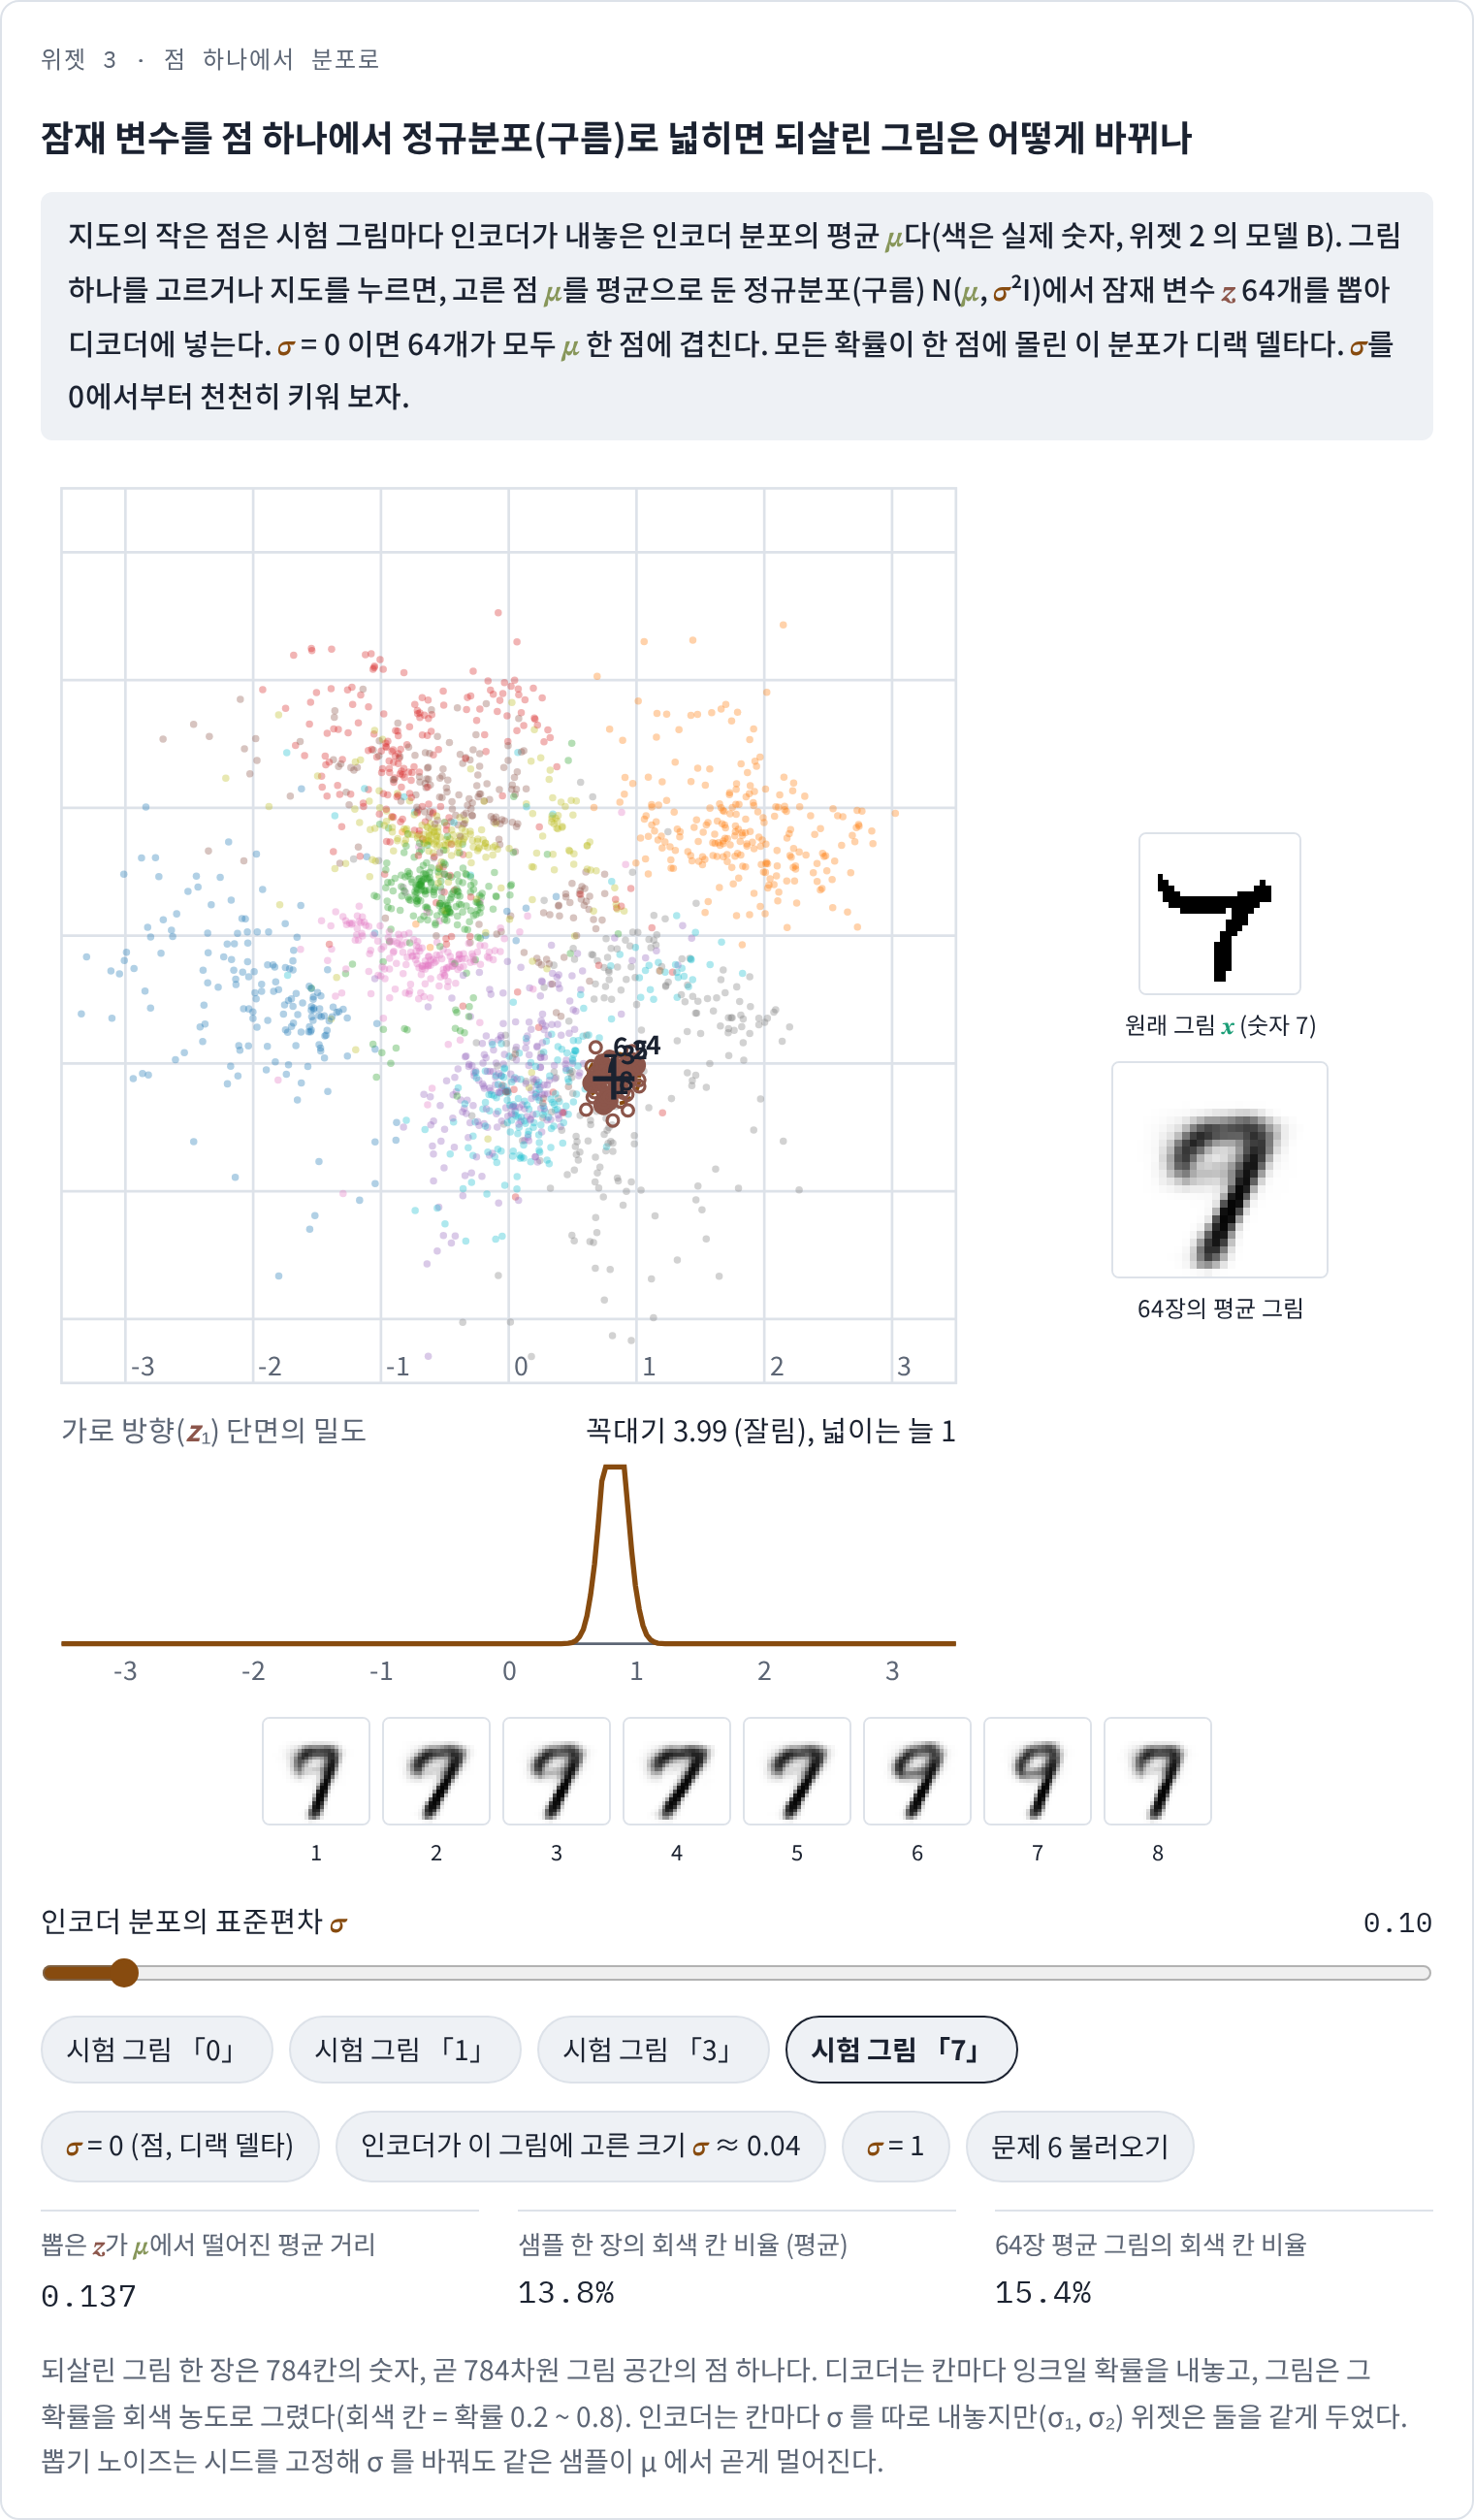
이제 디랙 델타를 조금 넓혀 보자. 모든 확률을 점 μ(뮤) 한 곳에 몰지 않고, μ를 가운데 두고 표준편차 σ(시그마)만큼 퍼진 정규분포 N(μ, σ²I)에 나눠 준다. σ = 0이면 다시 디랙 델타이고, σ를 키우면 μ 둘레의 잠재 변수들도 함께 뽑힌다. 뽑힌 잠재 변수 하나하나를 디코더에 넣으면 그림이 한 장씩 나오므로, 잠재 공간의 정규분포 하나가 디코더를 지나 그림 공간에서는 비슷한 그림들의 분포가 되는 것이다.
아래 위젯은 앞 절의 모델 B 지도 위에서 디랙 델타를 넓혀 본다. 그림 하나의 잠재 변수 μ를 고르고 σ를 0에서부터 키우면, 그 정규분포에서 뽑은 잠재 변수 64개를 되살린 그림 여덟 장과 64장의 평균 그림이 함께 바뀐다.
시험 그림 「3」 한 장으로 숫자를 읽어 보자. σ = 0이면 64개가 모두 한 점에 겹치고, 분류기는 64장을 모두 3으로 읽는다. 평균 그림은 그 한 장과 같은데, 디코더가 칸마다 확률을 내놓으니 한 장도 가장자리는 조금 회색이어서 회색 칸(잉크 확률 0.2 ~ 0.8)이 19.9%다. σ = 0.2이면 64장 가운데 45장만 3이고 5가 11장, 8이 7장, 2가 1장 섞인다. 평균 그림의 회색 칸은 23.5%로 늘었으며, σ = 1이면 3은 24장뿐이고 평균 그림의 회색 칸은 32.5%다. 그런데 뽑은 그림 한 장 한 장의 회색 칸은 그동안 19.9%, 21.5%, 19.2%로 20% 안팎에 머물렀다. 흐려진 것은 여러 그림을 겹친 평균이고 그림 한 장은 흐려지지 않았는데, 정규분포가 넓을수록 뜻이 다른 이웃 그림까지 함께 담기기 때문이다.
인코더가 분포를 내놓는다
그래서 이 방법의 인코더는 그림 한 장에 점 하나 대신 평균 벡터 μ 하나와 표준편차 σ를 내놓는다. 이 장의 모델은 잠재 변수 칸마다 σ를 따로 내놓아(σ₁, σ₂) 숫자가 넷인데, 이 한 쌍이 정규분포 하나를 정하고, 그 정규분포가 곧 그 그림의 잠재 표현이다. 오토인코더에서 임베딩(그림을 대신하는 벡터)이 점 z 하나였다면, 여기서는 정규분포 하나다. μ는 「이 그림은 지도의 어디쯤인가」를, σ는 「그 둘레 얼마까지를 이 그림으로 쳐도 되는가」를 적는다. 위의 「3」에 인코더가 내놓은 크기는 σ = (0.051, 0.048)이었다.
이제 학습 도중의 뽑기가 왜 들어오는지도 답할 수 있다. 디코더가 받는 것은 인코더 분포 전체가 아닌 잠재 변수 하나이므로, 인코더 분포 어디를 받아도 원래 그림을 되살리도록 가르치려면 학습할 때마다 인코더 분포에서 잠재 변수를 하나씩 뽑아 넣어 보는 수밖에 없다. 같은 그림을 넣어도 매번 다른 잠재 변수가 나오는 것은 인코더 분포 전체를 조금씩 나눠 가르치는 방법이다. 뽑는 단계를 거쳐 어떻게 미분하는지는 이 장의 뒤에서 다룬다.
남은 물음은 인코더 분포를 얼마나 넓게 잡느냐다. 너무 좁으면 점과 다를 바 없고, 너무 넓으면 위에서 본 것처럼 다른 숫자까지 담겨 평균이 흐려진다. 인코더 분포의 표준편차 σ 를 사람이 정하지 않고 인코더가 그림마다 정하게 한 것이 이 방법이다.
문제 3. 두 그림 사이에 놓인 인코더 분포
잠재 변수가 한 칸인 디코더가 z < 0이면 그림 A, z ≥ 0이면 그림 B를 내놓는다. 두 흑백 그림은 784칸 가운데 100칸만 다르다(A에서 잉크인 50칸이 B에서는 바탕이고, B에서 잉크인 다른 50칸이 A에서는 바탕이다). 인코더가 그림 B에 인코더 분포 N(μ, σ²)를 내놓는데 μ = 0.5다. (가) σ = 0, 0.5, 2일 때 인코더 분포에서 뽑은 잠재 변수가 그림 A를 부를 확률은 각각 얼마인가? (나) 각 경우 뽑은 그림들의 평균 그림에서, 두 그림이 다른 100칸의 잉크 확률은 얼마이고 회색 칸(0.2 ~ 0.8)은 몇 칸인가? (다) σ를 한없이 키우면 평균 그림은 어디로 가는가? 그때 μ는 무엇을 알려 주는가?
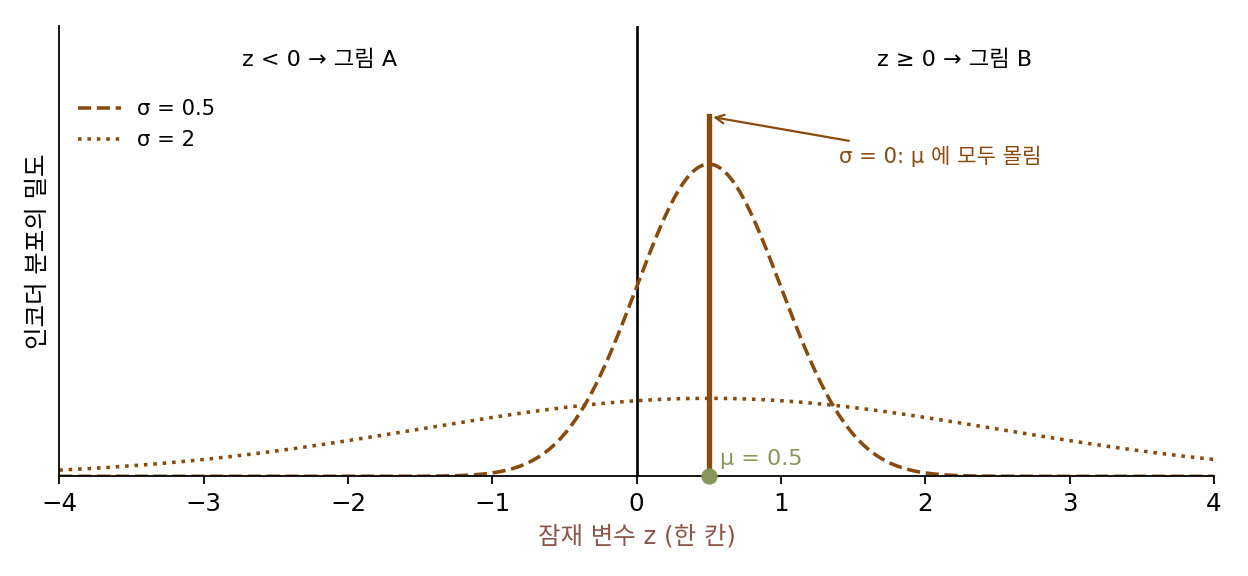
표준정규 누적분포 Φ(대문자 파이)로 쓰면 P(z < 0) = Φ(−μ/σ)예요. σ = 0.5면 Φ(−1) = 0.159, σ = 2면 Φ(−0.25) = 0.401. σ = 0은… 0으로 나누게 되네요.
σ = 0인 정규분포는 무엇이었죠?
0.5에 모든 확률이 몰린 디랙 델타요. 늘 0.5가 뽑히니까 A를 부를 확률은 0이에요. 공식에 넣기 전에 분포를 떠올렸어야 했네요.
(나)는 A에만 잉크인 50칸이 확률 P(A), B에만 잉크인 50칸이 1 − P(A)로 칠해지겠다. σ = 0이면 0과 1이라 회색 칸 0, σ = 0.5면 0.159와 0.841이라 아직 회색 칸 0, σ = 2면 0.401과 0.599라 100칸이 모두 회색이야.
σ = 0.5에서 회색 칸이 0이면 평균 그림이 흐려지지 않은 거야? 16%는 A가 섞였는데.
0.2 ~ 0.8이라는 잣대를 기억해요. 그 잣대로는 0이지만, 100칸의 확률이 0·1에서 0.16만큼 비켜 났어요. 흐림은 조금씩 번지다가 어느 순간 잣대를 넘어요. (다)는요?
σ를 끝없이 키우면 −μ/σ가 0으로 가니까 P(A)가 1/2이에요. μ가 0.5든 −0.5든 똑같이 반반 섞인 회색이고요.
분포가 너무 넓으면 μ가 아무것도 알려 주지 못하네요. 그림 B에서 왔는지 A에서 왔는지가 평균 그림에서 지워져요.
문제 4. 어느 그림의 인코더 분포가 먼저 섞이나
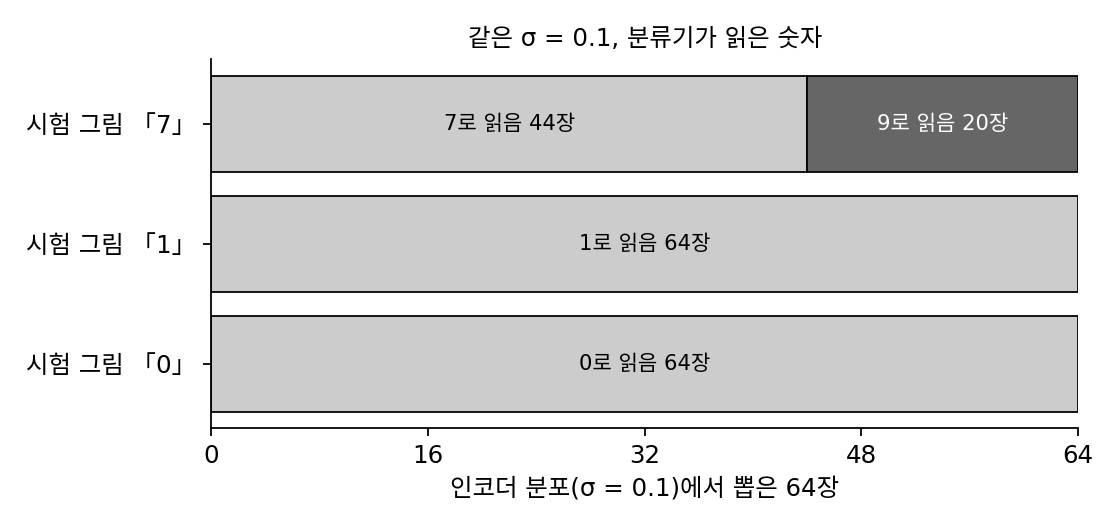
위젯 3에서 시험 그림 「7」을 고르고 σ를 0.1로 둔다(「문제 4 불러오기」). 64장 가운데 분류기는 44장을 7로, 20장을 9로 읽지만, 같은 σ = 0.1에서 「1」은 64장이 모두 1, 「0」도 모두 0이다. (가) 「7」의 인코더 분포에서 뽑은 그림이 왜 다른 숫자와 먼저 섞이는지 지도에서 찾아라. (나) 그렇다면 인코더 분포의 표준편차 σ를 모든 그림에 똑같이 정해 두면 무엇이 문제인가? (다) 인코더가 이 「7」에 고른 크기는 (0.037, 0.039), 「1」에는 (0.074, 0.035)였다. 무엇을 알 수 있는가?
지도에서 이 「7」의 자리 둘레부터 볼게. 7의 잠재 변수 무리 바로 왼쪽에 9와 4의 무리가 붙어 있어.
손으로 쓴 7과 9는 위쪽 고리만 다르니까 지도에서도 이웃이구나. 그럼 σ를 0.1만 넓혀도 9의 무리에 닿겠네. 1이나 0은 둘레의 다른 숫자가 멀어서 0.1로는 안 섞이고.
그럼 (나)는요? σ를 모든 그림에 하나로 정해 두면요?
7에 맞춰 좁게 잡으면 1은 둘레를 덜 배우고, 1에 맞춰 넓게 잡으면 7은 9와 섞여요. 어느 값으로 정해도 어떤 그림에는 너무 넓고 어떤 그림에는 너무 좁아요.
(다)의 숫자는 그 말과 맞아요?
숫자를 보면, 7은 두 칸 모두 0.04쯤으로 좁고, 1은 가로가 0.074로 두 배 넓어요. 다른 숫자가 가까운 7은 좁게, 둘레에 여유 있는 1은 넓게 잡았네요. 그래서 σ도 그림마다 인코더가 내놓게 한 거구나. 기숙사 방마다 침대를 같은 크기로 넣지 않고 방 넓이를 보고 고르는 거랑 비슷해요. 침대 크기가 σ, 방 넓이가 이웃 숫자까지의 거리고요.