유도 헤드: 동화만 읽은 루나에게는 생기지 않았다
1층 모델이 「oy」를 못 베낀 이유는 앞 위치마다 「내 앞 토큰이 무엇이었나」가 적혀 있지 않아서였다. 그렇다면 첫째 층의 헤드가 그것을 적어 두고 둘째 층의 헤드가 읽으면 될 텐데, 2층 모델을 타이니스토리즈로 학습하면 그런 두 헤드가 생길까? 생긴다면 언제 생길까?
역사: 손실 곡선의 혹
엘하지와 동료들은 2층 모델에서 바로 그런 헤드 쌍을 찾았고, 이듬해 2022년 3월 8일 캐서린 올슨(Catherine Olsson)과 동료들(넬슨 엘하지, 닐 난다 등, 교신 크리스 올라)이 「문맥 내 학습과 유도 헤드(In-context Learning and Induction Heads)」에서 그 헤드를 깊이 팠다. 그들이 부른 이름은 유도 헤드(induction head)였고, 하는 일은 지금 토큰이 앞에 나온 위치를 찾아가 그 바로 다음 토큰을 베끼는 것이었다. 「Harry Potter … Harry」 다음에 「Potter」를 쓰는 식이다. 두 헤드가 서로 다른 층에서 합성돼야 하므로 1층 모델에는 생기지 않는다.
그들이 더 놀란 것은 이 헤드가 생기는 때였다. 층이 둘 이상인 모델은 크기와 상관없이 학습 초기의 좁은 구간(그들의 설정에서는 대략 25억~50억 토큰을 본 무렵)에서 갑자기 유도 헤드가 생겼고, 같은 구간에서 학습 손실 곡선에 작은 혹(bump)이 솟았으며, 글 뒤쪽 토큰을 앞쪽 토큰보다 얼마나 잘 맞히는지를 잰 문맥 내 학습 점수도 함께 뛰었다. 1층 모델의 곡선에는 혹이 없었다. 저자들은 유도 헤드와 문맥 내 학습의 관계를 근거 여섯 가지로 따졌는데, 어텐션만 있는 작은 모델에서는 헤드를 지워 보는 실험으로 인과의 증거가 강하고 MLP 가 있는 큰 모델에서는 상관의 증거에 가깝다고 스스로 구분해 적었다.
무작위 토큰을 두 번 이어 붙인 글로 재기
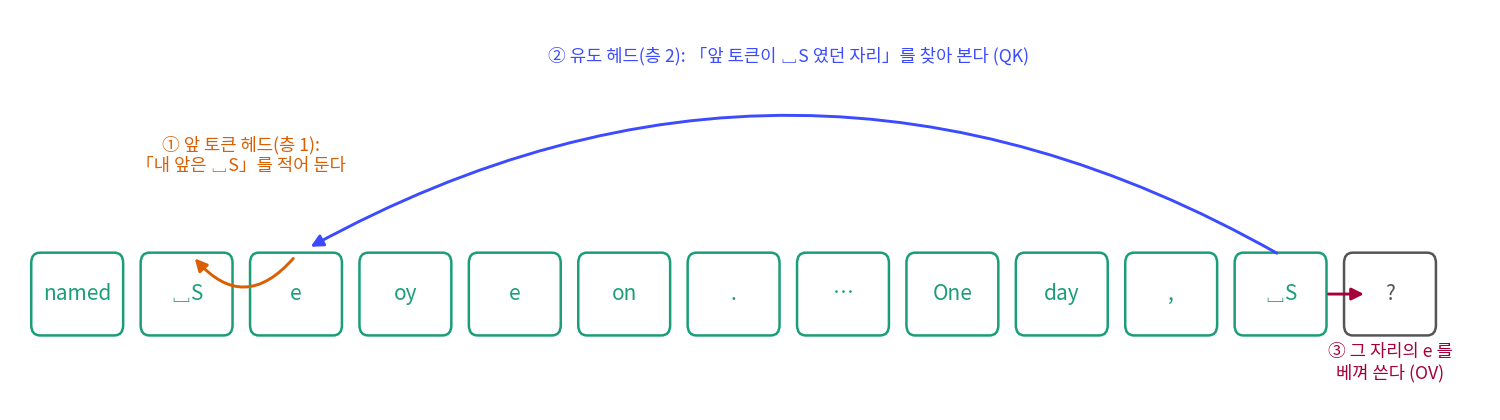
헤드 둘이 나눠 맡는 일을 그림으로 정리하면 이렇다. 첫째 층의 헤드는 위치마다 바로 앞 위치를 보고, 앞 토큰이 무엇이었는지를 자기 위치의 잔차 스트림에 적는다. 둘째 층의 헤드는 지금 토큰을 쿼리로 삼아 「앞 토큰이 지금 토큰과 같은 위치」를 찾아가고, 그 위치의 토큰을 OV 회로로 베낀다. 앞의 헤드를 앞 토큰 헤드(previous-token head), 뒤의 헤드를 유도 헤드라 부른다. 유도 헤드의 QK 회로가 읽는 것은 앞 토큰 헤드가 적어 둔 것이므로, 문제 2의 64개 항 가운데 바로 그 항이 쓰인다.
모델 안에 유도 헤드가 있는지는 어떻게 잴까? 자연 글에서는 앞을 베끼지 않아도 맞힐 수 있는 토큰이 많아서 헤드가 보탠 것을 가려내기 어렵다. 그래서 무작위 토큰 50개를 뽑아 두 번 이어 붙인 글을 넣는다. 처음 50개는 무작위라 어떤 모델도 맞힐 수 없고, 두 번째 50개는 앞을 베끼기만 하면 모두 맞힌다. 두 번째 절반의 위치 i 에서 헤드가 i − 49(첫 번째 절반에서 같은 토큰의 바로 다음 위치)에 준 어텐션 가중치를 평균한 것을 그 헤드의 유도 점수로 삼는다. 1이면 늘 베낄 위치만 보는 헤드다.
타이니스토리즈로 어텐션 전용 1층과 2층 모델을 10,000 스텝(8,192만 토큰) 학습하며 20~500 스텝마다 쟀다. 두 모델 모두 최고 유도 점수가 0.02 를 넘지 못했다. 2층이 1층보다 손실은 낮았지만(학습 손실 2.075 대 2.234), 무작위 반복 글의 두 번째 절반 손실은 12.343 으로 처음 절반 13.075 와 큰 차이가 없었다. 혹시 덜 학습해서일까 싶어 2층 모델을 60,000 스텝, 4억 9,150만 토큰까지 길게 학습했다.
1-2. 타이니스토리즈, 어텐션 전용 2층을 60,000 스텝 (스텝당 8,192 토큰)
[2층 긴 학습] 최고 유도 점수가 가장 가파르게 오른 구간: 스텝 5600 -> 5700 (0.014 -> 0.021) | 처음 0.1 이상: 없음 | 처음 0.3 이상: 없음 | 처음 0.5 이상: 없음
[2층 긴 학습] 마지막(스텝 60000): 최고 유도 점수 0.049, 무작위 반복 글 손실 처음 13.748 두 번째 12.910, 자연 글 반복 손실 처음 1.687 두 번째 1.606, 검증 손실 1.8790, 바이트당 비트 0.6847
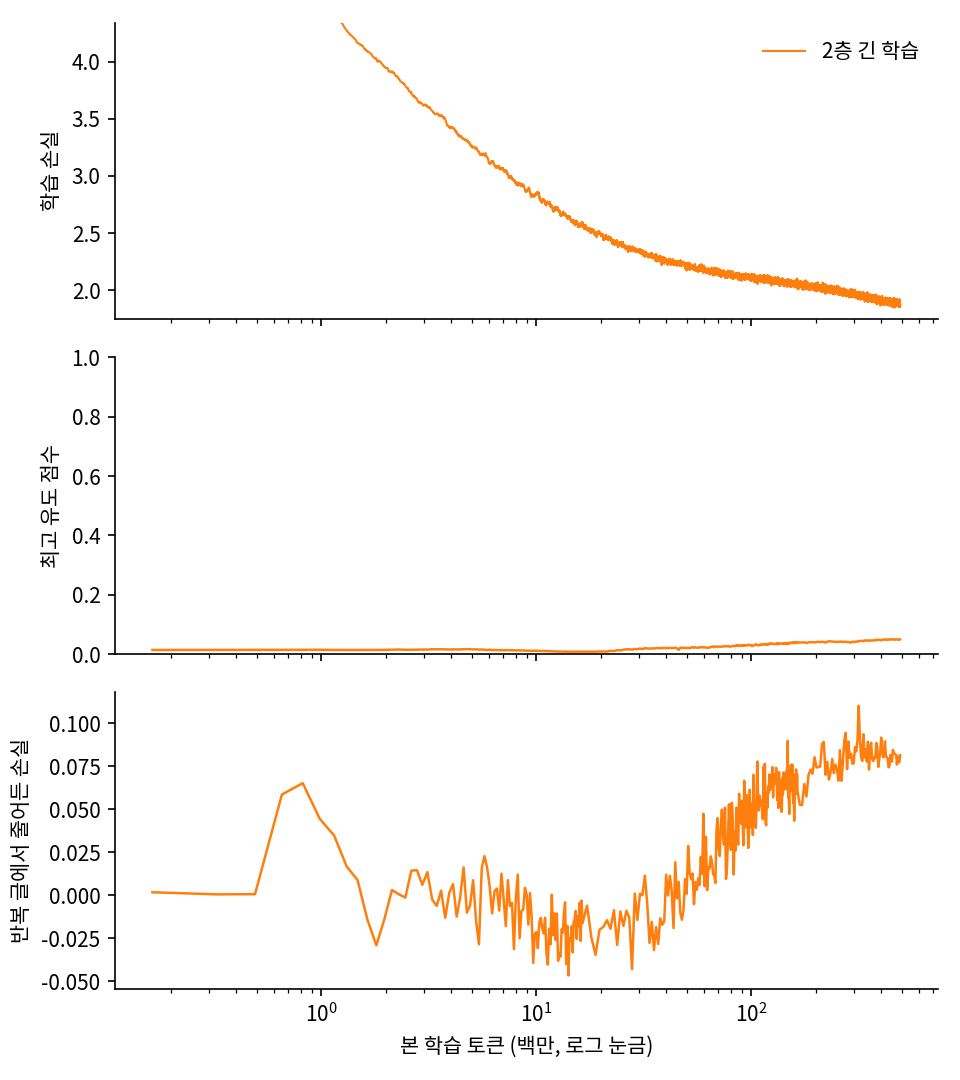
최고 유도 점수는 0.049 까지 천천히 올랐을 뿐 0.1 을 한 번도 넘지 않았고, 손실 곡선에도 혹이 없었다. 동화만 읽은 2층 모델에는 유도 헤드가 생기지 않았다.
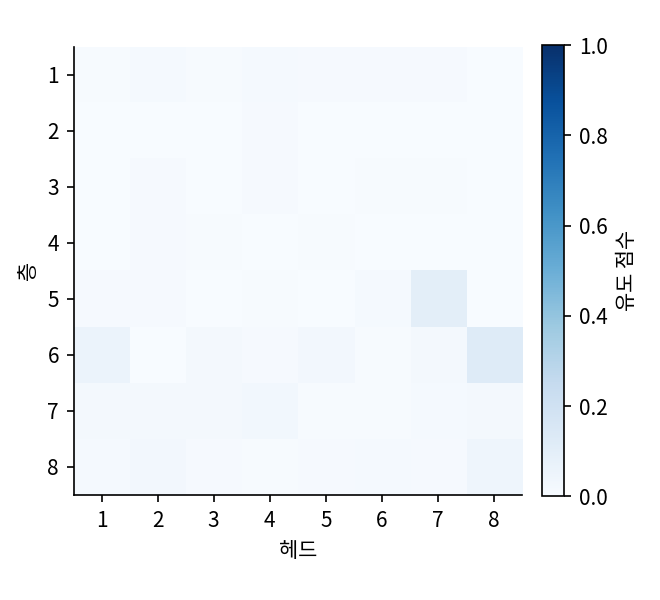
MLP 도 있고 헤드가 64개인, 동화를 쓰는 8층 GPT 는 어떨까? 체크포인트마다 재 보니 최고 유도 점수는 스텝 5,000 에서 0.128 까지 올랐다가 끝에 0.124 였고(층 6 헤드 8), 0.3 을 넘는 헤드는 끝까지 없었다. 이야기 한 토막(100 토큰)을 그대로 두 번 이어 붙여도 두 번째 손실이 1.123 으로 처음 1.112 보다 낮아지지 않았으니, 27.6M 모델도 방금 읽은 문단을 그대로 베끼지는 못한다. 그런데도 이름은 베낀다. 「Seoyeon」의 두 번째 「␣S」 위치에서 첫 번째 「e」를 가장 세게 본 헤드는 층 6 헤드 8(가중치 0.967), 「e」 위치에서 첫 번째 「oy」를 본 헤드는 층 5 헤드 7(0.990)로, 유도 점수가 가장 높은 두 헤드와 같았다.
앞에서 한 말을 기억하는 헤드가 아예 없는 건 아닌데, 이름 하나 베낄 만큼만 있는 거네. 그래서 Seoye 에서 끊기고.

동화에는 앞에 나온 걸 길게 베낄 일이 별로 없잖아. 이름도 거의 Lily, Tom 이고.
서연의 말은 하나의 가설이다. 타이니스토리즈의 이름은 대부분 토큰 하나라서, 앞에 나온 토큰 하나를 다시 쓰는 일은 1층의 건너뛴 세 토큰으로도 된다. 여러 토큰을 이어서 베껴야 맞힐 수 있는 자리가 드물면 유도 헤드를 만들 압력도 약할 것이다. 우리는 이 가설을 증명하지 않았고, 이야기 길이나 어휘 크기 같은 다른 차이가 원인일 수도 있다. 다만 가설이 맞다면 앞에 나온 것을 베껴야 맞힐 수 있는 글이 많은 데이터에서는 같은 모델에도 유도 헤드가 생겨야 한다.
문제 5. 무작위 토큰의 처음 절반 손실은 왜 균등 분포보다 나쁜가
어휘가 4,096 개일 때 모든 토큰에 같은 확률을 주는 모델의 손실은 ln 4096 = 8.318 nats 다. 그런데 타이니스토리즈로 학습한 어텐션 전용 2층 모델에 무작위 토큰 50개를 두 번 이은 글을 넣으면 처음 절반의 손실이 13.075(10,000 스텝), 13.748(60,000 스텝)이었다. 학습 전(스텝 0)에는 처음 절반 8.366 이었다. (가) 학습한 모델이 학습 전 모델보다 무작위 토큰을 더 못 맞히는 이유는 무엇인가? (나) 두 번째 절반을 완벽하게 베끼는 모델이라면 두 번째 절반의 손실은 얼마에 가까워야 하나? (다) 처음과 두 번째의 차이를 보는 대신 두 번째 절반 손실만 보면 무엇을 놓치나?

학습 전 8.366 은 ln 4096 이랑 거의 같아. 아무것도 모르니까 다 고르게 준 거지.
학습한 뒤에 더 나빠진 건 이상한데. 음, 손실은 정답 토큰에 준 확률의 −ln 이잖아. 13.075 면 정답에 준 확률이 e⁻¹³ 쯤, 균등한 1/4096 보다 백 배는 작은 거고.

학습한 모델은 다음 토큰에 확률을 고르게 줄까요?
아뇨, 동화에서 나올 만한 토큰에 몰아서 줘요. 「the」나 마침표에 큰 확률을 주니까, 무작위로 뽑힌 드문 토큰에는 균등보다 훨씬 작은 확률이 남아요. 자신 있게 틀리는 거예요.
그럼 (나)는 0 에 가까워야 해. 앞을 그대로 베끼면 정답에 확률 1 을 주니까. 2층 긴 학습은 12.910 이니까 거의 못 베끼는 거고.
(다)는 학습이 진행되면서 처음 절반 손실도 같이 변하잖아. 8.366 에서 13.748 로 오르는 동안 두 번째 절반 손실만 보면, 베끼는 능력이 생겼는지 동화 쪽으로 더 쏠렸는지 섞여 버려. 그래서 처음과 두 번째를 같이 봐야 하고, 헤드마다 어텐션 가중치를 직접 보는 유도 점수가 따로 필요한 거고.
문제 6. 「동화에는 베낄 일이 적다」는 가설을 어떻게 시험할까
타이니스토리즈 어텐션 전용 2층 모델에는 4억 9,150만 토큰을 학습해도 유도 헤드가 생기지 않았다(최고 유도 점수 0.049). 가설은 「동화의 이름은 대부분 토큰 하나라 1층의 건너뛴 세 토큰으로 충분하고, 여러 토큰을 이어서 베낄 자리가 드물어 유도 헤드를 만들 압력이 약하다」는 것이다. (가) 가설이 맞다면 2층 모델의 학습 손실이 1층보다 낮은 이유(2.075 대 2.234, 10,000 스텝)는 무엇으로 설명해야 하나? (나) 가설을 시험하려면 어떤 데이터로 같은 모델을 학습해 보면 되나? (다) 그 실험에서 유도 헤드가 생겨도 가설이 증명되었다고 할 수 없는 이유는?
(가)는 2층이 유도 헤드 말고 다른 데에 둘째 층을 쓴다고 봐야겠지. 1층 헤드들이 적어 둔 걸 읽는 64개 항이 베끼기만 하는 건 아니니까.
(나)는 앞에 나온 걸 길게 베껴야 맞힐 수 있는 글로 학습해 보면 돼. 코드나 웹 글. 웹 글엔 긴 이름, 주소, 같은 문장 반복이 많잖아.
그 실험에서 유도 헤드가 생겼다고 해 봐요. (다)는요?

웹 글로 바꾸면 베낄 자리만 바뀌는 게 아니에요. 어휘도, 글 길이도, 말투도 다 달라지니까 무엇 때문에 생겼는지 하나로 못 집어요. 「가설과 어긋나지 않는다」까지만 말할 수 있겠네요.
그래요. 원인을 하나로 좁히려면 동화에 이름만 여러 토큰짜리로 바꿔 넣는 식으로 한 가지만 바꾼 실험을 해야 해요. 우리는 그 실험까지는 하지 않았으니 책에도 가설로 남겨 둬요.
웹 글 실험은 지금 바로 할 수 있어. nanochat 이 받아 둔 웹 글 조각이 있거든.