어텐션 헤드: 어디를 볼지(QK)와 무엇을 옮길지(OV)
잔차 스트림에 무언가를 옮겨 오는 것은 어텐션 헤드다. 헤드는 다른 위치의 잔차 스트림을 읽어 지금 위치에 더해 쓰는데, 이 일에는 두 가지 결정이 들어 있다. 어느 위치를 읽을지와, 읽은 위치에서 무엇을 가져올지다. 둘을 하나로 묶어 보면 헤드가 무슨 일을 하는지 말하기 어렵지만, 나눠 보면 각각을 따로 읽을 수 있지 않을까?
쿼리·키로 고르고, 값으로 옮긴다
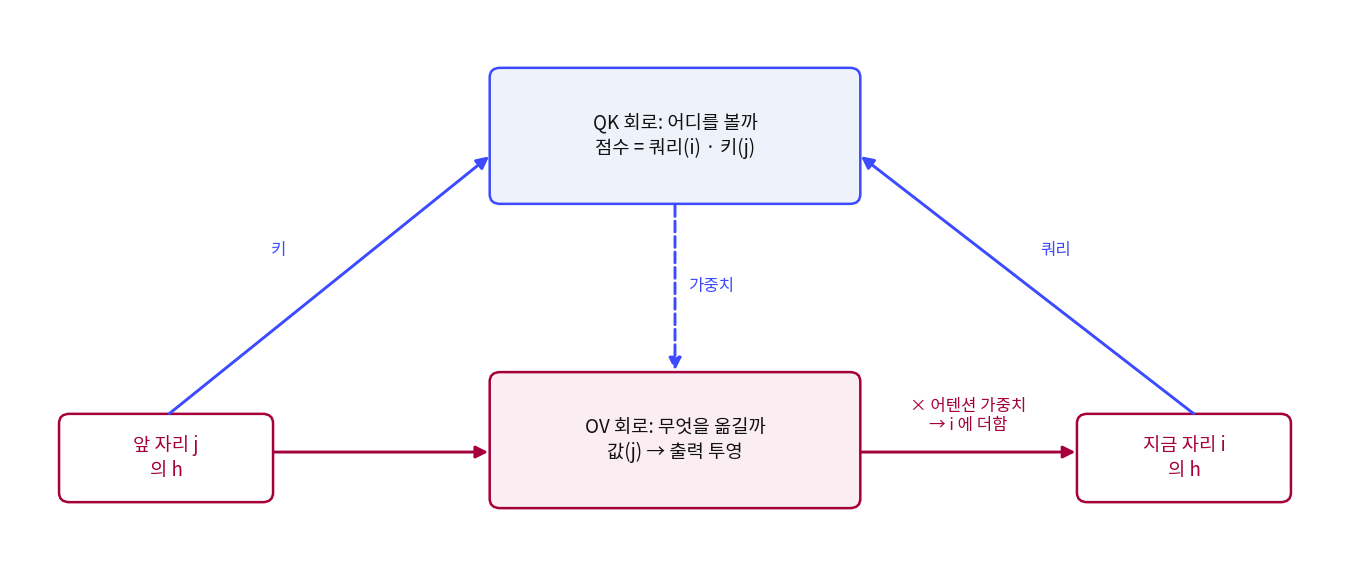
헤드는 지금 위치 i 의 잔차 스트림에서 쿼리를, 앞 위치 j 의 잔차 스트림에서 키와 값을 만든다. 쿼리와 키의 내적이 위치 j 를 얼마나 볼지 정하는 점수가 되고, 점수에 softmax 를 씌운 어텐션 가중치로 값들을 섞은 뒤 출력 투영을 곱해 위치 i 의 잔차 스트림에 더한다. 엘하지와 동료들은 이 계산에서 행렬 넷이 두 묶음으로만 쓰인다는 점을 짚었다.
점수에는 쿼리 행렬과 키 행렬이 W_Qᵀ W_K 라는 곱으로만 나오고, 옮기는 양에는 값 행렬과 출력 행렬이 W_O W_V 라는 곱으로만 나온다. 그래서 헤드 하나를 「어디를 볼지」를 정하는 QK 회로와 「본 위치에서 무엇을 옮길지」를 정하는 OV 회로로 나눠 따로 읽을 수 있다. QK 회로는 지금 토큰과 앞 토큰을 보고 점수를 매기는 표이고, OV 회로는 앞 토큰을 보았을 때 다음 토큰의 로짓 가운데 무엇을 올릴지 정하는 표다.
1층 모델: 바이그램과 건너뛴 세 토큰
층이 하나뿐이면 헤드가 읽는 잔차 스트림에는 토큰 임베딩과 위치 임베딩밖에 없다. 그러면 QK 회로는 「지금 토큰 B 가 앞의 토큰 A 를 얼마나 볼지」를 토큰 둘로만 정하고, OV 회로는 「A 를 보면 다음 토큰 C 의 로짓을 얼마나 올릴지」를 토큰 둘로만 정한다. 엘하지와 동료들은 1층 모델이 바이그램에 「A … B 다음에는 C」 형태의 규칙을 잔뜩 더한 것과 같다고 보이고, 이 형태를 건너뛴 세 토큰(skip-trigram)이라 불렀다. 그들이 가중치에서 읽어 낸 예로는 LaTeX 글을 읽은 모델의 「앞에 lambda 가 나왔고 지금 토큰이 $ 이면 다음에는 람다(λ)를 적는 LaTeX 명령」이 있었고, 그런 규칙 가운데에는 앞에 나온 토큰 A 를 그대로 C 로 올리는 베껴 쓰기가 아주 흔했다.
우리 어텐션 전용 1층 모델(타이니스토리즈, 10,000 스텝)도 베껴 쓰기를 한다. 「Seoyeon」이 두 번 나오는 이야기에서, 두 번째 「␣S」 다음에 「e」가 올 확률은 0.1517 로 첫 번째 「␣S」 다음의 0.0041 보다 37배 크다. 앞에 나온 「e」를 보고 「e」를 올리는 건너뛴 세 토큰이 걸린 것인데, 그다음 「oy」는 0.0001 로 거의 맞히지 못한다.
어텐션 전용 1층 마지막: 첫 번째 0.0038 0.0041 0.0000 0.0009 0.0000 || 두 번째 0.0260 0.1517 0.0001 0.0003 0.0001
어텐션 전용 2층 마지막: 첫 번째 0.0027 0.0014 0.0001 0.0020 0.0001 || 두 번째 0.2775 0.8641 0.0003 0.0043 0.0017
(칸은 ␣S e oy e on 각 토큰에 준 확률이다.) 원 논문은 OV 회로 행렬의 고윳값으로 베껴 쓰는 헤드를 가려냈는데, 우리 모델에서는 그 점수가 아래의 지우기 실험과 맞지 않아(분명히 베끼는 헤드가 음수로 나왔다) 쓰지 않는다. 입출력 임베딩 공유처럼 원 논문과 다른 구조가 원인일 수 있지만 확인하지는 못했다.
문제 3. 1층 모델은 「e」는 베끼는데 왜 「oy」는 못 베끼나
어텐션 전용 1층 모델은 두 번째 「Seoyeon」에서 「␣S 다음 e」에 0.1517, 「e 다음 oy」에 0.0001 을 주었다. 1층 헤드의 QK 회로는 지금 토큰과 앞 위치의 토큰(그리고 위치)만 보고 점수를 매긴다. (가) 두 번째 「␣S」 위치에서 「e」를 올리려면 헤드는 어느 위치를 보고 무엇을 옮기면 되는가? (나) 두 번째 「e」 위치에서 「oy」를 올리려면 어느 위치를 봐야 하는가? 1층 헤드의 QK 회로가 그 위치를 고를 수 있는가? (다) 「oy」를 맞히려면 그 위치의 잔차 스트림에 무엇이 적혀 있어야 하는가?

(가)는 쉬워. 앞에 나온 「e」 위치를 보고 「e」를 옮기면 돼. 이야기에 「e」가 들어간 토큰이 몇 개 없으니까 「␣S 다음에 이 이야기에 나온 e 를 올려라」 같은 건너뛴 세 토큰이면 되고.

(나)는 첫 번째 「oy」 위치를 봐야겠지. 첫 번째 「oy」는 첫 번째 「e」 바로 다음에 있으니까… 지금 토큰이 「e」니까, 「e」 다음에 왔던 위치를 찾으면 돼.
1층 헤드의 QK 회로가 아는 건 지금 토큰 「e」와, 후보 위치 각각의 토큰이에요. 첫 번째 「oy」 위치의 토큰은 뭐죠?
「oy」요. 그런데 QK 회로는 「e 가 oy 를 얼마나 볼지」만 정할 수 있어요. 「바로 앞이 e 였던 위치」라는 건 그 위치의 토큰에는 안 적혀 있으니까… 아, 그 위치에서는 자기 앞 토큰이 뭐였는지 모르는구나.
그럼 「e 는 oy 를 봐라」를 따로 배우면? 그건 Seoyeon 한테만 맞는 규칙이라, 이름마다 다른 규칙을 다 외워야 하잖아. 처음 보는 이름이면 소용없고.
그래서 (다)는 첫 번째 「oy」 위치의 잔차 스트림에 「내 앞 토큰은 e 였다」가 적혀 있어야 해. 그걸 적어 줄 수 있는 건 앞 층의 헤드뿐이고. 문제 2의 64개 항이 이거였네.

그래요. 그런데 2층 모델 출력을 보면 「oy」를 0.0003 으로 여전히 못 맞혀요. 층이 둘 있다고 그 회로가 저절로 생기는 건 아닌 거죠. 그 이야기를 다음 절에서 해요.
문제 4. 헤드 하나의 QK 회로는 얼마나 많은 걸 구별할 수 있나
우리 어텐션 전용 모델은 폭 d = 256, 헤드 8개라 헤드 하나의 폭은 32 이고, W_Q 와 W_K 는 각각 256 차원 잔차 스트림을 32 차원으로 줄이는 행렬이다. (가) W_Qᵀ W_K 는 몇 × 몇 행렬인가? (나) 이 행렬의 랭크(서로 독립인 행이나 열의 최대 개수)는 최대 얼마인가? (다) 헤드 하나가 잔차 스트림의 256 개 방향 가운데 「어디를 볼지」를 정하는 데 쓸 수 있는 방향은 최대 몇 개라고 볼 수 있나? 헤드를 8개로 나눈 이유와 연결해 말해 보라.
(가)는 256 차원을 32 로 줄였다가 다시 내적하니까 256 × 256 이야.
(나)는 32 차원을 거쳐 가니까 랭크가 32 를 넘을 수 없어. 256 × 256 행렬이지만 독립인 방향은 많아야 32 개.
그럼 (다)는요?
헤드 하나가 점수를 매길 때 잔차 스트림의 256 개 방향 가운데 많아야 32 개의 방향만 쓸 수 있어요. 한 헤드가 모든 걸 다 보지는 못하니까, 여러 헤드가 서로 다른 방향을 나눠 보는 거고요.
헤드 8개면 8 × 32 = 256 이라 합치면 폭이 꽉 차네. 각자 다른 걸 보라고 쪼개 놓은 거구나.
OV 회로 W_O W_V 도 같은 이유로 랭크가 32 를 넘지 않아요. 헤드 하나가 잔차 스트림에 옮겨 적을 수 있는 것도 32 개 방향 안이고요.