상전이: 웹 글을 읽힌 루나에게 유도 헤드가 갑자기 생기다
민준은 라운지 노트북에서 자기 게이밍 GPU 에 접속해, nanochat 이 받아 둔 웹 글 조각을 같은 크기의 어텐션 전용 모델에 읽히기로 했다. 동화가 아닌 글을 읽은 2층 모델에는 유도 헤드가 생길까? 생긴다면 동화에서처럼 천천히 자랄까, 아니면 올슨과 동료들이 본 것처럼 어느 구간에서 갑자기 뛸까?
웹 글은 ClimbMix 를 썼다. ClimbMix 는 엔비디아가 공개한 웹 글 묶음으로 원본은 4,000억 토큰이고, 원본 라이선스는 비상업 이용만 허락하는 CC BY-NC 4.0 이다(https://huggingface.co/datasets/nvidia/Nemotron-ClimbMix). 이 책은 무료로 공개하므로 비상업 조건 안에서 쓰고, 원문은 싣지 않는다. 우리가 쓴 것은 그 가운데 문서 340,992 개, 학습 토큰 257,658,232 개로, 이 글로 따로 학습한 어휘 8,192 개의 BPE 로 잘랐다(sources/circuits/prepare_web.py, CPU 381.5초). 원본의 0.06% 정도다(2억 5,766만 ÷ 4,000억). 모델은 같은 코드에 어휘만 8,192 개로 바꾼 어텐션 전용 1층·2층이고, 30,000 스텝(2억 4,576만 토큰)을 학습했다.
3,360만 토큰과 5,570만 토큰 사이
[2층] 최고 유도 점수가 가장 가파르게 오른 구간: 스텝 4600 -> 4700 (0.260 -> 0.314) | 처음 0.1 이상: 스텝 4100 (토큰 33.6M) | 처음 0.3 이상: 스텝 4700 (토큰 38.5M) | 처음 0.5 이상: 스텝 6800 (토큰 55.7M)
    스텝    토큰(M) | 2층: 손실 유도 반복2 자연1 자연2
  3000     24.6 |  4.822 0.016 12.483 4.960 4.739
  5000     41.0 |  4.493 0.378  9.811 4.650 3.240
 30000    245.8 |  4.065 0.546  5.538 4.217 2.073
(「유도」는 헤드 가운데 가장 높은 유도 점수, 「반복2」는 무작위 반복 글의 두 번째 절반 손실, 「자연1」「자연2」는 검증 글 100 토큰을 두 번 이은 글의 처음·두 번째 절반 손실이다.) 2,460만 토큰까지 0.016 이던 최고 유도 점수가 3,360만 토큰에서 처음 0.1 을 넘었고, 3,850만 토큰에서 0.3, 5,570만 토큰에서 0.5 를 넘었다. 같은 구간에 무작위 반복 글의 두 번째 절반 손실은 12.483 에서 9.811 로 떨어지기 시작해 끝에는 5.538 이 되었다. 실제 웹 글 100 토큰을 두 번 이은 글에서도 두 번째 절반 손실이 4.217 에서 2.073 으로 절반이 되었다. 1층 모델은 30,000 스텝 내내 최고 유도 점수가 0.013 이었다.
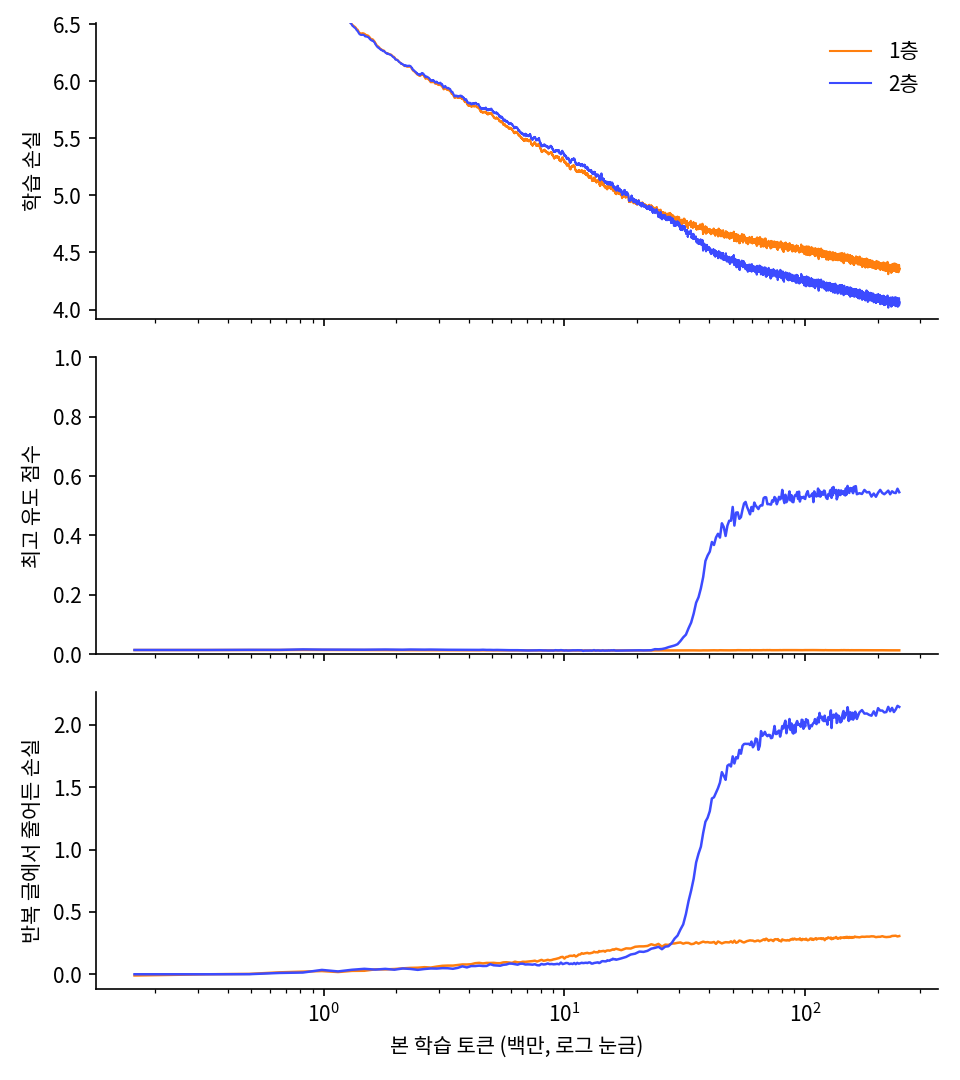
동화에서 4억 9,150만 토큰을 읽혀도 생기지 않던 유도 헤드가, 같은 크기의 모델에 웹 글을 읽히자 3,000만~5,000만 토큰 사이에서 갑자기 생겼다. 이렇게 학습이 쌓이는 동안 모델의 성질이 좁은 구간에서 갑자기 바뀌는 것을 상전이(phase change)라 부른다. 원 논문의 설정에서는 수십억 토큰 언저리였으니 우리 작은 설정에서는 훨씬 이르지만, 모델 크기와 데이터가 달라 두 숫자를 바로 비교할 수는 없다.

그로킹이랑 닮았는데 같지는 않네. 그로킹은 다 외운 다음 한참 뒤에 규칙이 생겼는데, 여기선 손실이 아직 한창 내려가는 중에 생겼어.
됐다. 앞에서 본 걸 베껴. 옛 루나도 어제 한 말을 기억했어.
민준이 처음 서연에게 루나를 소개하던 날, 최적화 강의를 듣던 학기의 어느 오후 라운지에서 했던 말이었다. 그때 루나는 민준이 전날 시험 걱정을 했다는 것을 기억해 물었고, 민준은 「안에서 뭐가 돌아가는지 진짜 궁금해」라고 했다.
지우기 실험과 꺾인 손실 곡선
유도 점수는 헤드가 어디를 보는지만 재므로, 그 헤드가 정말 베끼는 일을 하는지는 헤드를 없애 보면 알 수 있다. 헤드 하나의 출력을 0 으로 바꾸고 나머지는 그대로 둔 채 손실이 얼마나 오르는지 재는 것을 지우기 실험(ablation)이라 한다. 웹 글 2층 모델의 헤드 열여섯 개를 하나씩 지우고 무작위 반복 글의 두 번째 절반 손실(지우기 전 5.538)이 오른 양을 쟀다.
2-2. 지우기 실험: 헤드 하나를 지우면 무작위 반복 글 두 번째 절반 손실이 얼마나 오르나 (행 = 층, 열 = 헤드)
[attn_only_web_L2] 지우기 전 두 번째 절반 손실 5.538
  층 1: +7.15 +3.27 -0.31 +1.39 +0.71 +1.57 +0.66 -0.27
  층 2: +2.58 +4.37 -0.03 +0.01 +0.01 +0.01 +0.63 +1.14
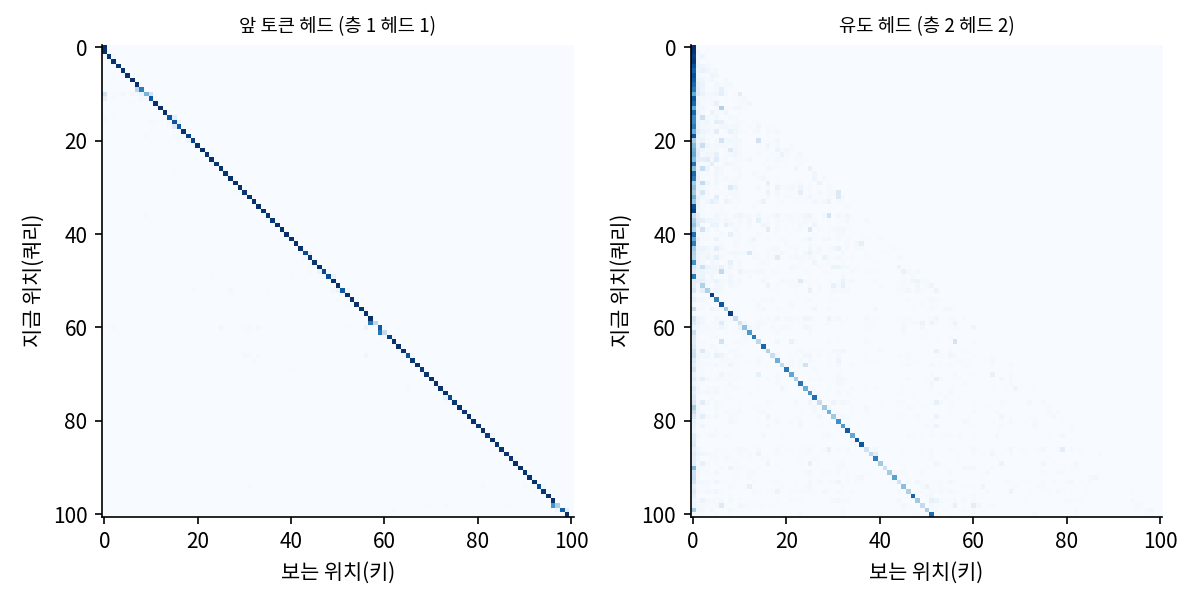
층 2 헤드 2 는 유도 점수가 0.546 으로 가장 높은 헤드이고, 지우면 손실이 4.37 오른다. 층 1 헤드 1 은 바로 앞 위치에 가중치 0.961 을 주는 앞 토큰 헤드인데, 지우면 손실이 7.15 나 오른다. 서로 다른 층의 두 헤드가 모두 빠질 수 없으니, 유도 헤드는 앞 토큰 헤드가 적어 둔 것을 읽어 일한다는 합성의 증거다. 마지막 층에서 헤드마다 정답 토큰의 로짓에 보탠 양도 헤드 1 이 +3.26, 헤드 2 가 +4.70 으로, 모든 토큰에 평균적으로 보탠 양(+0.69, +0.40)보다 훨씬 컸다.
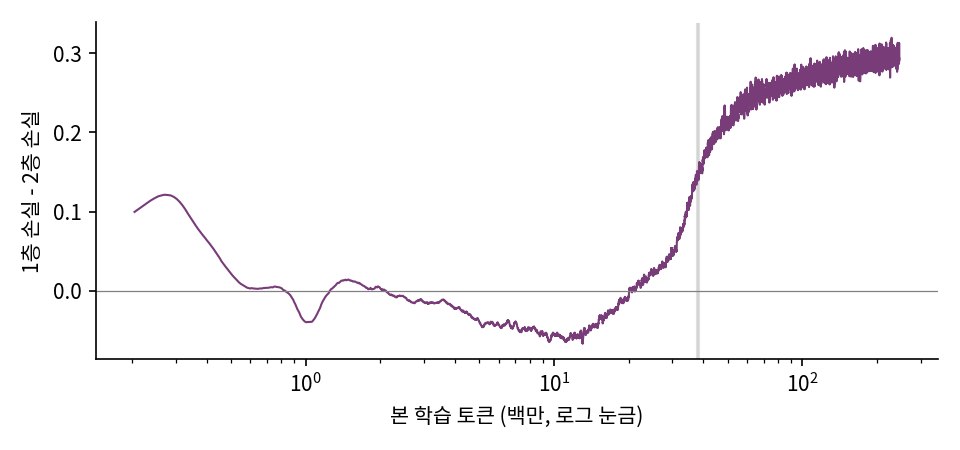
원 논문 그림처럼 손실 곡선에 혹이 솟는 일은 우리 곡선에서는 보이지 않았다. 대신 2층 곡선이 3,000만~5,000만 토큰 구간에서 갑자기 더 가파르게 내려가 1층 곡선을 앞질렀다. 같은 스텝의 「1층 손실 − 2층 손실」을 보면 꺾임이 드러난다.
1층 손실 - 2층 손실 (학습 손실 25 스텝 평균, 그 토큰 수에 가장 가까운 스텝): 1M -0.039, 5M -0.038, 10M -0.054, 20M -0.006, 30M +0.047, 40M +0.163, 50M +0.216, 100M +0.267, 200M +0.296
문제 7. 앞 토큰 헤드를 지우면 왜 유도 헤드보다 더 크게 나빠지나
웹 글 2층 모델에서 헤드를 하나씩 지웠을 때 무작위 반복 글 두 번째 절반 손실(지우기 전 5.538)이 오른 양은 층 1 헤드 1(앞 토큰 점수 0.961) +7.15, 층 2 헤드 2(유도 점수 0.546) +4.37, 층 2 헤드 1(유도 점수 0.423) +2.58 이었다. (가) 층 2 의 두 헤드를 각각 지운 값의 합은 얼마이고, 층 1 헤드 1 을 지운 값과 비교하면 어떤가? (나) 그 비교에서 층 1 헤드 1 과 층 2 의 두 헤드 사이의 관계를 짐작하라. (다) 두 헤드를 각각 지운 값을 더해 「둘 다 지운 값」을 짐작하는 것은 왜 위험한가?

일단 더해 보면 4.37 + 2.58 = 6.95. 층 1 헤드 1 하나를 지운 7.15 랑 거의 같아.
신기하다. 유도 헤드가 둘인데, 둘 다 층 1 헤드 1 이 적어 둔 「내 앞 토큰」을 읽는다면, 층 1 헤드 1 하나를 지우는 건 두 유도 헤드의 눈을 한꺼번에 가리는 거네.

그렇게 보면 7.15 와 6.95 가 비슷한 것도 이해가 되죠. 그런데 (다)는요?
음, 손실은 정답 확률의 −ln 이라서 더해지는 양이 아니야. 유도 헤드 하나가 남아 있으면 그 헤드가 반은 베껴 줄 수 있으니까, 하나씩 지운 값은 「다른 하나가 메워 준 뒤에 남은 손해」고.
둘 다 지우면 메워 줄 헤드가 없으니까 합보다 클 수도 있겠다. 그리고 7.15 랑 6.95 가 비슷한 게 우연일 수도 있고. 둘 다 지운 실험을 직접 돌려 봐야 알겠네.
맞아요. 우리는 그 실험까지는 돌리지 않았으니, 「층 1 헤드 1 을 지우면 두 유도 헤드를 지운 것만큼 나빠진다」는 짐작까지만 할 수 있어요. 지우기 실험에서 헤드끼리의 관계를 말하려면 짝지어 지운 실험이 따로 필요해요.
문제 8. 유도 헤드가 생기기 전에는 왜 2층이 1층보다 나빴나
웹 글에서 「1층 손실 − 2층 손실」은 1M −0.039, 10M −0.054, 20M −0.006 으로 음수였다가 30M +0.047, 50M +0.216, 200M +0.296 이 되었다. 2층 모델은 1층 모델의 헤드 8개를 모두 갖고도 헤드 8개가 더 있다. (가) 2층 모델이 첫째 층만 쓰고 둘째 층의 출력을 0 으로 두면 1층 모델과 같은 계산을 할 수 있다. 그런데도 2,000만 토큰까지 2층이 조금 나빴던 이유를 짐작해 보라. (나) 원 논문은 이 구간에서 손실이 위로 솟는 혹을 보았고, 우리는 2층 곡선이 꺾이며 앞지르는 것만 보았다. 「혹이 없었다」를 「상전이가 없었다」로 읽어도 되는가? (다) 유도 헤드가 학습 손실을 얼마나 줄였는지 「1층 손실 − 2층 손실」로 짐작한다면?
(가)는 「할 수 있다」와 「그렇게 학습된다」가 다르다는 거겠지. 처음에는 둘째 층도 무작위 값이라 쓸데없는 걸 잔차 스트림에 더하고, 그걸 줄이는 데도 학습이 필요하니까.
파라미터가 더 많으면 처음엔 오히려 느린 것도 흔하잖아. 다만 이 모델에서 진짜 그런지는 둘째 층 출력 크기를 재 봐야 알 거고.
짐작으로 두죠. (나)는요?
음, 혹이 없으니 상전이가 없었다고 하면 안 될 것 같아요. 유도 점수랑 반복 글 손실은 3,000만~5,000만 토큰에서 같이 뛰었으니까요. 학습 손실 전체로 보면 반복해서 베낄 자리가 일부라서 꺾임으로만 보인 거고요.
그럼 (다)는 꺾이기 직전 20M 의 −0.006 에서 200M 의 +0.296 까지니까, 2층이 1층보다 0.3 nats 쯤 더 줄었어. 그중 얼마가 유도 헤드 덕인지는 손실 차이만으로는 못 나눠. 둘째 층의 다른 헤드들도 같이 학습되니까.
그래요. 원 논문이 본 혹을 우리는 보지 못했고, 대신 함께 뛴 세 줄과 지우기 실험을 보았어요. 책에도 「혹」이 아니라 「꺾임」이라고 적어 둘게요.