학습 목표 속의 온도: 보상과 nat의 환율
softmax의 τ는 이미 학습된 분포에서 샘플을 뽑을 때 쓰인다. 그런데 강화학습의 SAC에는 α가, RLHF에는 β가 학습 목표 안에 들어 있고, 논문들은 이것들도 온도라고 부른다. 샘플이 아니라 학습되는 매개변수를 움직이는 이 계수들도 같은 환율일까?
SAC의 α
강화학습에서 보상만 최대화하도록 정책을 학습하면, 조금 더 나아 보이는 행동 하나에 확률이 금방 몰려 다른 행동은 거의 해 보지 않게 된다. 그러면 더 좋은 길이 있어도 끝내 찾지 못할 수 있다. 이것저것 해 보는 일에도 값을 매겨 줄 수는 없을까? 강화학습의 SAC(Haarnoja 외 2018)는 보상만 최대화하지 않고, 보상과 정책의 엔트로피를 함께 최대화한다. 여기서 α가 움직이는 것은 정책을 정하는 학습되는 매개변수다.
여기서 α는 논문에서도 temperature라고 부르는데, 식을 보면 그 이유를 알 수 있다. α는 "엔트로피 1 nat은 보상 α만큼의 가치가 있다"는 환율이기 때문이다. 상태가 하나뿐이고 행동이 셋, 보상이 (2, 1, 0)인 가장 작은 경우로 확인해 보자. α = 1이면 목표값은 기대 보상에 엔트로피를 더한 값이다.
| 정책 (세 행동의 확률) | 기대 보상 | 엔트로피 (nat) | 목표값 (α = 1) |
|---|---|---|---|
| 1, 0, 0 (늘 첫 행동) | 2 | 0 | 2 |
| 1/3, 1/3, 1/3 (고르게) | 1 | 1.10 | 2.10 |
| 0.665, 0.245, 0.090 | 1.58 | 0.83 | 2.41 |
보상만 보면 늘 첫 행동을 고르는 정책이 가장 좋지만, 엔트로피를 1 nat당 보상 1로 쳐 주면 셋째 줄이 가장 좋다. 정책을 촘촘히 바꿔 가며 찾아보면 이 셋째 줄이 가장 큰 목표값을 내는 정책이고, 로짓 (2, 1, 0)을 온도 1로 softmax한 확률과 같다. α를 0.5와 2로 바꿔 같은 방법으로 찾으면 가장 좋은 정책은 (0.867, 0.117, 0.016)과 (0.506, 0.307, 0.186)이 되어, softmax 표에서 τ가 서던 자리에 α가 선다. 그러므로 α가 크면 이것저것 해 보는 탐색을 중시하고, α가 작으면 보상을 우선한다.
RLHF의 β
LLM의 RLHF에서도 같은 구조가 나타난다. 보상 모델도 사람의 선호를 흉내 내도록 학습한 모델이라 허점이 있어서, 보상만 좇으면 학습하는 모델이 그 허점을 파고드는 이상한 답으로 흘러갈 수 있다. 그래서 RLHF는 보상을 높이되, 학습하는 모델이 기준 모델에서 너무 멀어지지 않게 한다. 얼마나 멀어졌는지는 두 분포가 얼마나 다른지를 0 이상의 수 하나로 재는 KL 발산(Kullback–Leibler divergence)으로 잰다. 식에서는 D_KL로 쓴다.
이때 β는 "기준 모델에서 1 nat 멀어지는 데 보상 β를 낸다"는 환율로 읽을 수 있다. 다시 말해 β의 단위는 보상/nat이다. 이 글자는 RLHF 논문들의 기호를 그대로 따른 것이라, 이 장 앞에서 역온도로 쓴 β와 글자만 같고 서는 자리는 역온도가 아니라 온도(kT) 쪽이다. 여기서도 β가 움직이는 것은 학습되는 매개변수다. 그렇다면 보상 모델을 바꾸어 보상의 크기가 달라지면 β는 어떻게 해야 할까? 이 절 끝의 문제에서 따져 보자.
시뮬레이티드 어닐링
마지막은 최적화를 위해 일부러 만든 물리계가 움직이는 경우다. 가장 낮은 비용만 좇아 내리막으로만 가는 탐색은 가장 가까운 골짜기에 빠지면 더 깊은 골짜기가 옆에 있어도 빠져나오지 못한다. 대장간에서는 금속을 달군 뒤 천천히 식혀서 단단하고 고른 결정을 얻는데, 이것을 풀림(annealing)이라 한다. Kirkpatrick, Gelatt, Vecchi(1983)는 이 과정을 최적화에 옮겨 와서, 최적화 문제의 비용 함수를 에너지로 보고 온도를 높게 시작해 천천히 낮추는 탐색법을 제안했다. 온도가 높을 때는 비용이 조금 나빠지는 이동도 받아들이므로 국소 최솟값을 빠져나올 수 있고, 온도가 낮아지면 좋은 계곡에 자리 잡게 된다. 이 방법은 외판원 문제나 칩 위에 회로 소자의 자리를 정하는 문제 같은 잘 알려진 탐색 문제에 오랫동안 쓰였다.
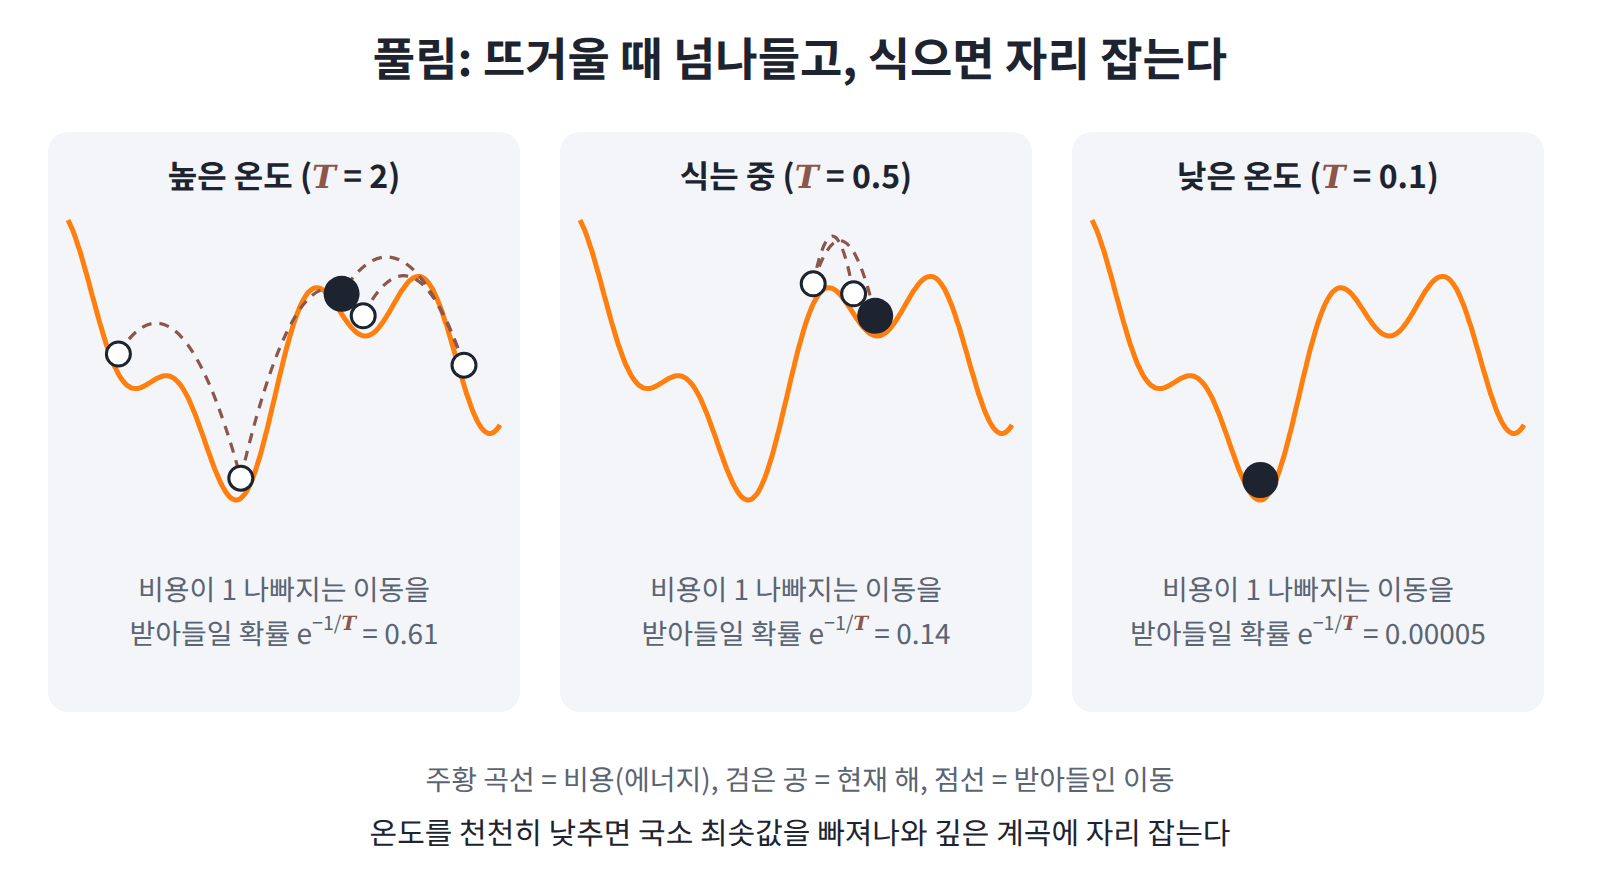
한 그림으로: 온도는 환율이다
ML에서 "온도"라는 이름이 붙은 계수나 그 역수는 겉모습은 제각각이어도 대부분 같은 역할을 한다. 바로 에너지처럼 쓰이는 양(로짓, 보상, 손실)과 엔트로피(nat) 사이의 환율을 정하는 것이다. softmax의 τ는 샘플을, SAC의 α와 RLHF의 β는 학습되는 매개변수를, 어닐링의 T는 일부러 만든 물리계를 움직이지만, 역할은 물리의 kT와 같다.
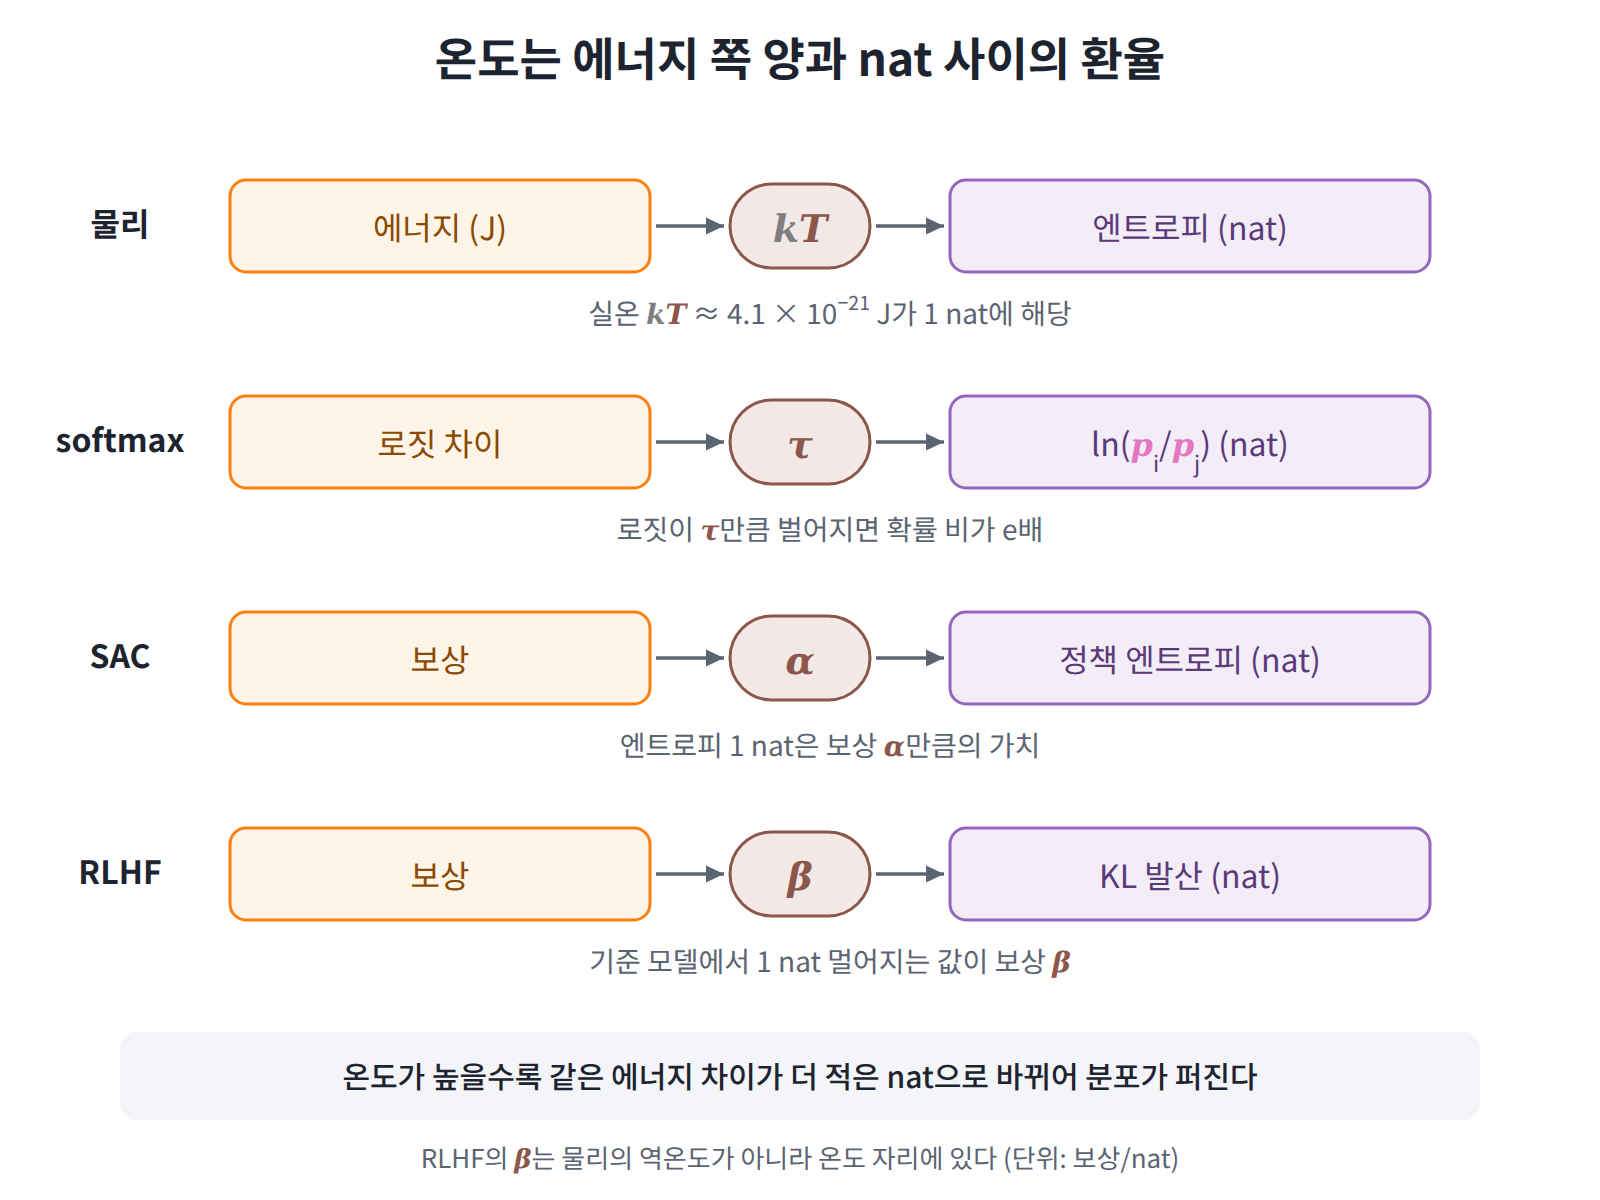
부호 하나
물리와 ML 사이를 오갈 때 주의할 점이 하나 있다. 물리에서는 에너지가 낮을수록 선호되지만, ML에서는 로짓과 보상이 높을수록 선호된다. 그러므로 두 세계의 식을 옮겨 적을 때는 에너지 = −로짓, 에너지 = −보상으로 부호를 뒤집어야 한다. 다만 온도는 양쪽 모두 양수다.
문제 12. 나들이 장소와 이동 시간의 단위
민준이 주말 나들이 장소를 「점수 = 만족도 − β × 이동 시간」으로 고른다. 이동 시간을 분으로 잴 때 β = 0.1로 정했다. A는 만족도 10에 이동 60분, B는 만족도 7에 이동 20분이다. (가) 어디를 고르는가? (나) 친구가 이동 시간을 시간 단위(A는 1시간, B는 1/3시간)로 바꿔 적고 β = 0.1은 그대로 두었다. 어디를 고르게 되는가? (다) 시간 단위로 적고도 (가)와 같은 선택이 나오려면 β를 얼마로 해야 하는가?
(가)는 A가 10 − 6 = 4, B가 7 − 2 = 5니까 B요.
(나)는 A가 10 − 0.1 = 9.9, B가 7 − 0.033 ≈ 6.97이라 A네요. 어? 단위만 바꿔 적었는데 고르는 곳이 바뀌었어요. 시간으로 재는 게 더 정확한 건가?
β = 0.1은 무엇 1단위에 몇 점을 깎는 값이었죠?
이동 1분에 0.1점이요. 아, 1시간은 60분이니까 시간 단위로는 β가 6이어야 해요. 그러면 A는 10 − 6 = 4, B는 7 − 2 = 5로 다시 B예요.
β는 이동 시간 1단위를 점수 몇 점으로 쳐 주는지 정하는 환율이었네. 재는 단위를 바꾸면 환율도 같이 바꿔야 하고.
문제 13. 보상이 10배가 된 보상 모델
기준 모델이 세 응답에 확률 1/3씩을 고르게 주고, 보상 모델이 매긴 보상은 r = (1, 0.5, 0)이다. RLHF의 목표 𝔼[r] − β D_KL(π ‖ π_ref)에 β = 0.5를 넣고, 두 정책 P₁ = (0.665, 0.245, 0.090)과 P₂ = (0.98, 0.01, 0.01)의 목표값을 견주라. 보상 모델을 새로 학습했더니 보상이 모두 10배가 되었다. β = 0.5 그대로라면 어느 정책이 나은가? 예전과 같은 선택이 나오려면 β를 얼마로 해야 하는가?
기대 보상은 P₁이 0.665 + 0.1225 ≈ 0.788, P₂가 0.98 + 0.005 = 0.985예요. 기준 모델이 고르니까 KL은 ln 3에서 엔트로피를 빼면 되고, P₁이 0.266, P₂가 0.987이에요. β = 0.5면 P₁은 0.788 − 0.133 ≈ 0.654, P₂는 0.985 − 0.493 ≈ 0.492라서 P₁이 나아요.

보상이 10배면 기대 보상만 10배니까 P₁은 7.876 − 0.133 ≈ 7.74, P₂는 9.85 − 0.493 ≈ 9.36. 이번에는 첫 응답에 거의 다 몰린 P₂가 이기네요.
이상해요. 세 응답의 순서도, 보상끼리의 비율도 그대로인데 학습 결과가 달라진다고요?
10배 한 목표에서 10을 앞으로 묶어 내 보면 어떤 꼴이 되죠?
10(𝔼[r] − 0.05 D_KL)이에요. 보상을 10배 한 건 β를 10분의 1로 줄인 것과 같네요. KL 벌점이 약해지니까 기준 모델에서 멀리 간 P₂가 이긴 거고요. 같은 선택이 나오려면 β도 10배, 곧 5로 해야 해요.
β = 5면 P₁은 7.876 − 1.33 ≈ 6.54, P₂는 9.85 − 4.93 ≈ 4.92라서 다시 P₁이에요. 나들이 문제에서 시간 단위를 바꾸면 β도 바꿔야 했던 거랑 같네요. β의 단위가 보상/nat이니까요.

맞아요. SAC를 낸 논문도 같은 일을 보고했어요. 보상의 크기를 키우면 정책이 거의 한 행동에 몰려 탐색이 모자라고, 줄이면 정책이 거의 고르게 퍼져 보상을 제대로 쓰지 못한다고요. 그래서 그 논문은 보상의 크기를 온도의 역수로 읽고 환경마다 맞춰 골랐어요.